Scripts locales
PDF a Markdown con Python
Actualizado el · Equipo de pdftomd.tools
Pasar un PDF a Markdown con Python es cuestión de un script en tu propio equipo. Esta guía muestra fragmentos probados para dos bibliotecas de código abierto y una herramienta en el navegador para los días en que prefieres no instalar nada.
¿No tienes Python a mano? La herramienta de abajo hace la misma conversión de PDF a Markdown sin instalar nada. Suelta un archivo con capa de texto y copia el resultado.
PDF de origen
Suelta un PDF aquí o haz clic para elegirlo
Solo PDF con texto. Los escaneos necesitarían OCR, y esta herramienta no lo hace.
Vista previa del Markdown
Aquí aparecerá el Markdown.
PDF a Markdown con Python: preparación en cuatro pasos
Un flujo local, de la instalación a los archivos de salida.
 01
Crea el entorno
Crea un entorno virtual con python -m venv .venv y actívalo, para que las bibliotecas no acaben en la instalación del sistema.
Ver los fragmentos 02
Instala una biblioteca
Ejecuta pip install pymupdf4llm para una salida Markdown general, o pip install pdfplumber si lo que más importa son las tablas.
Elegir biblioteca 03
Ejecuta el script
Copia un fragmento de esta página en un archivo .py y apúntalo a tu documento. Cada ejecución escribe un archivo .md que puedes abrir.
Copiar un fragmento 04
Revisa la salida
Compara el archivo .md con el original y quita encabezados y pies sueltos antes de procesar el texto en otro sitio.
Comparar en el navegador
¿Qué biblioteca de Python usar para pasar de PDF a Markdown?
No existe una única mejor biblioteca para pasar un PDF a Markdown con Python; cada una equilibra de forma distinta velocidad, licencia y tablas. pymupdf4llm se basa en PyMuPDF, lee el diseño y escribe Markdown directamente, títulos y tablas con líneas incluidos. Eso la convierte en una opción por defecto sensata para notas y recuperación. pdfplumber da un acceso más fino a caracteres, líneas y celdas, así que encaja con scripts centrados en datos de tablas.
Ambos son proyectos de código abierto de terceros, no productos de este sitio. Para unos pocos documentos, la herramienta web de esta página hace una pasada parecida sin instalar nada. Para cientos de archivos con programación periódica, un script local de Python es mejor opción.
- pymupdf4llm: de PDF a Markdown con una sola llamada
- pdfplumber: acceso preciso a las celdas de tablas con líneas
- Herramienta web: sin instalación, sin subida
Límites que comparten todos los enfoques
Ninguna de estas opciones lee escaneos por sí sola: la herramienta web no tiene OCR, y las bibliotecas de arriba necesitan un paso de OCR aparte para las páginas que son solo imagen. Las celdas combinadas, las tablas giradas y los diseños a dos columnas son difíciles para cualquier biblioteca de Python y para nuestra herramienta, así que revisa las tablas a mano. En la herramienta web, las tablas sin bordes necesitan al menos tres filas y la primera fila siempre pasa a ser el encabezado.
Fragmentos de Python para pasar un PDF a Markdown
Probados con pymupdf4llm 1.28 y pdfplumber 0.11. Copia uno y ejecútalo en local.
Un archivo con pymupdf4llm
Terceros · AGPLRápido y atento al diseño: la salida conserva títulos y tablas con líneas. PyMuPDF tiene licencia AGPL; revisa las condiciones antes de incluirlo en un producto cerrado.
# pip install pymupdf4llm
import pathlib
import pymupdf4llm

md = pymupdf4llm.to_markdown("report.pdf")
pathlib.Path("report.md").write_text(md, encoding="utf-8")
Tablas con pdfplumber
Terceros · MITLo mejor para tablas con líneas. Por defecto solo encuentra tablas con líneas dibujadas; las cuadrículas sin bordes necesitan ajustes propios. La función auxiliar escribe cada tabla como tabla con barras.
# pip install pdfplumber
import pdfplumber

def table_to_md(rows):
    rows = [[(c or "").replace("|", "\\|").strip() for c in r] for r in rows]
    head, body = rows[0], rows[1:]
    lines = ["| " + " | ".join(head) + " |", "|" + " --- |" * len(head)]
    lines += ["| " + " | ".join(r) + " |" for r in body]
    return "\n".join(lines)

with pdfplumber.open("invoice.pdf") as pdf:
    for page in pdf.pages:
        for table in page.extract_tables():
            print(table_to_md(table), end="\n\n")
Una carpeta entera con pymupdf4llm
Terceros · AGPLUn bucle: lee cada archivo de la carpeta pdfs y escribe un archivo .md por cada entrada.
# pip install pymupdf4llm
import pathlib
import pymupdf4llm

out = pathlib.Path("markdown")
out.mkdir(exist_ok=True)
for pdf in sorted(pathlib.Path("pdfs").glob("*.pdf")):
    md = pymupdf4llm.to_markdown(str(pdf))
    (out / f"{pdf.stem}.md").write_text(md, encoding="utf-8")
    print("wrote", out / f"{pdf.stem}.md")
Dónde encaja un script de Python
Tres tareas en las que merece la pena programar.
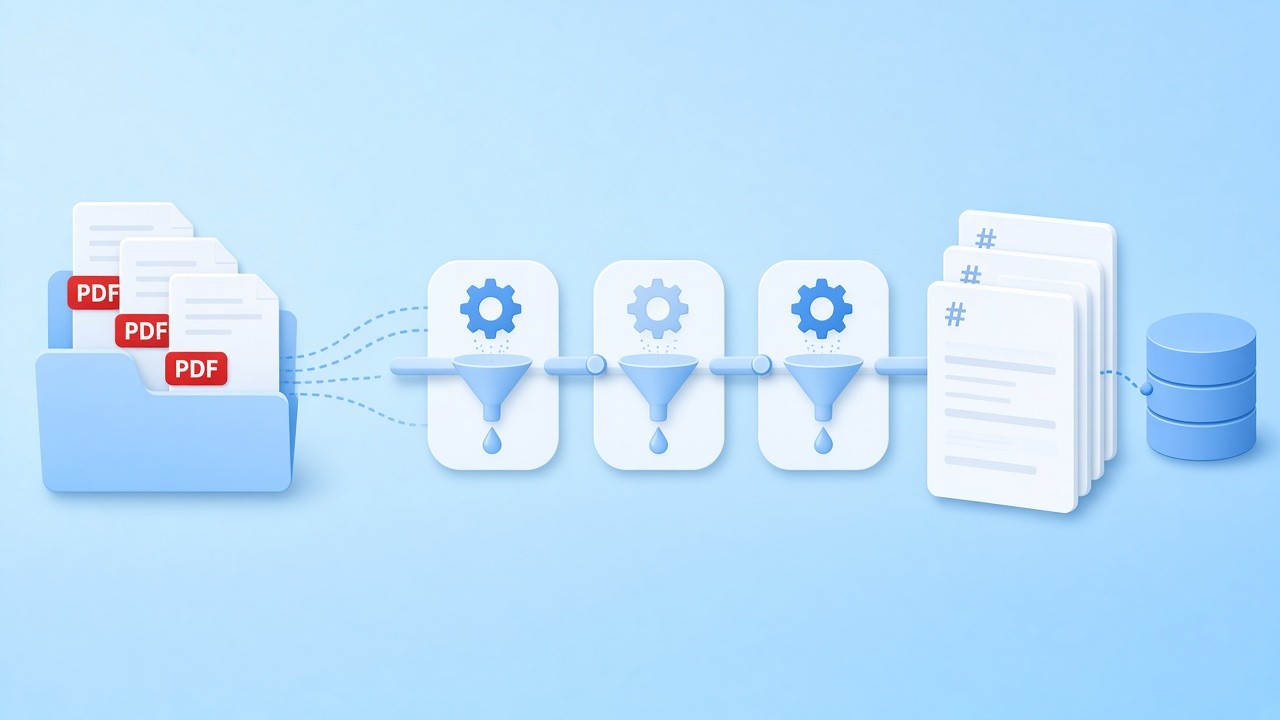
Pipelines de recuperación
Antes de indexar, ejecuta un script que pase cada PDF a Markdown, divide la salida por los títulos y guarda cada sección.
Leer la guía de LLM
Análisis en un notebook
Extrae tablas con pdfplumber en un notebook, compara las filas con el original y guarda la salida junto a tu análisis.
Ver los fragmentos
Extracción de tablas
Si lo que importa son los números, la función auxiliar de arriba convierte las tablas con líneas en tablas con barras y puedes ignorar el texto corrido.
Probar la herramienta web
Script o navegador: tus archivos se quedan en local
Un script local no envía tus archivos a ningún sitio, y nuestra herramienta web tampoco: la conversión de PDF a Markdown se ejecuta con pdf.js en la página, y el archivo nunca llega a nuestros servidores.
Volver a convertir Markdown en páginas
Después de una pasada con Python quizá necesites una versión imprimible. La herramienta de enfrente convierte Markdown en páginas A4 en el navegador.
Herramientas relacionadas
Más páginas en torno a PDF a Markdown.
¿Prefieres no configurar nada? Pasa aquí tu PDF a Markdown
Suelta un documento y copia texto limpio, o ejecuta los fragmentos de arriba en tu equipo. Gratis y privado.
Convertir un archivoFuentes
- pymupdf4llm to_markdown() reference — PDF4LLM docs
- PyMuPDF (AGPL-3.0) — GitHub
- pdfplumber (MIT) — GitHub
- pdf.js — Mozilla
Preguntas frecuentes
Dudas sobre opciones de Python, licencias y límites.
¿Cuál es la forma más sencilla de pasar un PDF a Markdown con Python?
pymupdf4llm: instálala con pip y llama a to_markdown sobre un archivo. Obtienes Markdown con títulos, listas y tablas con líneas.
¿Necesito una cuenta o una clave?
No. Las bibliotecas se instalan con pip y funcionan sin conexión, y la herramienta web no pide cuenta. Para automatizar, usa una biblioteca local de Python.
¿pymupdf4llm y pdfplumber son vuestros?
No. Ambos son proyectos de código abierto de terceros. pymupdf4llm y PyMuPDF tienen licencia AGPL, y pdfplumber, MIT.
¿Un script de Python puede leer escaneos?
No por sí solo. Las páginas que son solo imagen necesitan antes un paso de OCR. Nuestra herramienta web tampoco tiene OCR y te avisa cuando un archivo parece escaneado.
¿Cómo conservo las tablas al pasar un PDF a Markdown?
pymupdf4llm escribe las tablas con líneas como tablas con barras; pdfplumber las encuentra y la función auxiliar las convierte. Las tablas sin bordes necesitan ajustes en ambos casos.
¿La herramienta web es lo mismo que estas bibliotecas?
No. Usa pdf.js y sus propias reglas de diseño, así que la salida puede variar. No necesita instalación y sirve para un puñado de archivos.
¿Un script de Python sube mis archivos?
No. Los scripts locales se ejecutan en tu equipo, y la herramienta web de esta página procesa los archivos sin subirlos.