Scripts locais
PDF para Markdown com Python
Atualizado em · Equipe pdftomd.tools
Converter PDF para Markdown com Python é coisa de um script no seu próprio computador. Este guia mostra trechos testados para duas bibliotecas de código aberto e uma ferramenta no navegador para os dias em que você prefere não instalar nada.
Sem Python à mão? A ferramenta abaixo faz a mesma conversão de PDF para Markdown, sem instalação. Solte um arquivo com camada de texto e copie o resultado.
PDF de origem
Solte um PDF aqui ou clique para escolher
Só PDFs com texto. Digitalizações precisariam de OCR, e esta ferramenta não faz OCR.
Prévia do Markdown
O Markdown vai aparecer aqui.
PDF para Markdown com Python: configuração em quatro passos
Um fluxo local, da instalação aos arquivos de saída.
 01
Crie o ambiente
Crie um ambiente virtual com python -m venv .venv e ative, para que as bibliotecas não caiam na instalação do sistema.
Ver os trechos 02
Instale uma biblioteca
Rode pip install pymupdf4llm para uma saída Markdown geral, ou pip install pdfplumber se o que mais importa são as tabelas.
Escolher biblioteca 03
Rode o script
Copie um trecho desta página para um arquivo .py e aponte para o seu documento. Cada execução grava um arquivo .md que você pode abrir.
Copiar um trecho 04
Confira a saída
Compare o arquivo .md com o original e remova cabeçalhos e rodapés perdidos antes de o texto seguir para outro lugar.
Comparar no navegador
Qual biblioteca Python usar de PDF para Markdown?
Não existe uma única melhor biblioteca para converter PDF para Markdown com Python; cada uma equilibra de um jeito velocidade, licença e tabelas. A pymupdf4llm é construída sobre o PyMuPDF, lê o layout e grava Markdown direto, incluindo títulos e tabelas com linhas. Por isso é uma escolha padrão sensata para notas e recuperação. A pdfplumber dá acesso mais fino a caracteres, linhas e células, então combina com scripts focados em dados de tabelas.
As duas são projetos de código aberto de terceiros, não produtos deste site. Para poucos documentos, a ferramenta no navegador desta página faz uma passada parecida sem instalação. Para centenas de arquivos em horários programados, um script Python local é a melhor escolha.
- pymupdf4llm: de PDF para Markdown numa chamada só
- pdfplumber: acesso preciso às células de tabelas com linhas
- Ferramenta no navegador: sem instalação, sem upload
Limites que todas as abordagens têm
Nenhuma dessas opções lê digitalizações sozinha: a ferramenta no navegador não tem OCR, e as bibliotecas acima precisam de uma etapa de OCR separada para páginas que são só imagem. Células mescladas, tabelas giradas e layouts em duas colunas são difíceis para qualquer biblioteca Python e para a nossa ferramenta, então confira as tabelas à mão. Na ferramenta no navegador, tabelas sem borda precisam de pelo menos três linhas e a primeira linha sempre vira cabeçalho.
Trechos de Python para converter PDF para Markdown
Testados com pymupdf4llm 1.28 e pdfplumber 0.11. Copie um e rode localmente.
Um arquivo com pymupdf4llm
Terceiros · AGPLRápido e atento ao layout: a saída mantém títulos e tabelas com linhas. O PyMuPDF é AGPL; confira os termos antes de incluir num produto fechado.
# pip install pymupdf4llm
import pathlib
import pymupdf4llm

md = pymupdf4llm.to_markdown("report.pdf")
pathlib.Path("report.md").write_text(md, encoding="utf-8")
Tabelas com pdfplumber
Terceiros · MITO melhor para tabelas com linhas. Por padrão só encontra tabelas com linhas desenhadas; grades sem borda precisam de ajustes próprios. A função auxiliar grava cada tabela como tabela com barras.
# pip install pdfplumber
import pdfplumber

def table_to_md(rows):
    rows = [[(c or "").replace("|", "\\|").strip() for c in r] for r in rows]
    head, body = rows[0], rows[1:]
    lines = ["| " + " | ".join(head) + " |", "|" + " --- |" * len(head)]
    lines += ["| " + " | ".join(r) + " |" for r in body]
    return "\n".join(lines)

with pdfplumber.open("invoice.pdf") as pdf:
    for page in pdf.pages:
        for table in page.extract_tables():
            print(table_to_md(table), end="\n\n")
Uma pasta inteira com pymupdf4llm
Terceiros · AGPLUm loop: lê cada arquivo da pasta pdfs e grava um arquivo .md para cada entrada.
# pip install pymupdf4llm
import pathlib
import pymupdf4llm

out = pathlib.Path("markdown")
out.mkdir(exist_ok=True)
for pdf in sorted(pathlib.Path("pdfs").glob("*.pdf")):
    md = pymupdf4llm.to_markdown(str(pdf))
    (out / f"{pdf.stem}.md").write_text(md, encoding="utf-8")
    print("wrote", out / f"{pdf.stem}.md")
Onde um script Python faz sentido
Três tarefas em que vale a pena programar.
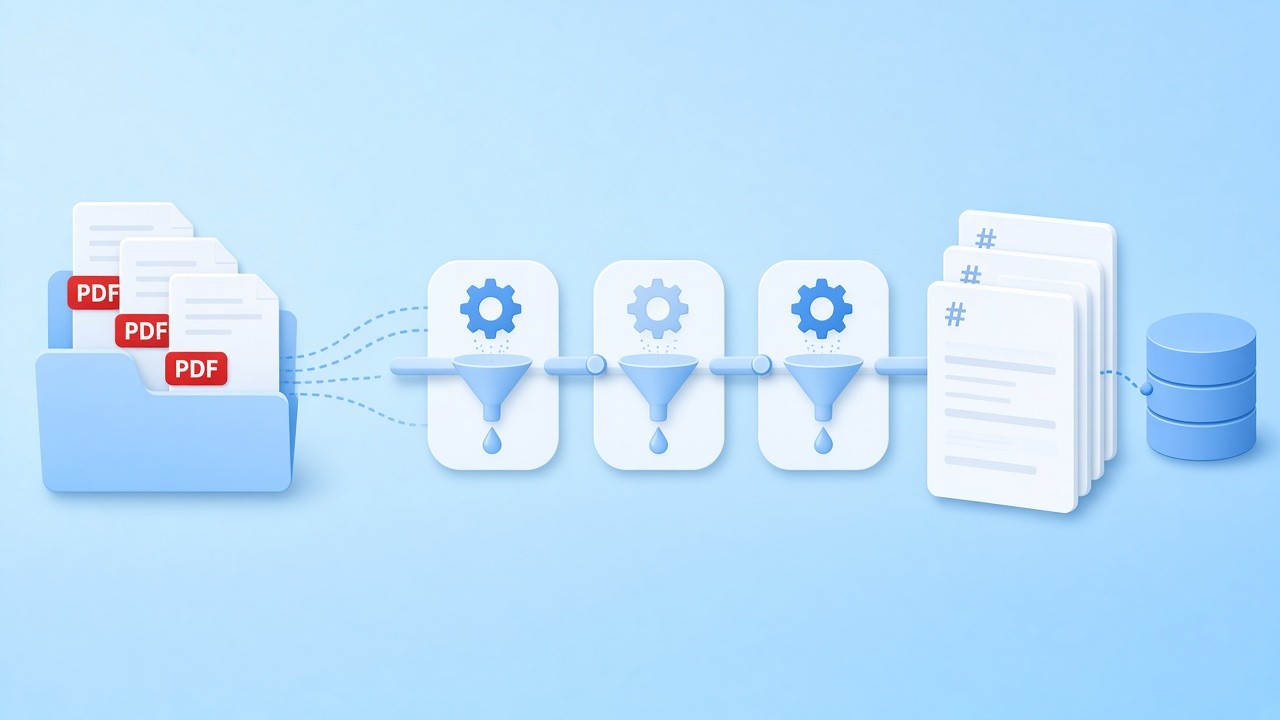
Pipelines de recuperação
Antes de indexar, rode um script que converte cada PDF para Markdown, divida a saída nos títulos e guarde cada seção.
Ler o guia de LLM
Análise num notebook
Extraia tabelas com pdfplumber num notebook, confira as linhas com o original e guarde a saída ao lado da sua análise.
Ver os trechos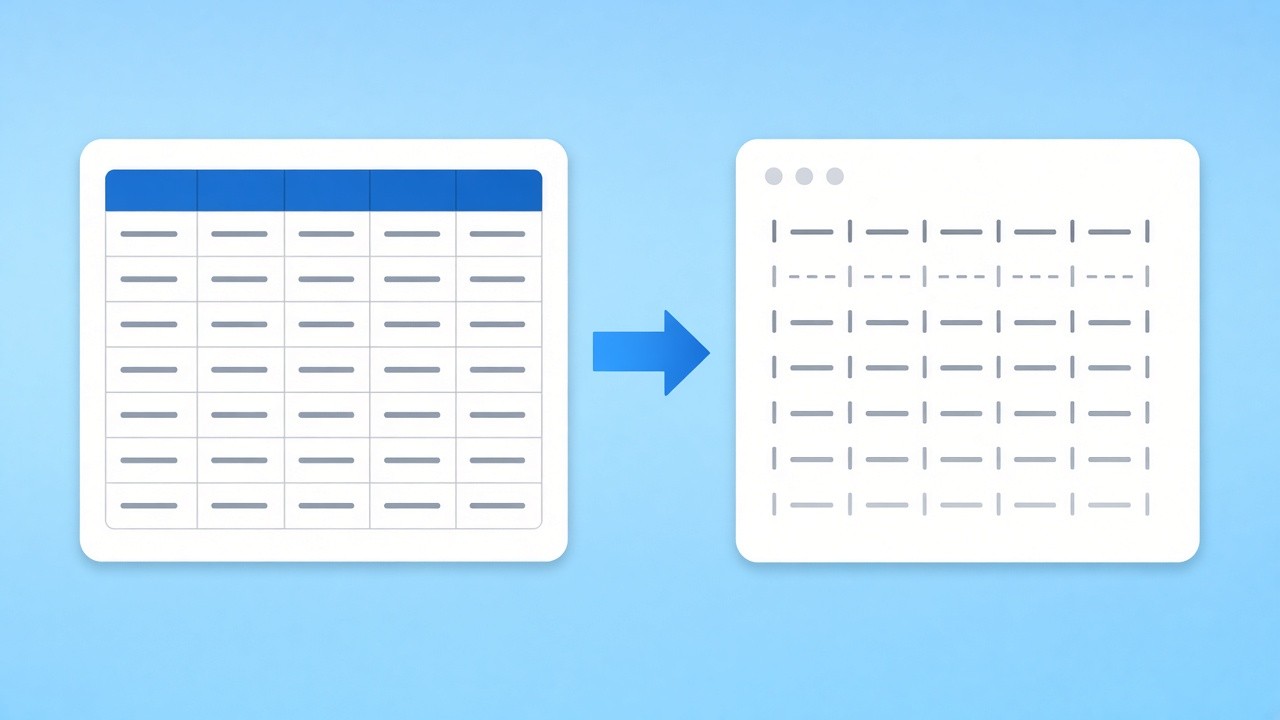
Extração de tabelas
Se o que importa são os números, a função auxiliar acima transforma tabelas com linhas em tabelas com barras, e você pode ignorar o texto corrido.
Testar a ferramenta no navegador
Script ou navegador: seus arquivos ficam no seu computador
Um script local não manda seus arquivos para lugar nenhum, e a nossa ferramenta no navegador também não: a conversão de PDF para Markdown roda com pdf.js na página, e o arquivo nunca chega aos nossos servidores.
Transformar Markdown em páginas de novo
Depois de uma rodada com Python, talvez você precise de uma versão para imprimir. A ferramenta do outro lado transforma Markdown em páginas A4 no navegador.
Ferramentas relacionadas
Mais páginas sobre PDF para Markdown.
Prefere não configurar nada? Converta aqui seu PDF para Markdown
Solte um documento e copie texto limpo, ou rode os trechos acima no seu computador. Grátis e privado.
Converter um arquivoFontes
- pymupdf4llm to_markdown() reference — PDF4LLM docs
- PyMuPDF (AGPL-3.0) — GitHub
- pdfplumber (MIT) — GitHub
- pdf.js — Mozilla
Perguntas frequentes
Dúvidas sobre opções em Python, licenças e limites.
Qual é o jeito mais simples de converter PDF para Markdown com Python?
pymupdf4llm: instale com pip e chame to_markdown num arquivo. Você recebe Markdown com títulos, listas e tabelas com linhas.
Preciso de conta ou de chave?
Não. As bibliotecas são instaladas com pip e rodam offline, e a ferramenta no navegador não pede cadastro. Para scripts, use uma biblioteca Python local.
pymupdf4llm e pdfplumber são de vocês?
Não. Os dois são projetos de código aberto de terceiros. pymupdf4llm e PyMuPDF são AGPL; pdfplumber é MIT.
Um script Python consegue ler digitalizações?
Não sozinho. Páginas que são só imagem precisam antes de uma etapa de OCR. A nossa ferramenta no navegador também não tem OCR e avisa quando um arquivo parece digitalizado.
Como manter as tabelas ao converter PDF para Markdown?
pymupdf4llm grava tabelas com linhas como tabelas com barras; pdfplumber encontra as tabelas e a função auxiliar converte. Tabelas sem borda precisam de ajuste fino nos dois casos.
A ferramenta no navegador é igual a essas bibliotecas?
Não. Ela usa pdf.js e regras de layout próprias, então a saída pode ser diferente. Não precisa de instalação e serve para um punhado de arquivos.
Um script Python envia meus arquivos?
Não. Scripts locais rodam no seu computador, e a ferramenta no navegador desta página processa os arquivos sem enviá-los.