PyMuPDF4LLM vs pdfplumber vs Marker, testados em PDFs reais
Por Equipe pdftomd.tools · Atualizado em · 8 min de leitura
A resposta curta dos nossos testes: pymupdf4llm é a melhor escolha padrão, rápida e com os títulos mais limpos, se a licença AGPL servir para você. pdfplumber, sob MIT, é o mais preciso em tabelas com bordas, mas não gera nenhum título. marker lida melhor com tabelas sem bordas e tira o que sobra das páginas, mas em CPU é várias vezes mais lento e estragou nosso texto em chinês. Para um arquivo só, nosso guia de PDF para Markdown com Python também mostra um caminho sem instalar nada.
PyMuPDF4LLM vs pdfplumber vs Marker: o veredito
| Se você precisa de… | Escolha | Por quê |
|---|---|---|
| Bom Markdown, rápido e com títulos | pymupdf4llm | Todos os títulos esperados no nível certo nos três documentos |
| Células exatas em tabelas com bordas, licença permissiva | pdfplumber | Exato em grades com bordas e células mescladas; licença MIT |
| Tabelas sem bordas, sem cabeçalhos repetidos | marker | Achou os dois exemplos simples sem bordas; removeu cabeçalhos e números de página |
| Texto em chinês ou japonês | pymupdf4llm | Manteve todos os caracteres e a pontuação; marker perdeu caracteres |
Nenhuma biblioteca venceu todos os testes. O resto do artigo mostra os números por trás de cada linha, para você decidir entre pymupdf4llm vs pdfplumber vs marker com os PDFs que você realmente tem.
Como testamos: hardware, versões e documentos
Para uma comparação justa, cada biblioteca recebeu os mesmos arquivos na mesma máquina. Todas as execuções foram pura análise de PDF em CPU: Intel(R) Xeon(R) Processor, 8 vCPU, 16 GB de RAM, sem GPU, Linux 6.12.94+ x86_64, Python 3.13.5. Versões: pymupdf4llm 1.28.2 (PyMuPDF 1.28.2), pdfplumber 0.11.9 (pdfminer.six 20251230), marker-pdf 2.0.0 (surya-ocr 0.22.1, torch 2.14.1+cpu). Contamos os tokens com tiktoken 0.14.0 e a codificação o200k_base. O teste foi feito em 19 de outubro de 2026.
- Documentos: um guia em inglês de 5 páginas com 13 títulos e uma tabela; um relatório em chinês de 11 páginas com 29 títulos e 4 tabelas; um relatório em inglês de 4 páginas com cabeçalho e número de página repetidos em todas as páginas.
- Exemplos de tabelas: 11 PDFs de uma página cujas tabelas corretas conhecemos célula por célula, dois deles sem nenhuma tabela.
- Configuração: os padrões de cada biblioteca. pdfplumber não tem saída em Markdown, então escrevemos umas vinte linhas que colocam as linhas de texto e os resultados de
find_tables()na ordem de leitura. marker rodou uma vez com a configuração padrão (modo rápido, o padrão em CPU) e outra com--disable_ocr. - Tempo: a mediana de três execuções. Os modelos do marker foram carregados uma vez antes (4,79 segundos) e uma execução de aquecimento foi descartada.
import pymupdf4llm
md = pymupdf4llm.to_markdown("report.pdf")

import pdfplumber
with pdfplumber.open("report.pdf") as pdf:
    for page in pdf.pages:
        lines = page.extract_text_lines()
        tables = page.find_tables()

from marker.converters.pdf import PdfConverter
from marker.models import create_model_dict
from marker.output import text_from_rendered
converter = PdfConverter(artifact_dict=create_model_dict())
md, _, _ = text_from_rendered(converter("report.pdf"))Em CPU, o marker 2.0 também precisa de um binário llama-server do llama.cpp, instalado à parte conforme o README, e na primeira execução baixou cerca de 1,8 GB de arquivos de modelo na nossa máquina. As duas primeiras tentativas falharam: uma por versões incompatíveis de torch e torchvision, outra porque faltava o llama-server. Foram problemas de instalação, não bugs da biblioteca, mas reserve um tempo para isso.
Velocidade e número de tokens
| Biblioteca | Guia em inglês (5 p.) | Relatório em chinês (11 p.) | Relatório em inglês com cabeçalhos repetidos (4 p.) | Tokens, relatório em chinês |
|---|---|---|---|---|
| pymupdf4llm | 0,693 s | 1,419 s | 0,387 s | 8908 |
| pdfplumber | 0,713 s | 3,579 s | 0,023 s | 8782 |
| marker (padrão) | 3,354 s | 4,563 s | 2,325 s | 10001 |
| marker (--disable_ocr) | 1,425 s | 3,146 s | 0,447 s | 10001 |
É na velocidade que pymupdf4llm vs pdfplumber vs marker mais se diferenciam. pdfplumber foi o mais rápido no relatório curto (0,023 s), mas o mais lento das ferramentas leves no relatório em chinês. pymupdf4llm se manteve estável, entre 0,1 e 0,14 segundo por página. marker foi 5 vezes mais lento que pymupdf4llm no guia em inglês, mesmo com os modelos já carregados; com --disable_ocr, a diferença diminuiu.
Os tokens das duas bibliotecas leves ficaram próximos. marker gerou cerca de 12% mais tokens no relatório em chinês, em parte por tags <sup> e espaços a mais, e menos no relatório curto, porque removeu os cabeçalhos repetidos.
Títulos e sobras da página
| Biblioteca | Guia em inglês (13) | Relatório em chinês (29) | Relatório em inglês com cabeçalhos repetidos (4) |
|---|---|---|---|
| pymupdf4llm | 13 (13 no nível certo) | 29 (29 no nível certo) | 4 (4 no nível certo) |
| pdfplumber | 0 (0 no nível certo) | 0 (0 no nível certo) | 0 (0 no nível certo) |
| marker (padrão) | 11 (4 no nível certo) | 23 (14 no nível certo) | 4 (3 no nível certo) |
| marker (--disable_ocr) | 11 (4 no nível certo) | 23 (14 no nível certo) | 4 (3 no nível certo) |
Os títulos são a segunda grande diferença. pymupdf4llm encontrou todos os títulos no nível certo. Também marcou como títulos as perguntas de FAQ em negrito do guia (6 linhas), o que pode ser útil. pdfplumber não conhece títulos: você recebe texto corrido. marker achou a maioria dos títulos, mas muitas vezes no nível errado.
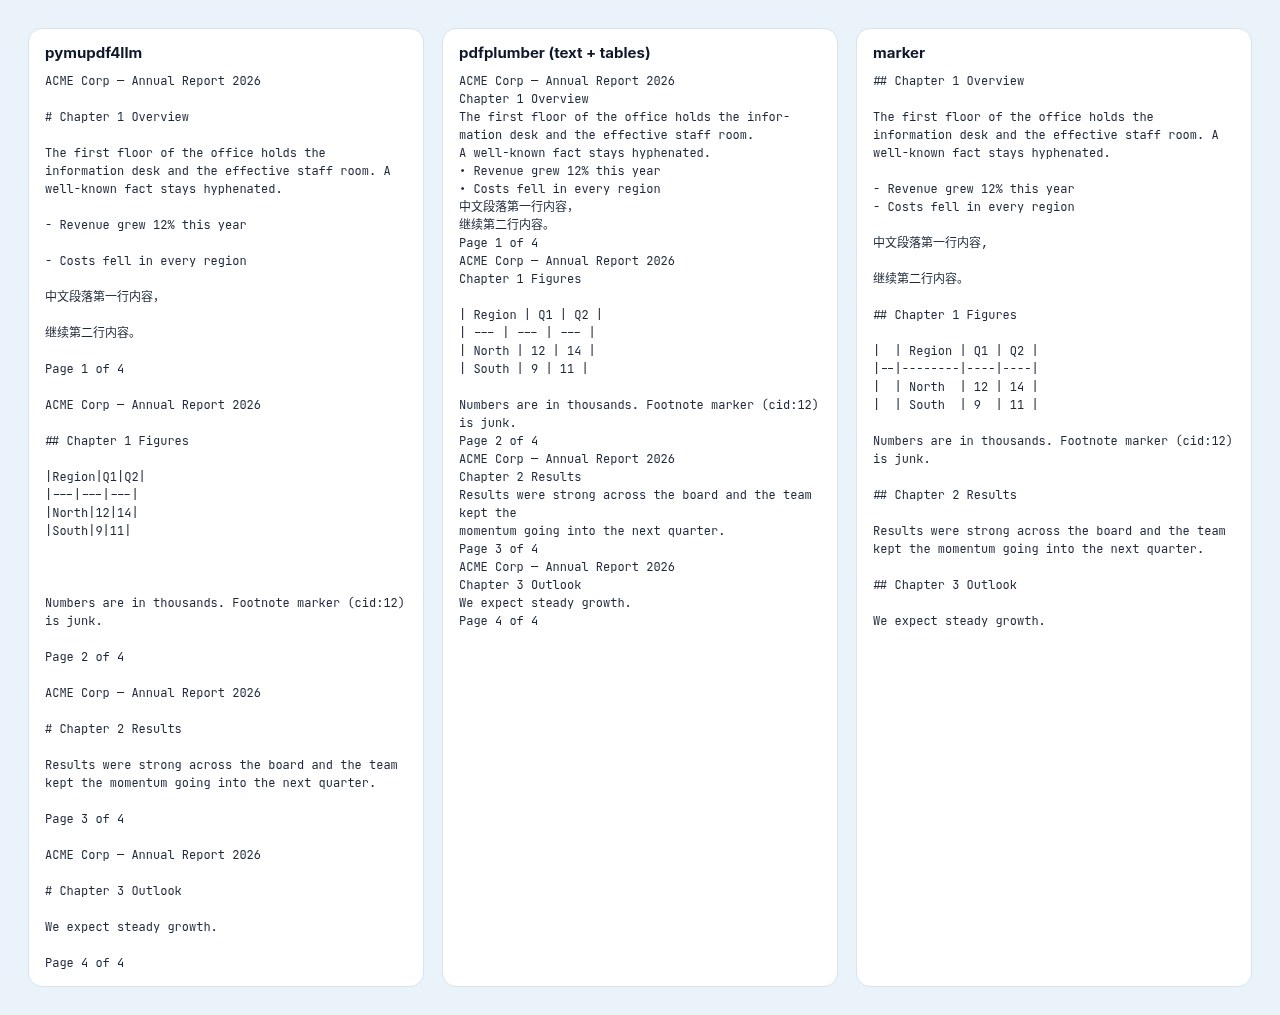
No relatório de 4 páginas, pymupdf4llm e pdfplumber mantiveram as 4 cópias do cabeçalho repetido e os 4 números de página; marker removeu os dois. É o caso mais claro de pymupdf4llm vs marker: o modelo de layout do marker sabe o que é um cabeçalho, as bibliotecas leves não. pdfplumber também deixou uma palavra hifenizada no fim de uma linha.
Tabelas: com bordas, sem bordas e mescladas
| Exemplo | pymupdf4llm | pdfplumber | marker |
|---|---|---|---|
| Grade com bordas | exata | exata | exata |
| Exportação do Office | 81% das células | exata | 94% das células |
| Sem bordas | 40% das células | não encontrada | 90% das células |
| Células com várias linhas | exata | exata | 83% das células |
| Sem bordas, várias linhas | não encontrada | não encontrada | 83% das células |
| Office, sem bordas | não encontrada | não encontrada | não encontrada |
| Tabela no meio do texto | exata | não encontrada | exata |
| Duas tabelas | exata | 33% das células | exata |
| Células mescladas | 83% das células | exata | 42% das células |
Nas tabelas, a classificação depende de o PDF ter linhas desenhadas. As tabelas do pdfplumber saem exatas quando o PDF desenha a grade, inclusive com células mescladas, porque find_tables() segue os traços. Sem traços, ele não achou nada. pymupdf4llm foi exato na maioria das tabelas com bordas, mas quebrou uma tabela do Office em que uma célula tinha um | sem escape. marker achou os dois exemplos simples sem bordas com 83 a 90% das células, enquanto pymupdf4llm achou um com 40% e pdfplumber nenhum; no exemplo de células mescladas, porém, marker juntou colunas.
Nenhuma biblioteca detectou a tabela sem bordas de uma exportação do Office. Se tabelas são sua prioridade, nosso guia de tabelas em PDF explica por que layouts sem bordas são difíceis para qualquer ferramenta.
Texto em chinês: cobertura, espaços e pontuação
| Biblioteca | Caracteres chineses mantidos | Espaços dentro de frases | Quebras de linha dentro de frases | Vírgulas de largura total mantidas |
|---|---|---|---|---|
| pymupdf4llm | 100% | 159 | 0 | 100% |
| pdfplumber | 100% | 0 | 140 | 100% |
| marker (padrão) | 98,6% | 166 | 0 | 0% |
O texto em chinês embaralha a ordem de novo. O PDF de origem não tem espaços dentro das frases. pymupdf4llm manteve todos os caracteres e todas as vírgulas de largura total, mas inseriu 159 espaços dentro de frases. pdfplumber também manteve os caracteres, mas deixou 140 quebras de linha no meio de frases. marker perdeu 1,4% dos caracteres, incluindo alguns títulos de seção, trocou cada vírgula de largura total por uma vírgula ASCII e acrescentou 152 tags <sup>. Em PDFs em chinês, a saída do marker foi a que mais exigiu correções nos nossos testes.
Licenças: AGPL vs MIT vs Apache, mais os termos dos modelos
- pdfplumber: MIT, segundo o arquivo LICENSE. Você pode usá-lo em código proprietário e comercial, desde que mantenha o aviso de licença.
- pymupdf4llm e PyMuPDF: os repositórios trazem a GNU AGPL 3.0 e os metadados do pacote dizem "Dual Licensed - GNU AFFERO GPL 3.0 or Artifex Commercial License". Resumindo: se você distribuir um programa que depende deles, ou disponibilizar uma versão modificada para usuários pela rede, a AGPL espera que você compartilhe o código-fonte desse programa sob a mesma licença, a menos que compre uma licença comercial da Artifex.
- marker: o código é Apache-2.0, mas os pesos dos modelos usam uma licença AI Pubs Open RAIL-M modificada. Segundo o MODEL_LICENSE, os pesos são gratuitos para pesquisa, uso pessoal e organizações com menos de US$ 5 milhões de receita bruta ou investimento; acima disso, é preciso uma licença da Datalab.
Se a licença decide por você, AGPL vs MIT é a escolha real entre as duas bibliotecas leves para a maioria das equipes comerciais, e o marker acrescenta um limite de receita. Isto é um resumo, não aconselhamento jurídico; leia os arquivos de licença antes de lançar qualquer coisa.
Fontes
- PyMuPDF4LLM documentation — Artifex
- pymupdf4llm repository and licence — GitHub
- pdfplumber README and LICENSE.txt — GitHub
- marker README, LICENSE and MODEL_LICENSE — GitHub (Datalab)
- GNU Affero General Public License v3.0 — Free Software Foundation
- tiktoken — GitHub (OpenAI)
Perguntas frequentes
Qual é melhor: pymupdf4llm vs pdfplumber vs marker?
Nos nossos testes, pymupdf4llm para documentos comuns e texto em chinês, pdfplumber para tabelas com bordas exatas sob MIT, e marker para tabelas sem bordas e páginas com cabeçalhos repetidos.
pymupdf4llm é gratuito para uso comercial?
Sob a AGPL, sim, se você também publicar seu código-fonte ao distribuir o programa ou oferecê-lo como serviço. Caso contrário, a Artifex vende uma licença comercial.
O marker precisa de GPU?
Não. Ele rodou na nossa máquina de 8 vCPU sem GPU, mas precisou do llama-server do llama.cpp e foi várias vezes mais lento que as bibliotecas leves.
O pdfplumber consegue gerar Markdown?
Não diretamente. Ele devolve texto, palavras, linhas e tabelas; o Markdown você mesmo monta, como fizemos neste teste.
Qual biblioteca lida com PDFs escaneados?
O marker é construído em torno de modelos de OCR. Na configuração padrão, pymupdf4llm e pdfplumber leem a camada de texto, então um escaneamento sai vazio.
Posso repetir este teste?
Sim. O script, as versões e o hardware estão acima; os tempos vão mudar em outra máquina, os resultados de qualidade não deveriam.