PyMuPDF4LLM vs. pdfplumber vs. Marker, getestet mit echten PDFs
Von pdftomd.tools-Team · Aktualisiert am · 7 Min. Lesezeit
Die kurze Antwort aus unseren Tests: pymupdf4llm ist der beste Standard, schnell und mit den saubersten Überschriften, sofern die AGPL-Lizenz für dich passt. pdfplumber unter MIT ist bei linierten Tabellen am genauesten, liefert aber keine Überschriften. marker kommt mit randlosen Tabellen am besten zurecht und entfernt Seitenballast, ist auf der CPU aber um ein Vielfaches langsamer und hat unseren chinesischen Text beschädigt. Für einzelne Dateien zeigt unser Ratgeber PDF in Markdown mit Python auch einen Weg ohne Installation.
PyMuPDF4LLM vs. pdfplumber vs. Marker: das Fazit
| Wenn du … brauchst | Wähle | Warum |
|---|---|---|
| Gutes Markdown, schnell, mit Überschriften | pymupdf4llm | Alle erwarteten Überschriften auf der richtigen Ebene in allen drei Dokumenten |
| Exakte Zellen aus linierten Tabellen, freizügige Lizenz | pdfplumber | Exakt bei linierten Rastern und verbundenen Zellen; MIT-Lizenz |
| Randlose Tabellen, keine laufenden Kopfzeilen | marker | Fand beide einfachen randlosen Beispiele; entfernte Kopfzeilen und Seitenzahlen |
| Chinesischen oder japanischen Text | pymupdf4llm | Alle Zeichen und die Satzzeichen erhalten; marker verlor Zeichen |
Keine Bibliothek hat jeden Test gewonnen. Der Rest des Artikels zeigt die Zahlen hinter jeder Zeile, damit du pymupdf4llm vs. pdfplumber vs. marker an den PDFs abwägen kannst, die du tatsächlich hast.
So haben wir getestet: Hardware, Versionen, Dokumente
Damit der Vergleich fair ist, bekam jede Bibliothek dieselben Dateien auf demselben Rechner. Alle Läufe waren reines PDF-Parsing auf der CPU: Intel(R) Xeon(R) Processor, 8 vCPUs, 16 GB RAM, keine GPU, Linux 6.12.94+ x86_64, Python 3.13.5. Versionen: pymupdf4llm 1.28.2 (PyMuPDF 1.28.2), pdfplumber 0.11.9 (pdfminer.six 20251230), marker-pdf 2.0.0 (surya-ocr 0.22.1, torch 2.14.1+cpu). Tokens haben wir mit tiktoken 0.14.0 und der Kodierung o200k_base gezählt. Der Test lief am 19. Oktober 2026.
- Dokumente: ein 5-seitiger englischer Leitfaden mit 13 Überschriften und einer Tabelle; ein 11-seitiger chinesischer Bericht mit 29 Überschriften und 4 Tabellen; ein 4-seitiger englischer Bericht mit laufender Kopfzeile und Seitenzahl auf jeder Seite.
- Tabellenbeispiele: 11 einseitige PDFs, deren korrekte Tabellen wir Zelle für Zelle kennen, darunter zwei ganz ohne Tabelle.
- Einstellungen: die Standardwerte jeder Bibliothek. pdfplumber hat keine Markdown-Ausgabe, deshalb haben wir rund 20 Zeilen geschrieben, die seine Textzeilen und die Ergebnisse von
find_tables()in Lesereihenfolge bringen. marker lief einmal mit Standardwerten (Fast-Modus, sein CPU-Standard) und einmal mit--disable_ocr. - Zeitmessung: der Median aus drei Läufen. Die Modelle von marker wurden vorher einmal geladen (4,79 Sekunden), und ein Aufwärmlauf wurde verworfen.
import pymupdf4llm
md = pymupdf4llm.to_markdown("report.pdf")

import pdfplumber
with pdfplumber.open("report.pdf") as pdf:
    for page in pdf.pages:
        lines = page.extract_text_lines()
        tables = page.find_tables()

from marker.converters.pdf import PdfConverter
from marker.models import create_model_dict
from marker.output import text_from_rendered
converter = PdfConverter(artifact_dict=create_model_dict())
md, _, _ = text_from_rendered(converter("report.pdf"))Auf der CPU braucht marker 2.0 außerdem ein llama-server-Binary aus llama.cpp, das laut README separat installiert werden muss, und beim ersten Start lud es auf unserem Rechner rund 1,8 GB Modelldateien herunter. Unsere ersten beiden Versuche schlugen fehl: einmal wegen unpassender Versionen von torch und torchvision, einmal, weil llama-server fehlte. Beides waren Einrichtungsprobleme, keine Fehler der Bibliothek, aber plane Zeit dafür ein.
Tempo und Token-Zahlen
| Bibliothek | Englischer Leitfaden (5 S.) | Chinesischer Bericht (11 S.) | Englischer Bericht mit laufenden Kopfzeilen (4 S.) | Tokens, chinesischer Bericht |
|---|---|---|---|---|
| pymupdf4llm | 0,693 s | 1,419 s | 0,387 s | 8908 |
| pdfplumber | 0,713 s | 3,579 s | 0,023 s | 8782 |
| marker (Standard) | 3,354 s | 4,563 s | 2,325 s | 10001 |
| marker (--disable_ocr) | 1,425 s | 3,146 s | 0,447 s | 10001 |
Beim Tempo unterscheiden sich pymupdf4llm vs. pdfplumber vs. marker am stärksten. pdfplumber war beim kurzen Bericht am schnellsten (0,023 s), beim chinesischen aber das langsamste der leichten Tools. pymupdf4llm blieb durchgehend bei etwa 0,1 bis 0,14 Sekunden pro Seite. marker war beim englischen Leitfaden 5-mal langsamer als pymupdf4llm, obwohl seine Modelle schon geladen waren; mit --disable_ocr wurde der Abstand kleiner.
Die Token-Zahlen der beiden leichten Bibliotheken lagen nah beieinander. marker erzeugte beim chinesischen Bericht rund 12 % mehr Tokens, teils durch <sup>-Tags und zusätzliche Leerzeichen, und beim kurzen Bericht weniger, weil es die wiederholten Kopfzeilen weggelassen hat.
Überschriften und Seitenballast
| Bibliothek | Englischer Leitfaden (13) | Chinesischer Bericht (29) | Englischer Bericht mit laufenden Kopfzeilen (4) |
|---|---|---|---|
| pymupdf4llm | 13 (13 richtige Ebene) | 29 (29 richtige Ebene) | 4 (4 richtige Ebene) |
| pdfplumber | 0 (0 richtige Ebene) | 0 (0 richtige Ebene) | 0 (0 richtige Ebene) |
| marker (Standard) | 11 (4 richtige Ebene) | 23 (14 richtige Ebene) | 4 (3 richtige Ebene) |
| marker (--disable_ocr) | 11 (4 richtige Ebene) | 23 (14 richtige Ebene) | 4 (3 richtige Ebene) |
Überschriften sind der zweite große Unterschied. pymupdf4llm fand jede Überschrift auf der richtigen Ebene. Es markierte außerdem die fett gesetzten FAQ-Fragen des Leitfadens als Überschriften (6 Zeilen), was durchaus nützlich sein kann. pdfplumber kennt keine Überschriften, du bekommst also flachen Text. marker fand die meisten Überschriften, oft aber auf der falschen Ebene.
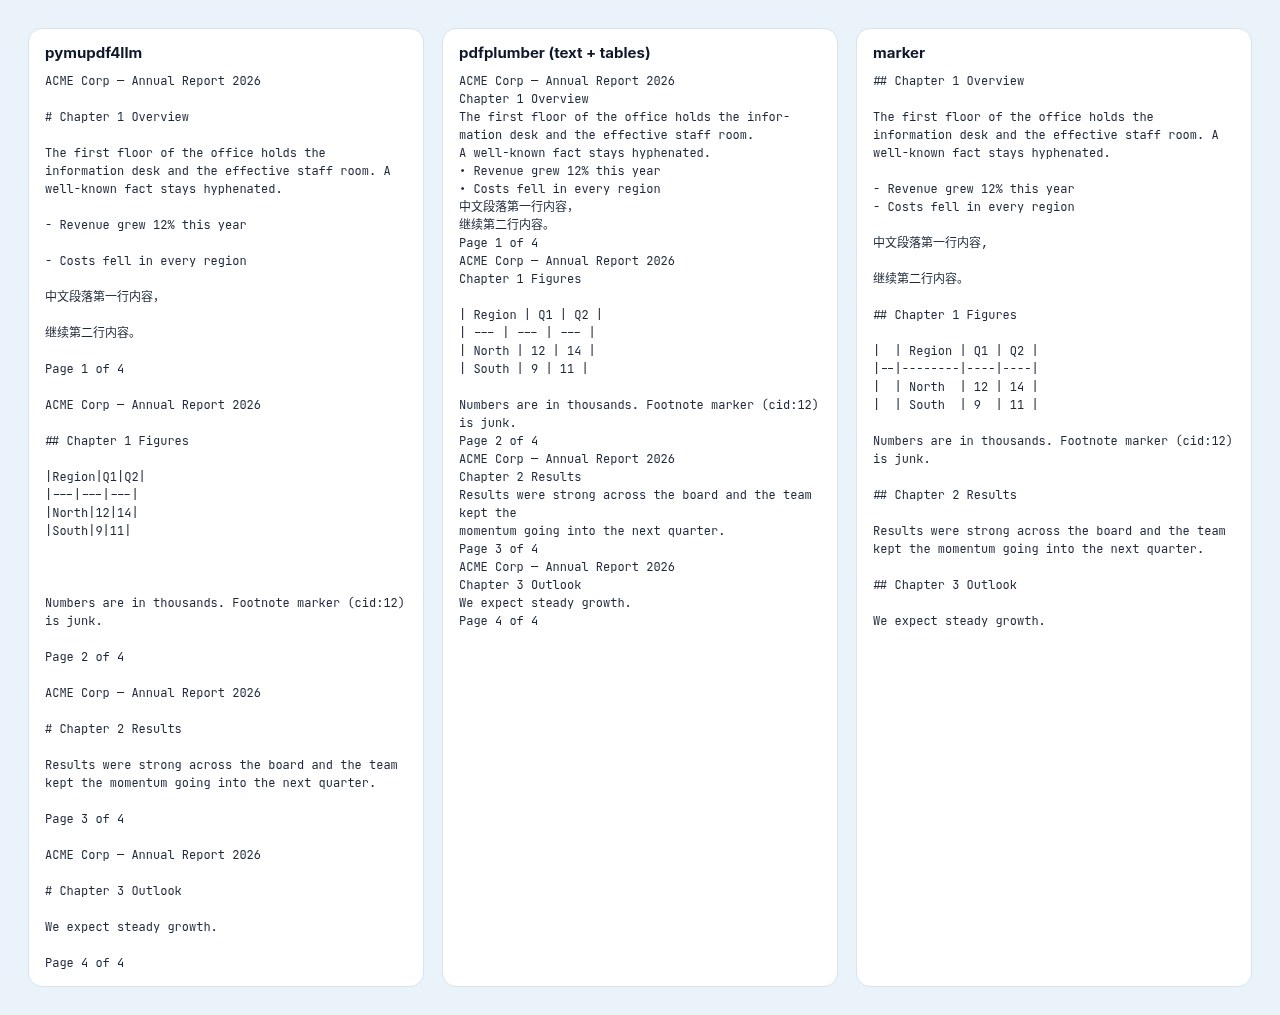
Beim 4-seitigen Bericht behielten pymupdf4llm und pdfplumber alle 4 Kopien der laufenden Kopfzeile und alle 4 Seitenzahlen; marker entfernte beides. Das ist der deutlichste Fall für pymupdf4llm vs. marker: Das Layoutmodell von marker weiß, was eine Kopfzeile ist, die leichten Bibliotheken nicht. pdfplumber ließ außerdem ein am Zeilenende getrenntes Wort stehen.
Tabellen: liniert, randlos, verbunden
| Beispiel | pymupdf4llm | pdfplumber | marker |
|---|---|---|---|
| Liniertes Raster | exakt | exakt | exakt |
| Office-Export | 81 % der Zellen | exakt | 94 % der Zellen |
| Randlos | 40 % der Zellen | nicht gefunden | 90 % der Zellen |
| Umbrochene Zellen | exakt | exakt | 83 % der Zellen |
| Randlos, umbrochen | nicht gefunden | nicht gefunden | 83 % der Zellen |
| Office, randlos | nicht gefunden | nicht gefunden | nicht gefunden |
| Tabelle im Fließtext | exakt | nicht gefunden | exakt |
| Zwei Tabellen | exakt | 33 % der Zellen | exakt |
| Verbundene Zellen | 83 % der Zellen | exakt | 42 % der Zellen |
Bei Tabellen hängt die Rangfolge davon ab, ob die PDF Linien zeichnet. Tabellen aus pdfplumber sind exakt, wenn die PDF ihre Rasterlinien zeichnet, auch bei verbundenen Zellen, weil find_tables() den Linien folgt. Ohne Linien fand es nichts. pymupdf4llm war bei den meisten linierten Tabellen exakt, zerlegte aber eine Office-Tabelle, in der eine Zelle ein | enthielt, das es nicht maskiert hat. marker fand beide einfachen randlosen Beispiele mit 83–90 % der Zellen, wo pymupdf4llm eines mit 40 % fand und pdfplumber keines; im Beispiel mit verbundenen Zellen hat marker aber Spalten zusammengelegt.
Keine Bibliothek erkannte die randlose Tabelle aus einem Office-Export. Wenn es dir um Tabellen geht, erklärt unser Ratgeber zu PDF-Tabellen, warum randlose Layouts für jedes Tool schwierig sind.
Chinesischer Text: Abdeckung, Leerzeichen, Satzzeichen
| Bibliothek | Chinesische Zeichen erhalten | Leerzeichen in Sätzen | Zeilenumbrüche in Sätzen | Vollbreite Kommas erhalten |
|---|---|---|---|---|
| pymupdf4llm | 100 % | 159 | 0 | 100 % |
| pdfplumber | 100 % | 0 | 140 | 100 % |
| marker (Standard) | 98,6 % | 166 | 0 | 0 % |
Chinesischer Text mischt die Reihenfolge noch einmal neu. Die Quell-PDF hat keine Leerzeichen innerhalb ihrer Sätze. pymupdf4llm behielt jedes Zeichen und jedes vollbreite Komma, fügte aber 159 Leerzeichen in Sätze ein. pdfplumber behielt die Zeichen ebenfalls, ließ aber 140 Zeilenumbrüche mitten in Sätzen stehen. marker verlor 1,4 % der Zeichen, darunter einige Abschnittsüberschriften, machte aus jedem vollbreiten Komma ein ASCII-Komma und fügte 152 <sup>-Tags hinzu. Bei chinesischen PDFs brauchte die Ausgabe von marker in unseren Tests die meiste Nacharbeit.
Lizenzen: AGPL vs. MIT vs. Apache, plus Modellbedingungen
- pdfplumber: MIT, laut seiner LICENSE-Datei. Du kannst es in Closed-Source- und kommerziellem Code verwenden, solange der Lizenzhinweis erhalten bleibt.
- pymupdf4llm und PyMuPDF: Die Repositories liefern die GNU AGPL 3.0 mit, und in den Paket-Metadaten steht „Dual Licensed - GNU AFFERO GPL 3.0 or Artifex Commercial License“. Kurz gesagt: Wenn du ein darauf aufbauendes Programm verbreitest oder Nutzern eine veränderte Version über ein Netzwerk zugänglich machst, erwartet die AGPL, dass du den Quellcode dieses Programms unter derselben Lizenz teilst, es sei denn, du kaufst eine kommerzielle Lizenz von Artifex.
- marker: Der Code steht unter Apache-2.0, die Modellgewichte aber unter einer angepassten AI Pubs Open RAIL-M-Lizenz. Laut MODEL_LICENSE sind die Gewichte frei für Forschung, private Nutzung und Organisationen unter 5 Mio. $ Bruttoumsatz oder Finanzierung; darüber brauchst du eine Lizenz von Datalab.
Entscheidet die Lizenz für dich, ist AGPL vs. MIT für die meisten kommerziellen Teams die eigentliche Wahl zwischen den beiden leichten Bibliotheken, und marker bringt noch eine Umsatzschwelle mit. Das ist eine Zusammenfassung, keine Rechtsberatung; lies die Lizenzdateien, bevor du etwas veröffentlichst.
Quellen
- PyMuPDF4LLM documentation — Artifex
- pymupdf4llm repository and licence — GitHub
- pdfplumber README and LICENSE.txt — GitHub
- marker README, LICENSE and MODEL_LICENSE — GitHub (Datalab)
- GNU Affero General Public License v3.0 — Free Software Foundation
- tiktoken — GitHub (OpenAI)
FAQ
Was ist am besten: pymupdf4llm vs. pdfplumber vs. marker?
In unseren Tests pymupdf4llm für allgemeine Dokumente und chinesischen Text, pdfplumber für exakte linierte Tabellen unter MIT und marker für randlose Tabellen und Seiten mit laufenden Kopfzeilen.
Ist pymupdf4llm für kommerzielle Nutzung kostenlos?
Unter der AGPL ja, wenn du auch deinen Quellcode veröffentlichst, sobald du das Programm verbreitest oder als Dienst anbietest. Andernfalls verkauft Artifex eine kommerzielle Lizenz.
Braucht marker eine GPU?
Nein. Es lief auf unserem Rechner mit 8 vCPUs ohne GPU, brauchte aber llama-server aus llama.cpp und war um ein Vielfaches langsamer als die leichten Bibliotheken.
Kann pdfplumber Markdown ausgeben?
Nicht direkt. Es liefert Text, Wörter, Zeilen und Tabellen; das Markdown schreibst du selbst, so wie wir es für diesen Test getan haben.
Welche Bibliothek kommt mit gescannten PDFs zurecht?
marker ist um OCR-Modelle herum gebaut. Mit ihren Standardeinstellungen lesen pymupdf4llm und pdfplumber die Textebene, ein Scan bleibt also leer.
Kann ich diesen Test nachstellen?
Ja. Skript, Versionen und Hardware stehen oben; die Zeiten unterscheiden sich auf einem anderen Rechner, die Qualitätswerte sollten es nicht.