PyMuPDF4LLM vs pdfplumber vs Marker, provati su PDF veri
Di Team di pdftomd.tools · Aggiornato il · 8 min di lettura
La risposta breve dei nostri test: pymupdf4llm è la scelta migliore di partenza, veloce e con i titoli più puliti, se la licenza AGPL va bene per te. pdfplumber, con licenza MIT, è il più preciso sulle tabelle con bordi ma non produce nessun titolo. marker gestisce meglio le tabelle senza bordi e toglie il superfluo dalle pagine, ma su CPU è parecchie volte più lento e ha rovinato il nostro testo cinese. Per un singolo file, la nostra guida PDF in Markdown con Python offre anche una strada senza installare nulla.
PyMuPDF4LLM vs pdfplumber vs Marker: il verdetto
| Se ti serve… | Scegli | Perché |
|---|---|---|
| Buon Markdown, veloce e con i titoli | pymupdf4llm | Tutti i titoli attesi al livello giusto nei tre documenti |
| Celle esatte nelle tabelle con bordi, licenza permissiva | pdfplumber | Esatto su griglie con bordi e celle unite; licenza MIT |
| Tabelle senza bordi, niente intestazioni ripetute | marker | Ha trovato i due esempi semplici senza bordi; ha tolto intestazioni e numeri di pagina |
| Testo cinese o giapponese | pymupdf4llm | Tutti i caratteri e la punteggiatura conservati; marker ha perso caratteri |
Nessuna libreria ha vinto tutti i test. Il resto dell'articolo riporta i numeri dietro ogni riga, così puoi scegliere tra pymupdf4llm vs pdfplumber vs marker con i PDF che hai davvero.
Come abbiamo testato: hardware, versioni, documenti
Per un confronto equo, ogni libreria ha ricevuto gli stessi file sulla stessa macchina. Tutte le esecuzioni erano pura analisi di PDF su CPU: Intel(R) Xeon(R) Processor, 8 vCPU, 16 GB di RAM, nessuna GPU, Linux 6.12.94+ x86_64, Python 3.13.5. Versioni: pymupdf4llm 1.28.2 (PyMuPDF 1.28.2), pdfplumber 0.11.9 (pdfminer.six 20251230), marker-pdf 2.0.0 (surya-ocr 0.22.1, torch 2.14.1+cpu). Abbiamo contato i token con tiktoken 0.14.0 e la codifica o200k_base. Il test è del 19 ottobre 2026.
- Documenti: una guida inglese di 5 pagine con 13 titoli e una tabella; un report cinese di 11 pagine con 29 titoli e 4 tabelle; un report inglese di 4 pagine con intestazione e numero di pagina ripetuti su ogni pagina.
- Esempi di tabelle: 11 PDF di una pagina di cui conosciamo le tabelle corrette cella per cella, due dei quali senza alcuna tabella.
- Impostazioni: i valori predefiniti di ogni libreria. pdfplumber non ha un output Markdown, quindi abbiamo scritto una ventina di righe che rimettono le sue righe di testo e i risultati di
find_tables()in ordine di lettura. marker è stato eseguito una volta con le impostazioni predefinite (modalità veloce, la predefinita su CPU) e una volta con--disable_ocr. - Tempi: la mediana di tre esecuzioni. I modelli di marker sono stati caricati una volta prima (4,79 secondi) e un'esecuzione di riscaldamento è stata scartata.
import pymupdf4llm
md = pymupdf4llm.to_markdown("report.pdf")

import pdfplumber
with pdfplumber.open("report.pdf") as pdf:
    for page in pdf.pages:
        lines = page.extract_text_lines()
        tables = page.find_tables()

from marker.converters.pdf import PdfConverter
from marker.models import create_model_dict
from marker.output import text_from_rendered
converter = PdfConverter(artifact_dict=create_model_dict())
md, _, _ = text_from_rendered(converter("report.pdf"))Su CPU, marker 2.0 richiede anche un binario llama-server di llama.cpp, da installare a parte come indica il suo README, e al primo avvio ha scaricato circa 1,8 GB di file di modello sulla nostra macchina. I primi due tentativi sono falliti: una volta per versioni incompatibili di torch e torchvision, una volta perché mancava llama-server. Erano problemi di installazione, non bug della libreria, ma mettici in conto del tempo.
Velocità e numero di token
| Libreria | Guida in inglese (5 pag.) | Report in cinese (11 pag.) | Report inglese con intestazioni ripetute (4 pag.) | Token, report cinese |
|---|---|---|---|---|
| pymupdf4llm | 0,693 s | 1,419 s | 0,387 s | 8908 |
| pdfplumber | 0,713 s | 3,579 s | 0,023 s | 8782 |
| marker (predefinito) | 3,354 s | 4,563 s | 2,325 s | 10001 |
| marker (--disable_ocr) | 1,425 s | 3,146 s | 0,447 s | 10001 |
È sulla velocità che pymupdf4llm vs pdfplumber vs marker si distinguono di più. pdfplumber è stato il più rapido sul report breve (0,023 s), ma il più lento tra gli strumenti leggeri sul report cinese. pymupdf4llm è rimasto costante, tra 0,1 e 0,14 secondi per pagina. marker è stato 5 volte più lento di pymupdf4llm sulla guida inglese, pur con i modelli già caricati; con --disable_ocr il distacco si è ridotto.
I token delle due librerie leggere erano simili. marker ha prodotto circa il 12% di token in più sul report cinese, in parte per tag <sup> e spazi in più, e meno sul report breve, perché ha eliminato le intestazioni ripetute.
Titoli e superfluo delle pagine
| Libreria | Guida in inglese (13) | Report in cinese (29) | Report inglese con intestazioni ripetute (4) |
|---|---|---|---|
| pymupdf4llm | 13 (13 al livello giusto) | 29 (29 al livello giusto) | 4 (4 al livello giusto) |
| pdfplumber | 0 (0 al livello giusto) | 0 (0 al livello giusto) | 0 (0 al livello giusto) |
| marker (predefinito) | 11 (4 al livello giusto) | 23 (14 al livello giusto) | 4 (3 al livello giusto) |
| marker (--disable_ocr) | 11 (4 al livello giusto) | 23 (14 al livello giusto) | 4 (3 al livello giusto) |
I titoli sono la seconda grande differenza. pymupdf4llm ha trovato ogni titolo al livello giusto. Ha anche segnato come titoli le domande delle FAQ in grassetto della guida (6 righe), cosa che può tornare utile. pdfplumber non conosce i titoli: ottieni testo piatto. marker ha trovato quasi tutti i titoli, ma spesso al livello sbagliato.
Nel report di 4 pagine, pymupdf4llm e pdfplumber hanno tenuto tutte le 4 copie dell'intestazione ripetuta e i 4 numeri di pagina; marker li ha tolti entrambi. È il caso più netto di pymupdf4llm vs marker: il modello di layout di marker sa cos'è un'intestazione, le librerie leggere no. pdfplumber ha anche lasciato una parola spezzata a fine riga.
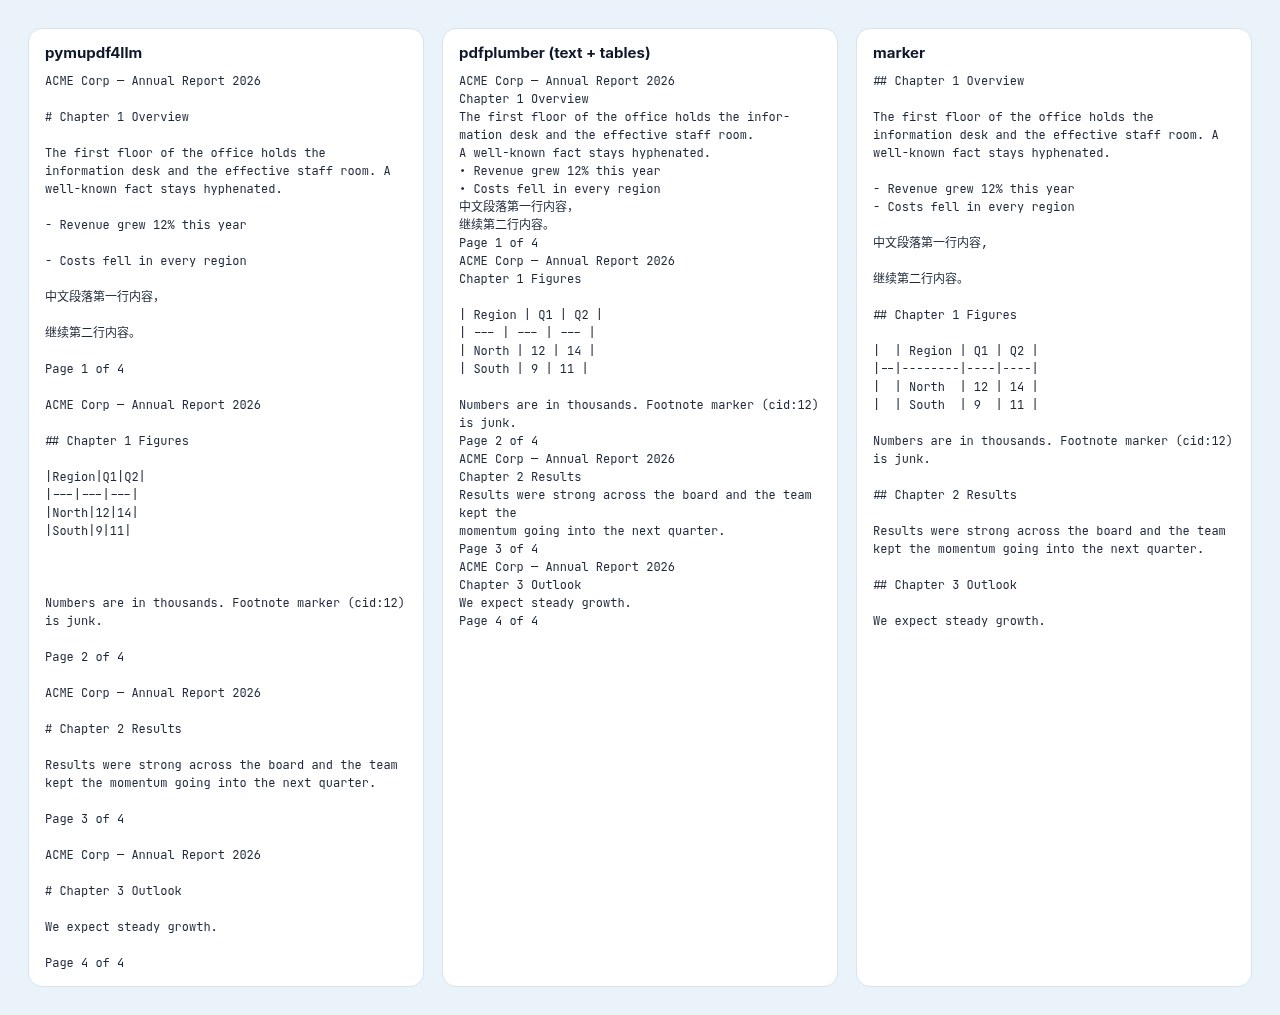
Tabelle: con bordi, senza bordi, celle unite
| Esempio | pymupdf4llm | pdfplumber | marker |
|---|---|---|---|
| Griglia con bordi | esatta | esatta | esatta |
| Esportazione da Office | 81% delle celle | esatta | 94% delle celle |
| Senza bordi | 40% delle celle | non trovata | 90% delle celle |
| Celle su più righe | esatta | esatta | 83% delle celle |
| Senza bordi, più righe | non trovata | non trovata | 83% delle celle |
| Office, senza bordi | non trovata | non trovata | non trovata |
| Tabella nel testo | esatta | non trovata | esatta |
| Due tabelle | esatta | 33% delle celle | esatta |
| Celle unite | 83% delle celle | esatta | 42% delle celle |
Per le tabelle, la classifica dipende dalla presenza di linee nel PDF. Le tabelle di pdfplumber sono esatte quando il PDF disegna la griglia, anche con celle unite, perché find_tables() segue i tratti. Senza tratti, non ha trovato nulla. pymupdf4llm è stato esatto sulla maggior parte delle tabelle con bordi, ma ha rotto una tabella da Office in cui una cella conteneva un | non escapato. marker ha trovato i due esempi semplici senza bordi con l'83–90% delle celle, mentre pymupdf4llm ne ha trovato uno con il 40% e pdfplumber nessuno; nell'esempio con celle unite, però, marker ha fuso delle colonne.
Nessuna libreria ha individuato la tabella senza bordi di un'esportazione da Office. Se le tabelle sono la tua priorità, la nostra guida alle tabelle PDF spiega perché i layout senza bordi sono difficili per qualsiasi strumento.
Testo cinese: copertura, spazi, punteggiatura
| Libreria | Caratteri cinesi conservati | Spazi dentro le frasi | A capo dentro le frasi | Virgole a larghezza piena conservate |
|---|---|---|---|---|
| pymupdf4llm | 100% | 159 | 0 | 100% |
| pdfplumber | 100% | 0 | 140 | 100% |
| marker (predefinito) | 98,6% | 166 | 0 | 0% |
Il testo cinese rimescola di nuovo le carte. Il PDF di partenza non ha spazi dentro le frasi. pymupdf4llm ha conservato ogni carattere e ogni virgola a larghezza piena, ma ha inserito 159 spazi dentro le frasi. Anche pdfplumber ha conservato i caratteri, ma ha lasciato 140 a capo a metà frase. marker ha perso il 1,4% dei caratteri, compresi alcuni titoli di sezione, ha sostituito ogni virgola a larghezza piena con una virgola ASCII e ha aggiunto 152 tag <sup>. Sui PDF cinesi, l'output di marker è stato quello che ha richiesto più correzioni nei nostri test.
Licenze: AGPL vs MIT vs Apache, più le condizioni dei modelli
- pdfplumber: MIT, secondo il suo file LICENSE. Puoi usarlo in codice proprietario e commerciale purché conservi la nota di licenza.
- pymupdf4llm e PyMuPDF: i repository includono la GNU AGPL 3.0 e i metadati del pacchetto riportano «Dual Licensed - GNU AFFERO GPL 3.0 or Artifex Commercial License». In breve: se distribuisci un programma che li usa, o metti una versione modificata a disposizione di utenti tramite rete, l'AGPL si aspetta che tu condivida il codice sorgente di quel programma con la stessa licenza, a meno che tu non compri una licenza commerciale da Artifex.
- marker: il codice è Apache-2.0, ma i pesi dei modelli usano una licenza AI Pubs Open RAIL-M modificata. Secondo MODEL_LICENSE, i pesi sono gratuiti per ricerca, uso personale e organizzazioni sotto i 5 M$ di ricavi lordi o finanziamenti; oltre serve una licenza di Datalab.
Se a decidere è la licenza, AGPL vs MIT è la vera scelta tra le due librerie leggere per la maggior parte dei team commerciali, e marker aggiunge una soglia di ricavi. Questo è un riassunto, non una consulenza legale; leggi i file di licenza prima di pubblicare qualcosa.
Fonti
- PyMuPDF4LLM documentation — Artifex
- pymupdf4llm repository and licence — GitHub
- pdfplumber README and LICENSE.txt — GitHub
- marker README, LICENSE and MODEL_LICENSE — GitHub (Datalab)
- GNU Affero General Public License v3.0 — Free Software Foundation
- tiktoken — GitHub (OpenAI)
Domande frequenti
Qual è il migliore: pymupdf4llm vs pdfplumber vs marker?
Nei nostri test, pymupdf4llm per i documenti comuni e il testo cinese, pdfplumber per tabelle con bordi esatte con licenza MIT, e marker per tabelle senza bordi e pagine con intestazioni ripetute.
pymupdf4llm è gratuito per uso commerciale?
Con l'AGPL sì, se pubblichi anche il tuo codice sorgente quando distribuisci il programma o lo offri come servizio. Altrimenti Artifex vende una licenza commerciale.
marker ha bisogno di una GPU?
No. Ha girato sulla nostra macchina da 8 vCPU senza GPU, ma ha richiesto llama-server di llama.cpp ed è stato parecchie volte più lento delle librerie leggere.
pdfplumber può produrre Markdown?
Non direttamente. Restituisce testo, parole, righe e tabelle; il Markdown lo scrivi tu, come abbiamo fatto per questo test.
Quale libreria gestisce i PDF scansionati?
marker è costruito attorno a modelli OCR. Con le impostazioni predefinite, pymupdf4llm e pdfplumber leggono il livello di testo, quindi una scansione resta vuota.
Posso ripetere questo test?
Sì. Script, versioni e hardware sono indicati sopra; i tempi cambieranno su un'altra macchina, i risultati di qualità non dovrebbero.