PyMuPDF4LLM vs pdfplumber vs Marker, 실제 PDF로 비교해 봤습니다
작성 pdftomd.tools 팀 · 업데이트 · 6분 분량
테스트 결과를 짧게 말하면 이렇습니다. AGPL 라이선스가 괜찮다면 pymupdf4llm이 가장 무난한 기본 선택입니다. 빠르고 제목도 가장 깔끔하게 뽑습니다. MIT 라이선스인 pdfplumber는 테두리 있는 표에서 가장 정확하지만 제목은 하나도 만들지 않습니다. marker는 테두리 없는 표를 가장 잘 다루고 페이지의 군더더기도 걷어 내지만, CPU에서는 몇 배 느리고 중국어 텍스트를 망가뜨렸습니다. 파일 하나만 바꿀 거라면 파이썬 PDF 마크다운 변환 가이드에서 설치 없이 하는 방법도 볼 수 있습니다.
PyMuPDF4LLM vs pdfplumber vs Marker: 결론부터
| 이게 필요하다면… | 선택 | 이유 |
|---|---|---|
| 제목까지 살린 Markdown을 빠르게 | pymupdf4llm | 세 문서 모두에서 기대한 제목을 전부 올바른 수준으로 찾음 |
| 테두리 있는 표의 정확한 셀, 느슨한 라이선스 | pdfplumber | 테두리 있는 표와 병합된 셀에서 정확; MIT 라이선스 |
| 테두리 없는 표, 반복 머리글 제거 | marker | 간단한 테두리 없는 예제 두 개를 찾음; 머리글과 쪽 번호를 지움 |
| 중국어·일본어 텍스트 | pymupdf4llm | 모든 글자와 문장부호 유지; marker는 글자를 잃음 |
모든 테스트에서 이긴 라이브러리는 없었습니다. 아래에서 각 행의 근거가 된 숫자를 보여 드리니, 갖고 계신 PDF를 기준으로 pymupdf4llm vs pdfplumber vs marker 중에서 고르시면 됩니다.
테스트 방법: 하드웨어, 버전, 문서
공정하게 비교하려고 세 라이브러리에 같은 파일을 같은 기기에서 넣었습니다. 모든 실행은 CPU에서 PDF만 파싱했습니다. Intel(R) Xeon(R) Processor, 8 vCPU, RAM 16GB, GPU 없음, Linux 6.12.94+ x86_64, Python 3.13.5. 버전은 pymupdf4llm 1.28.2(PyMuPDF 1.28.2), pdfplumber 0.11.9(pdfminer.six 20251230), marker-pdf 2.0.0(surya-ocr 0.22.1, torch 2.14.1+cpu)입니다. 토큰은 tiktoken 0.14.0의 o200k_base 인코딩으로 셌고, 테스트 날짜는 2026년 10월 19일입니다.
- 문서: 제목 13개와 표 1개가 있는 5쪽짜리 영문 가이드, 제목 29개와 표 4개가 있는 11쪽짜리 중국어 보고서, 모든 쪽에 같은 머리글과 쪽 번호가 붙은 4쪽짜리 영문 보고서.
- 표 예제: 정답 표를 셀 단위로 알고 있는 1쪽짜리 PDF 11개. 그중 두 개는 표가 아예 없습니다.
- 설정: 각 라이브러리의 기본값. pdfplumber는 Markdown 출력이 없어서, 텍스트 줄과
find_tables()결과를 읽는 순서대로 이어 붙이는 코드를 20줄쯤 직접 썼습니다. marker는 기본 설정(CPU 기본값인 빠른 모드)으로 한 번,--disable_ocr로 한 번 돌렸습니다. - 시간 측정: 세 번 실행한 중앙값. marker 모델은 미리 한 번 불러 두었고(4.79초), 워밍업 실행 한 번은 버렸습니다.
import pymupdf4llm
md = pymupdf4llm.to_markdown("report.pdf")

import pdfplumber
with pdfplumber.open("report.pdf") as pdf:
    for page in pdf.pages:
        lines = page.extract_text_lines()
        tables = page.find_tables()

from marker.converters.pdf import PdfConverter
from marker.models import create_model_dict
from marker.output import text_from_rendered
converter = PdfConverter(artifact_dict=create_model_dict())
md, _, _ = text_from_rendered(converter("report.pdf"))CPU에서 marker 2.0을 쓰려면 llama.cpp의 llama-server 바이너리도 README에 따라 따로 설치해야 하고, 처음 실행할 때 저희 기기에서는 모델 파일을 약 1.8GB 내려받았습니다. 처음 두 번은 실패했습니다. 한 번은 torch와 torchvision 버전이 맞지 않아서, 한 번은 llama-server가 없어서였습니다. 라이브러리 버그가 아니라 설치 문제였지만, 시간을 넉넉히 잡으세요.
속도와 토큰 수
| 라이브러리 | 영문 가이드 (5쪽) | 중국어 보고서 (11쪽) | 머리글이 반복되는 영문 보고서 (4쪽) | 토큰, 중국어 보고서 |
|---|---|---|---|---|
| pymupdf4llm | 0.693초 | 1.419초 | 0.387초 | 8908 |
| pdfplumber | 0.713초 | 3.579초 | 0.023초 | 8782 |
| marker (기본값) | 3.354초 | 4.563초 | 2.325초 | 10001 |
| marker (--disable_ocr) | 1.425초 | 3.146초 | 0.447초 | 10001 |
pymupdf4llm vs pdfplumber vs marker의 차이가 가장 큰 곳은 속도입니다. pdfplumber는 짧은 보고서에서 가장 빨랐지만(0.023초), 중국어 보고서에서는 가벼운 도구 중 가장 느렸습니다. pymupdf4llm은 쪽당 0.1~0.14초로 꾸준했습니다. marker는 모델을 미리 불러 둔 상태에서도 영문 가이드에서 pymupdf4llm보다 5배 느렸고, --disable_ocr를 켜면 차이가 줄었습니다.
가벼운 두 라이브러리의 토큰 수는 비슷했습니다. marker는 중국어 보고서에서 약 12% 더 많은 토큰을 냈는데, <sup> 태그와 쓸데없는 공백 탓이 큽니다. 짧은 보고서에서는 반복 머리글을 지운 덕분에 오히려 적었습니다.
제목과 페이지 군더더기
| 라이브러리 | 영문 가이드 (13) | 중국어 보고서 (29) | 머리글이 반복되는 영문 보고서 (4) |
|---|---|---|---|
| pymupdf4llm | 13개 (올바른 수준 13개) | 29개 (올바른 수준 29개) | 4개 (올바른 수준 4개) |
| pdfplumber | 0개 (올바른 수준 0개) | 0개 (올바른 수준 0개) | 0개 (올바른 수준 0개) |
| marker (기본값) | 11개 (올바른 수준 4개) | 23개 (올바른 수준 14개) | 4개 (올바른 수준 3개) |
| marker (--disable_ocr) | 11개 (올바른 수준 4개) | 23개 (올바른 수준 14개) | 4개 (올바른 수준 3개) |
두 번째로 큰 차이는 제목입니다. pymupdf4llm은 모든 제목을 올바른 수준으로 찾았습니다. 가이드의 굵은 글씨 FAQ 질문(6줄)도 제목으로 표시했는데, 쓸모 있을 때도 있습니다. pdfplumber는 제목 개념이 없어서 평평한 텍스트만 나옵니다. marker는 제목을 대부분 찾았지만 수준이 틀린 경우가 많았습니다.
4쪽 보고서에서 pymupdf4llm과 pdfplumber는 반복 머리글 4개와 쪽 번호 4개를 그대로 남겼고, marker는 둘 다 지웠습니다. pymupdf4llm vs marker에서 가장 분명한 차이입니다. marker의 레이아웃 모델은 머리글이 뭔지 알고, 가벼운 라이브러리는 모릅니다. pdfplumber는 줄 끝에서 끊긴 단어도 하나 남겼습니다.
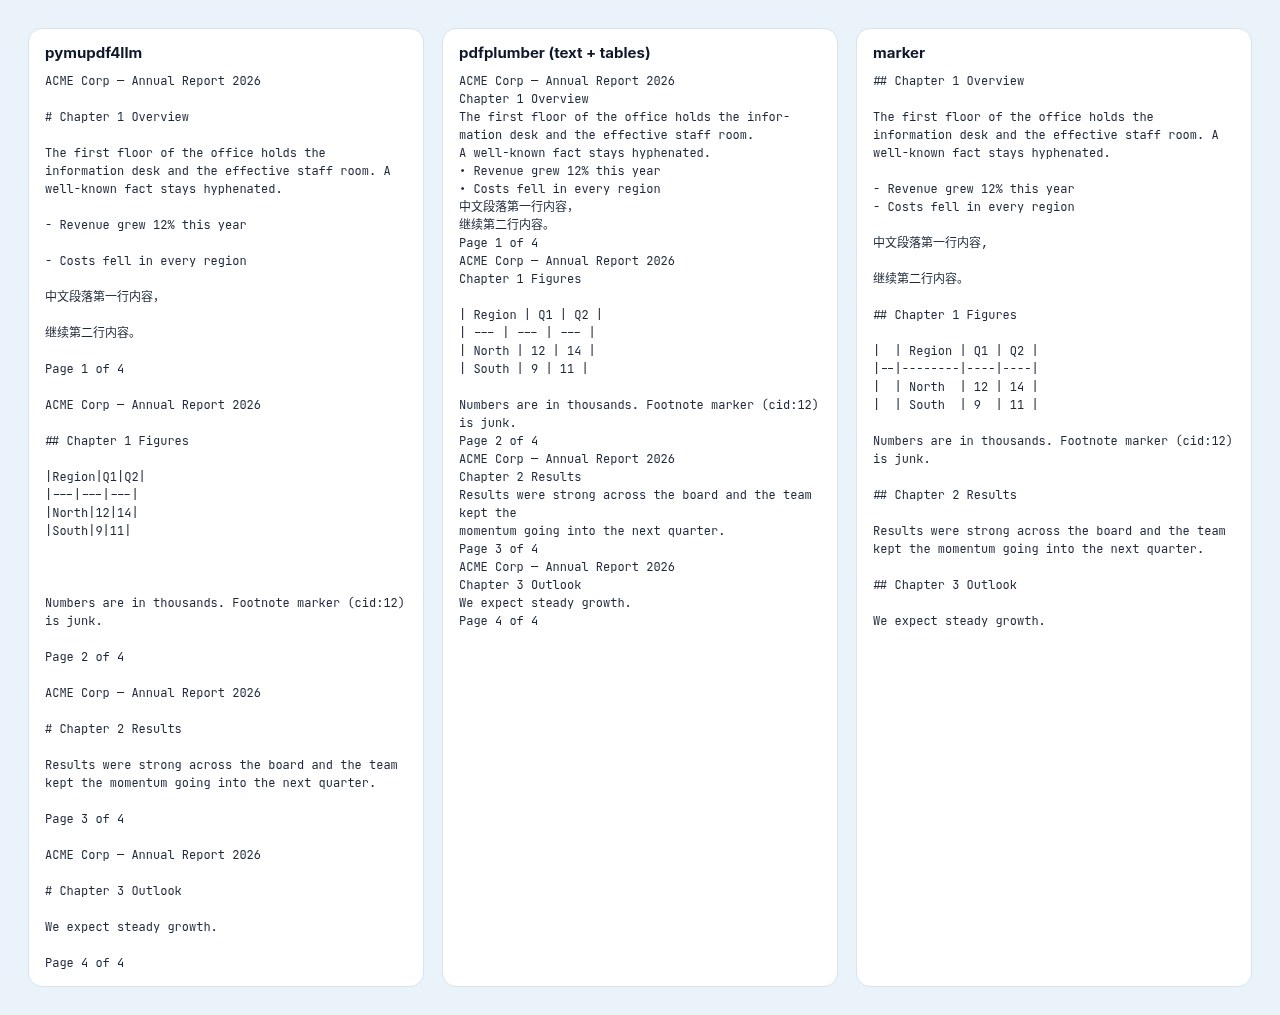
표: 테두리 있음, 없음, 병합 셀
| 예제 | pymupdf4llm | pdfplumber | marker |
|---|---|---|---|
| 테두리 있는 표 | 정확 | 정확 | 정확 |
| 오피스 내보내기 | 셀의 81% | 정확 | 셀의 94% |
| 테두리 없는 표 | 셀의 40% | 못 찾음 | 셀의 90% |
| 여러 줄 셀 | 정확 | 정확 | 셀의 83% |
| 테두리 없음, 여러 줄 | 못 찾음 | 못 찾음 | 셀의 83% |
| 오피스, 테두리 없음 | 못 찾음 | 못 찾음 | 못 찾음 |
| 본문 속 표 | 정확 | 못 찾음 | 정확 |
| 표 두 개 | 정확 | 셀의 33% | 정확 |
| 병합된 셀 | 셀의 83% | 정확 | 셀의 42% |
표에서는 PDF에 선이 그려져 있느냐에 따라 순위가 갈립니다. pdfplumber의 find_tables()는 그어진 선을 따라가기 때문에, 격자가 그려진 PDF라면 병합된 셀까지 정확합니다. 선이 없으면 아무것도 찾지 못했습니다. pymupdf4llm은 테두리 있는 표 대부분에서 정확했지만, 셀 안에 이스케이프되지 않은 |가 있는 오피스 표 하나를 깨뜨렸습니다. marker는 간단한 테두리 없는 예제 두 개를 셀의 83~90%까지 찾았고, pymupdf4llm은 하나를 40%, pdfplumber는 하나도 못 찾았습니다. 다만 병합 셀 예제에서 marker는 열을 합쳐 버렸습니다.
오피스에서 내보낸 테두리 없는 표는 세 라이브러리 모두 찾지 못했습니다. 표가 가장 중요하다면 PDF 표 변환 가이드에서 테두리 없는 표가 왜 어떤 도구에게나 어려운지 설명합니다.
중국어 텍스트: 글자 보존, 공백, 문장부호
| 라이브러리 | 중국어 글자 보존율 | 문장 안 공백 | 문장 안 줄바꿈 | 전각 쉼표 보존율 |
|---|---|---|---|---|
| pymupdf4llm | 100% | 159 | 0 | 100% |
| pdfplumber | 100% | 0 | 140 | 100% |
| marker (기본값) | 98.6% | 166 | 0 | 0% |
중국어 텍스트에서는 순위가 또 바뀝니다. 원본 PDF에는 문장 안에 공백이 하나도 없습니다. pymupdf4llm은 모든 글자와 전각 쉼표를 지켰지만 문장 안에 공백을 159개 끼워 넣었습니다. pdfplumber도 글자는 지켰지만 문장 중간에 줄바꿈을 140개 남겼습니다. marker는 일부 섹션 제목을 포함해 글자의 1.4%를 잃었고, 전각 쉼표를 모두 ASCII 쉼표로 바꿨으며, <sup> 태그를 152개 추가했습니다. 중국어 PDF에서는 marker 출력이 손볼 곳이 가장 많았습니다.
라이선스: AGPL, MIT, Apache, 그리고 모델 조건
- pdfplumber: LICENSE 파일에 따르면 MIT입니다. 라이선스 고지만 남기면 비공개·상업용 코드에도 쓸 수 있습니다.
- pymupdf4llm과 PyMuPDF: 저장소에는 GNU AGPL 3.0이 들어 있고, 패키지 메타데이터에는 "Dual Licensed - GNU AFFERO GPL 3.0 or Artifex Commercial License"라고 적혀 있습니다. 간단히 말해, 이것을 쓰는 프로그램을 배포하거나 수정한 버전을 네트워크로 사용자에게 제공하면, Artifex에서 상용 라이선스를 사지 않는 한 그 프로그램의 소스 코드를 같은 라이선스로 공개해야 합니다.
- marker: 코드는 Apache-2.0이지만 모델 가중치는 수정된 AI Pubs Open RAIL-M 라이선스입니다. MODEL_LICENSE에 따르면 연구, 개인 용도, 총매출이나 투자금이 500만 달러 미만인 조직은 무료이고, 그 이상이면 Datalab의 라이선스가 필요합니다.
라이선스가 결정 기준이라면, 대부분의 상업 팀에게 가벼운 두 라이브러리 사이의 진짜 선택지는 AGPL이냐 MIT냐이고, marker에는 매출 기준이 하나 더 붙습니다. 이 내용은 요약일 뿐 법률 자문이 아니니, 출시 전에 라이선스 파일을 직접 읽어 보세요.
출처
- PyMuPDF4LLM documentation — Artifex
- pymupdf4llm repository and licence — GitHub
- pdfplumber README and LICENSE.txt — GitHub
- marker README, LICENSE and MODEL_LICENSE — GitHub (Datalab)
- GNU Affero General Public License v3.0 — Free Software Foundation
- tiktoken — GitHub (OpenAI)
자주 묻는 질문
pymupdf4llm vs pdfplumber vs marker, 어느 것이 가장 좋나요?
저희 테스트에서는 일반 문서와 중국어 텍스트에는 pymupdf4llm, MIT 라이선스로 테두리 있는 표를 정확히 뽑으려면 pdfplumber, 테두리 없는 표와 머리글이 반복되는 페이지에는 marker가 나았습니다.
pymupdf4llm은 상업적으로 무료로 쓸 수 있나요?
AGPL에서는 가능합니다. 단, 프로그램을 배포하거나 서비스로 제공할 때 소스 코드도 공개해야 합니다. 그게 어렵다면 Artifex가 상용 라이선스를 판매합니다.
marker에 GPU가 필요한가요?
아니요. GPU 없는 8 vCPU 기기에서도 돌아갔지만, llama.cpp의 llama-server가 필요했고 가벼운 라이브러리보다 몇 배 느렸습니다.
pdfplumber로 Markdown을 만들 수 있나요?
바로는 안 됩니다. 텍스트, 단어, 선, 표를 돌려줄 뿐이라 Markdown은 이번 테스트에서처럼 직접 조립해야 합니다.
스캔한 PDF는 어떤 라이브러리가 처리하나요?
marker는 OCR 모델을 중심으로 만들어졌습니다. pymupdf4llm과 pdfplumber는 기본 설정에서 텍스트 레이어를 읽기 때문에, 스캔본은 빈 결과가 나옵니다.
이 테스트를 직접 다시 해 볼 수 있나요?
네. 스크립트, 버전, 하드웨어를 위에 적어 두었습니다. 다른 기기에서는 시간이 달라지겠지만 품질 결과는 같아야 합니다.