PyMuPDF4LLM・pdfplumber・Marker を実際のPDFで比較
執筆 pdftomd.tools チーム · 更新日 · 約9分で読めます
私たちのテストからの短い答え:AGPLライセンスが問題なければ、高速で見出しが最もきれいな pymupdf4llm が最良の第一候補です。MITの pdfplumber は罫線のある表で最も正確ですが、見出しは出力しません。marker は罫線なしの表に最も強く、ページの余計な要素も取り除きますが、CPUでは何倍も遅く、私たちの中国語テキストを壊しました。単発のファイルなら、PythonでPDFをMarkdownに変換するガイドでインストール不要の方法も紹介しています。
PyMuPDF4LLM・pdfplumber・Marker:結論
| 必要なもの | 選ぶもの | 理由 |
|---|---|---|
| 高速で見出しのある良いMarkdown | pymupdf4llm | 3つの文書すべてで、想定した見出しがすべて正しいレベルで出た |
| 罫線のある表の正確なセル、寛容なライセンス | pdfplumber | 罫線のある表と結合セルで完全一致。MITライセンス |
| 罫線なしの表、繰り返しヘッダーの除去 | marker | シンプルな罫線なしの例を2つとも検出。ヘッダーとページ番号を除去 |
| 中国語や日本語のテキスト | pymupdf4llm | すべての文字と句読点を保持。marker は文字を失った |
すべてのテストで勝ったライブラリはありません。この記事の残りでは各行の裏にある数字を示すので、手元にあるPDFに合わせて pymupdf4llm・pdfplumber・marker を比べられます。
テストの方法:ハードウェア、バージョン、文書
比較を公平にするため、どのライブラリにも同じマシンで同じファイルを渡しました。すべてCPUだけでのPDF解析です:Intel(R) Xeon(R) Processor、8 vCPU、RAM 16 GB、GPUなし、Linux 6.12.94+ x86_64、Python 3.13.5。バージョン:pymupdf4llm 1.28.2(PyMuPDF 1.28.2)、pdfplumber 0.11.9(pdfminer.six 20251230)、marker-pdf 2.0.0(surya-ocr 0.22.1、torch 2.14.1+cpu)。トークンは tiktoken 0.14.0 とエンコーディング o200k_base で数えました。テストは2026年10月19日に行いました。
- 文書: 見出し13個と表1個のある5ページの英語のガイド、見出し29個と表4個のある11ページの中国語のレポート、すべてのページに繰り返しのヘッダーとページ番号がある4ページの英語のレポート。
- 表のサンプル: 正しい表をセル単位で把握している1ページのPDF 11個。うち2個は表をまったく含みません。
- 設定: 各ライブラリの初期設定。pdfplumber にはMarkdown出力がないため、テキスト行と
find_tables()の結果を読む順に並べる約20行のコードを書きました。marker は初期設定(CPUでの標準である高速モード)と--disable_ocrの2通りで実行しました。 - 時間の計測: 3回の実行の中央値。marker のモデルは事前に1回読み込み(4.79秒)、ウォームアップの1回は除外しました。
import pymupdf4llm
md = pymupdf4llm.to_markdown("report.pdf")

import pdfplumber
with pdfplumber.open("report.pdf") as pdf:
    for page in pdf.pages:
        lines = page.extract_text_lines()
        tables = page.find_tables()

from marker.converters.pdf import PdfConverter
from marker.models import create_model_dict
from marker.output import text_from_rendered
converter = PdfConverter(artifact_dict=create_model_dict())
md, _, _ = text_from_rendered(converter("report.pdf"))CPUで marker 2.0 を動かすには、README によると別途インストールが必要な llama.cpp の llama-server バイナリも要り、初回の起動時に私たちのマシンでは約1.8 GBのモデルファイルをダウンロードしました。最初の2回の試行は失敗しました。1回目は torch と torchvision のバージョンの不一致、2回目は llama-server がなかったためです。どちらもライブラリの不具合ではなくセットアップの問題ですが、その時間は見込んでおいてください。
速度とトークン数
| ライブラリ | 英語のガイド(5ページ) | 中国語のレポート(11ページ) | 繰り返しヘッダー付きの英語レポート(4ページ) | トークン数(中国語のレポート) |
|---|---|---|---|---|
| pymupdf4llm | 0.693秒 | 1.419秒 | 0.387秒 | 8908 |
| pdfplumber | 0.713秒 | 3.579秒 | 0.023秒 | 8782 |
| marker(初期設定) | 3.354秒 | 4.563秒 | 2.325秒 | 10001 |
| marker(--disable_ocr) | 1.425秒 | 3.146秒 | 0.447秒 | 10001 |
pymupdf4llm・pdfplumber・marker の差が最も大きいのは速度です。pdfplumber は短いレポートで最速(0.023秒)でしたが、中国語のレポートでは軽量なツールの中で最も遅くなりました。pymupdf4llm は一貫して1ページあたり約0.1〜0.14秒でした。marker はモデルを読み込み済みでも、英語のガイドで pymupdf4llm の5倍遅く、--disable_ocr を付けると差は縮まりました。
軽量な2つのライブラリのトークン数は近い値でした。marker は中国語のレポートで約12%多くのトークンを出力し、その一部は <sup> タグと余分なスペースによるものでした。短いレポートでは、繰り返しのヘッダーを省いたため少なくなりました。
見出しとページの余計な要素
| ライブラリ | 英語のガイド(13) | 中国語のレポート(29) | 繰り返しヘッダー付きの英語レポート(4) |
|---|---|---|---|
| pymupdf4llm | 13(正しいレベル 13) | 29(正しいレベル 29) | 4(正しいレベル 4) |
| pdfplumber | 0(正しいレベル 0) | 0(正しいレベル 0) | 0(正しいレベル 0) |
| marker(初期設定) | 11(正しいレベル 4) | 23(正しいレベル 14) | 4(正しいレベル 3) |
| marker(--disable_ocr) | 11(正しいレベル 4) | 23(正しいレベル 14) | 4(正しいレベル 3) |
見出しは2つ目の大きな違いです。pymupdf4llm はすべての見出しを正しいレベルで見つけました。ガイドの太字のFAQの質問も見出しとして扱いましたが(6行)、これは役に立つこともあります。pdfplumber には見出しの概念がないので、平坦なテキストになります。marker はほとんどの見出しを見つけましたが、レベルが違うことがよくありました。
4ページのレポートでは、pymupdf4llm と pdfplumber は繰り返しヘッダー4個とページ番号4個をすべて残し、marker はどちらも取り除きました。pymupdf4llm と marker の違いが最もはっきり出た例です。marker のレイアウトモデルはヘッダーとは何かを知っていますが、軽量なライブラリは知りません。pdfplumber は行末でハイフン区切りされた単語もそのまま残しました。
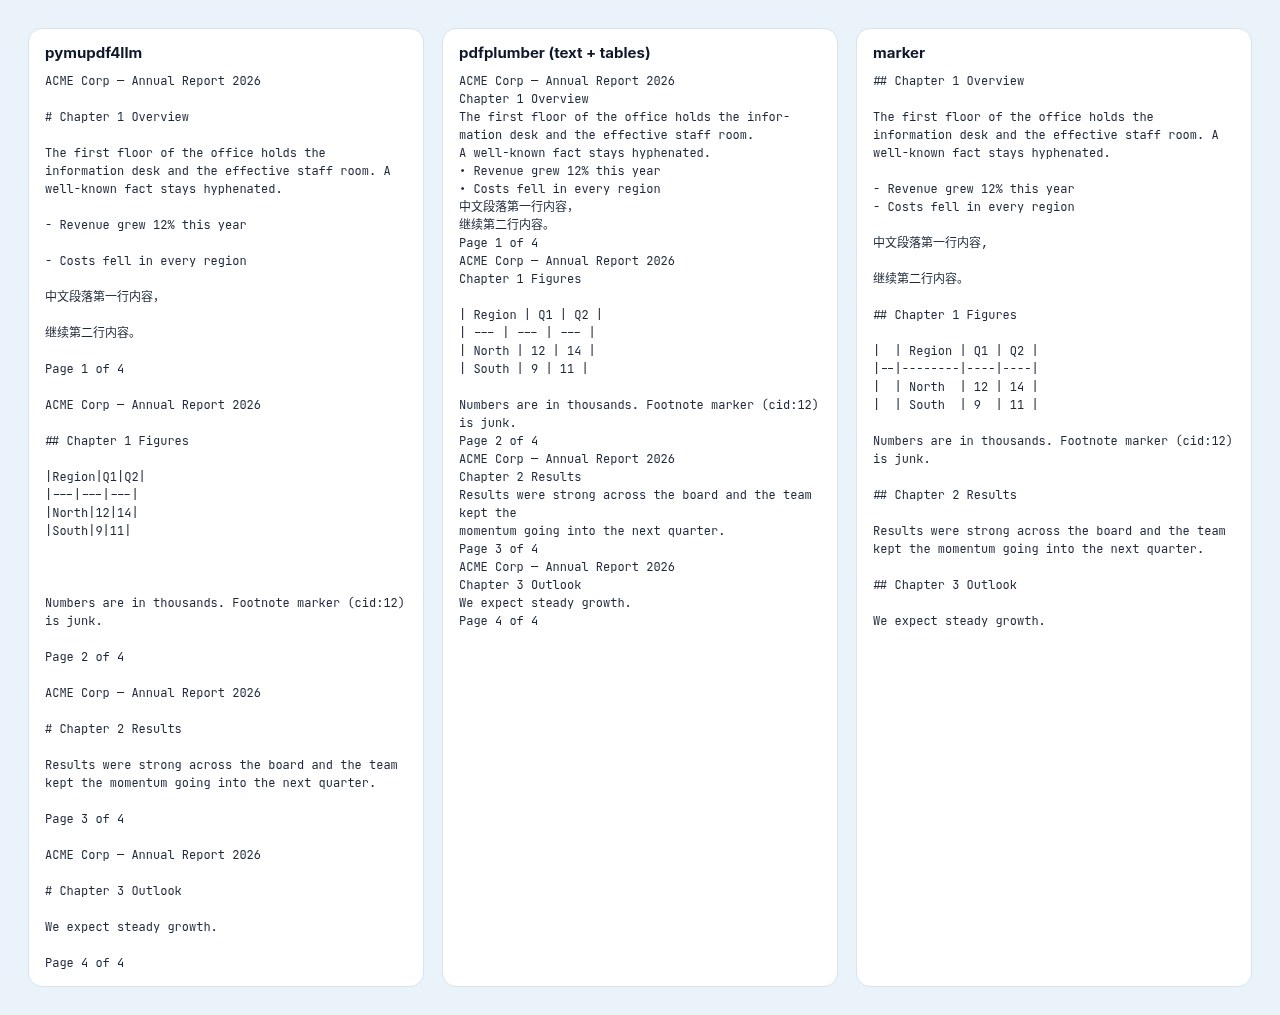
表:罫線あり、罫線なし、結合セル
| サンプル | pymupdf4llm | pdfplumber | marker |
|---|---|---|---|
| 罫線のある表 | 完全一致 | 完全一致 | 完全一致 |
| オフィスソフトの書き出し | セルの81% | 完全一致 | セルの94% |
| 罫線なし | セルの40% | 検出なし | セルの90% |
| 折り返しのあるセル | 完全一致 | 完全一致 | セルの83% |
| 罫線なし・折り返しあり | 検出なし | 検出なし | セルの83% |
| オフィスソフト・罫線なし | 検出なし | 検出なし | 検出なし |
| 本文中の表 | 完全一致 | 検出なし | 完全一致 |
| 2つの表 | 完全一致 | セルの33% | 完全一致 |
| 結合セル | セルの83% | 完全一致 | セルの42% |
表の順位は、PDFが線を描いているかどうかで決まります。PDFが罫線を描いていれば、find_tables() が線をたどるので、pdfplumber の表は結合セルを含めて完全に一致します。線がなければ何も見つかりませんでした。pymupdf4llm は罫線のある表のほとんどで完全一致でしたが、セルに | を含むオフィスソフトの表では、それをエスケープせずに表を崩しました。marker はシンプルな罫線なしの例を2つとも見つけてセルの83〜90%を再現し、pymupdf4llm は1つを40%で、pdfplumber は0個でした。ただし結合セルの例では、marker は列をまとめてしまいました。
オフィスソフトから書き出した罫線なしの表は、どのライブラリも認識できませんでした。表が目的なら、PDFの表のガイドで、罫線なしのレイアウトがどのツールにも難しい理由を説明しています。
中国語テキスト:網羅率、スペース、句読点
| ライブラリ | 中国語の文字の保持率 | 文中のスペース | 文中の改行 | 全角読点の保持率 |
|---|---|---|---|---|
| pymupdf4llm | 100% | 159 | 0 | 100% |
| pdfplumber | 100% | 0 | 140 | 100% |
| marker(初期設定) | 98.6% | 166 | 0 | 0% |
中国語のテキストでは、順位がまた入れ替わります。元のPDFには文中にスペースがありません。pymupdf4llm はすべての文字と全角の読点を残しましたが、文中に159個のスペースを入れました。pdfplumber も文字は残しましたが、文の途中に140個の改行が残りました。marker は文字の1.4%を失い、その中にはいくつかのセクション見出しも含まれていました。また全角の読点をすべてASCIIのカンマに変え、<sup> タグを152個追加しました。私たちのテストでは、中国語のPDFでは marker の出力に最も手直しが必要でした。
ライセンス:AGPL、MIT、Apache、そしてモデルの条件
- pdfplumber: LICENSEファイルによるとMITです。ライセンス表示を残せば、クローズドソースや商用のコードでも使えます。
- pymupdf4llm と PyMuPDF: リポジトリには GNU AGPL 3.0 が同梱され、パッケージのメタデータには「Dual Licensed - GNU AFFERO GPL 3.0 or Artifex Commercial License」とあります。簡単に言えば、これを使ったプログラムを配布したり、変更版をネットワーク越しにユーザーに提供したりする場合、Artifex から商用ライセンスを買わない限り、AGPLはそのプログラムのソースコードを同じライセンスで公開することを求めます。
- marker: コードは Apache-2.0 ですが、モデルの重みは独自に変更された AI Pubs Open RAIL-M ライセンスです。MODEL_LICENSE によると、重みは研究、個人利用、総収入または資金調達額が500万ドル未満の組織には無料で、それを超える場合は Datalab のライセンスが必要です。
ライセンスが決め手なら、多くの商用チームにとって、軽量な2つのライブラリの間の本当の選択は AGPL か MIT かであり、marker にはさらに収益の基準があります。これは要約であって法的助言ではありません。何かを公開する前に、ライセンスファイルを読んでください。
出典
- PyMuPDF4LLM documentation — Artifex
- pymupdf4llm repository and licence — GitHub
- pdfplumber README and LICENSE.txt — GitHub
- marker README, LICENSE and MODEL_LICENSE — GitHub (Datalab)
- GNU Affero General Public License v3.0 — Free Software Foundation
- tiktoken — GitHub (OpenAI)
よくある質問
pymupdf4llm・pdfplumber・marker のどれが最適ですか?
私たちのテストでは、一般的な文書と中国語のテキストには pymupdf4llm、MITで罫線のある表を正確に取り出すなら pdfplumber、罫線なしの表と繰り返しヘッダーのあるページには marker です。
pymupdf4llm は商用で無料で使えますか?
AGPLのもとでは、プログラムを配布したりサービスとして提供したりする際に自分のソースコードも公開するなら、使えます。そうでなければ、Artifex が商用ライセンスを販売しています。
marker にGPUは必要ですか?
いいえ。GPUなしの8 vCPUのマシンで動きましたが、llama.cpp の llama-server が必要で、軽量なライブラリより何倍も遅くなりました。
pdfplumber はMarkdownを出力できますか?
直接はできません。テキスト、単語、行、表を返すので、このテストで私たちがしたように、Markdownは自分で書きます。
スキャンしたPDFに対応しているのはどのライブラリですか?
marker はOCRモデルを中心に作られています。初期設定の pymupdf4llm と pdfplumber はテキスト層を読むので、スキャンは空になります。
このテストを再現できますか?
はい。スクリプト、バージョン、ハードウェアは上に記載しています。別のマシンでは時間は変わりますが、品質のスコアは変わらないはずです。