PyMuPDF4LLM vs pdfplumber vs Marker, getest op echte PDF's
Door pdftomd.tools-team · Bijgewerkt op · 8 min leestijd
Het korte antwoord uit onze tests: pymupdf4llm is de beste standaardkeuze, snel en met de netste koppen, als de AGPL-licentie voor jou werkt. pdfplumber, onder MIT, is het nauwkeurigst bij tabellen met randen, maar levert geen enkele kop. marker kan het best overweg met tabellen zonder randen en haalt overbodige paginaonderdelen weg, maar is op een CPU vele malen trager en beschadigde onze Chinese tekst. Voor één los bestand biedt onze handleiding PDF naar Markdown met Python ook een route zonder installatie.
PyMuPDF4LLM vs pdfplumber vs Marker: het oordeel
| Als je dit nodig hebt… | Kies | Waarom |
|---|---|---|
| Goede Markdown, snel, met koppen | pymupdf4llm | Alle verwachte koppen op het juiste niveau in alle drie de documenten |
| Exacte cellen in tabellen met randen, ruime licentie | pdfplumber | Exact bij rasters met randen en samengevoegde cellen; MIT-licentie |
| Tabellen zonder randen, geen herhaalde kopteksten | marker | Vond beide eenvoudige voorbeelden zonder randen; verwijderde kopteksten en paginanummers |
| Chinese of Japanse tekst | pymupdf4llm | Alle tekens en leestekens behouden; marker verloor tekens |
Geen enkele bibliotheek won elke test. De rest van dit artikel geeft de cijfers achter elke rij, zodat je met je eigen PDF's kunt kiezen tussen pymupdf4llm vs pdfplumber vs marker.
Hoe we testten: hardware, versies, documenten
Voor een eerlijke vergelijking kreeg elke bibliotheek dezelfde bestanden op dezelfde machine. Alle runs waren pure PDF-parsing op de CPU: Intel(R) Xeon(R) Processor, 8 vCPU, 16 GB RAM, geen GPU, Linux 6.12.94+ x86_64, Python 3.13.5. Versies: pymupdf4llm 1.28.2 (PyMuPDF 1.28.2), pdfplumber 0.11.9 (pdfminer.six 20251230), marker-pdf 2.0.0 (surya-ocr 0.22.1, torch 2.14.1+cpu). We telden tokens met tiktoken 0.14.0 en de codering o200k_base. De test liep op 19 oktober 2026.
- Documenten: een Engelse handleiding van 5 pagina's met 13 koppen en één tabel; een Chinees rapport van 11 pagina's met 29 koppen en 4 tabellen; een Engels rapport van 4 pagina's met op elke pagina dezelfde koptekst en een paginanummer.
- Tabelvoorbeelden: 11 PDF's van één pagina waarvan we de juiste tabellen cel voor cel kennen, waarvan twee zonder enige tabel.
- Instellingen: de standaardwaarden van elke bibliotheek. pdfplumber heeft geen Markdown-uitvoer, dus schreven we zo'n twintig regels die de tekstregels en de resultaten van
find_tables()in leesvolgorde zetten. marker draaide één keer met de standaardinstellingen (snelle modus, de standaard op CPU) en één keer met--disable_ocr. - Tijdmeting: de mediaan van drie runs. De modellen van marker werden vooraf één keer geladen (4,79 seconden) en één opwarmrun werd weggegooid.
import pymupdf4llm
md = pymupdf4llm.to_markdown("report.pdf")

import pdfplumber
with pdfplumber.open("report.pdf") as pdf:
    for page in pdf.pages:
        lines = page.extract_text_lines()
        tables = page.find_tables()

from marker.converters.pdf import PdfConverter
from marker.models import create_model_dict
from marker.output import text_from_rendered
converter = PdfConverter(artifact_dict=create_model_dict())
md, _, _ = text_from_rendered(converter("report.pdf"))Op een CPU heeft marker 2.0 ook een llama-server-binary van llama.cpp nodig, die je volgens de README apart installeert, en bij de eerste start downloadde het ongeveer 1,8 GB aan modelbestanden op onze machine. Onze eerste twee pogingen mislukten: één keer door niet-passende versies van torch en torchvision, één keer omdat llama-server ontbrak. Dat waren installatieproblemen, geen bugs in de bibliotheek, maar reken er wel tijd voor.
Snelheid en aantal tokens
| Bibliotheek | Engelse handleiding (5 p.) | Chinees rapport (11 p.) | Engels rapport met herhaalde koptekst (4 p.) | Tokens, Chinees rapport |
|---|---|---|---|---|
| pymupdf4llm | 0,693 s | 1,419 s | 0,387 s | 8908 |
| pdfplumber | 0,713 s | 3,579 s | 0,023 s | 8782 |
| marker (standaard) | 3,354 s | 4,563 s | 2,325 s | 10001 |
| marker (--disable_ocr) | 1,425 s | 3,146 s | 0,447 s | 10001 |
In snelheid verschillen pymupdf4llm vs pdfplumber vs marker het meest. pdfplumber was het snelst op het korte rapport (0,023 s), maar de traagste van de lichte tools op het Chinese rapport. pymupdf4llm bleef stabiel, rond 0,1 tot 0,14 seconde per pagina. marker was 5 keer trager dan pymupdf4llm op de Engelse handleiding, terwijl de modellen al geladen waren; met --disable_ocr werd het verschil kleiner.
De tokenaantallen van de twee lichte bibliotheken lagen dicht bij elkaar. marker leverde op het Chinese rapport ongeveer 12% meer tokens op, deels door <sup>-tags en extra spaties, en minder op het korte rapport, omdat het de herhaalde kopteksten weghaalde.
Koppen en overbodige paginaonderdelen
| Bibliotheek | Engelse handleiding (13) | Chinees rapport (29) | Engels rapport met herhaalde koptekst (4) |
|---|---|---|---|
| pymupdf4llm | 13 (13 op het juiste niveau) | 29 (29 op het juiste niveau) | 4 (4 op het juiste niveau) |
| pdfplumber | 0 (0 op het juiste niveau) | 0 (0 op het juiste niveau) | 0 (0 op het juiste niveau) |
| marker (standaard) | 11 (4 op het juiste niveau) | 23 (14 op het juiste niveau) | 4 (3 op het juiste niveau) |
| marker (--disable_ocr) | 11 (4 op het juiste niveau) | 23 (14 op het juiste niveau) | 4 (3 op het juiste niveau) |
Koppen zijn het tweede grote verschil. pymupdf4llm vond elke kop op het juiste niveau. Het markeerde ook de vetgedrukte FAQ-vragen in de handleiding als kop (6 regels), wat handig kan zijn. pdfplumber kent geen koppen: je krijgt platte tekst. marker vond de meeste koppen, maar vaak op het verkeerde niveau.
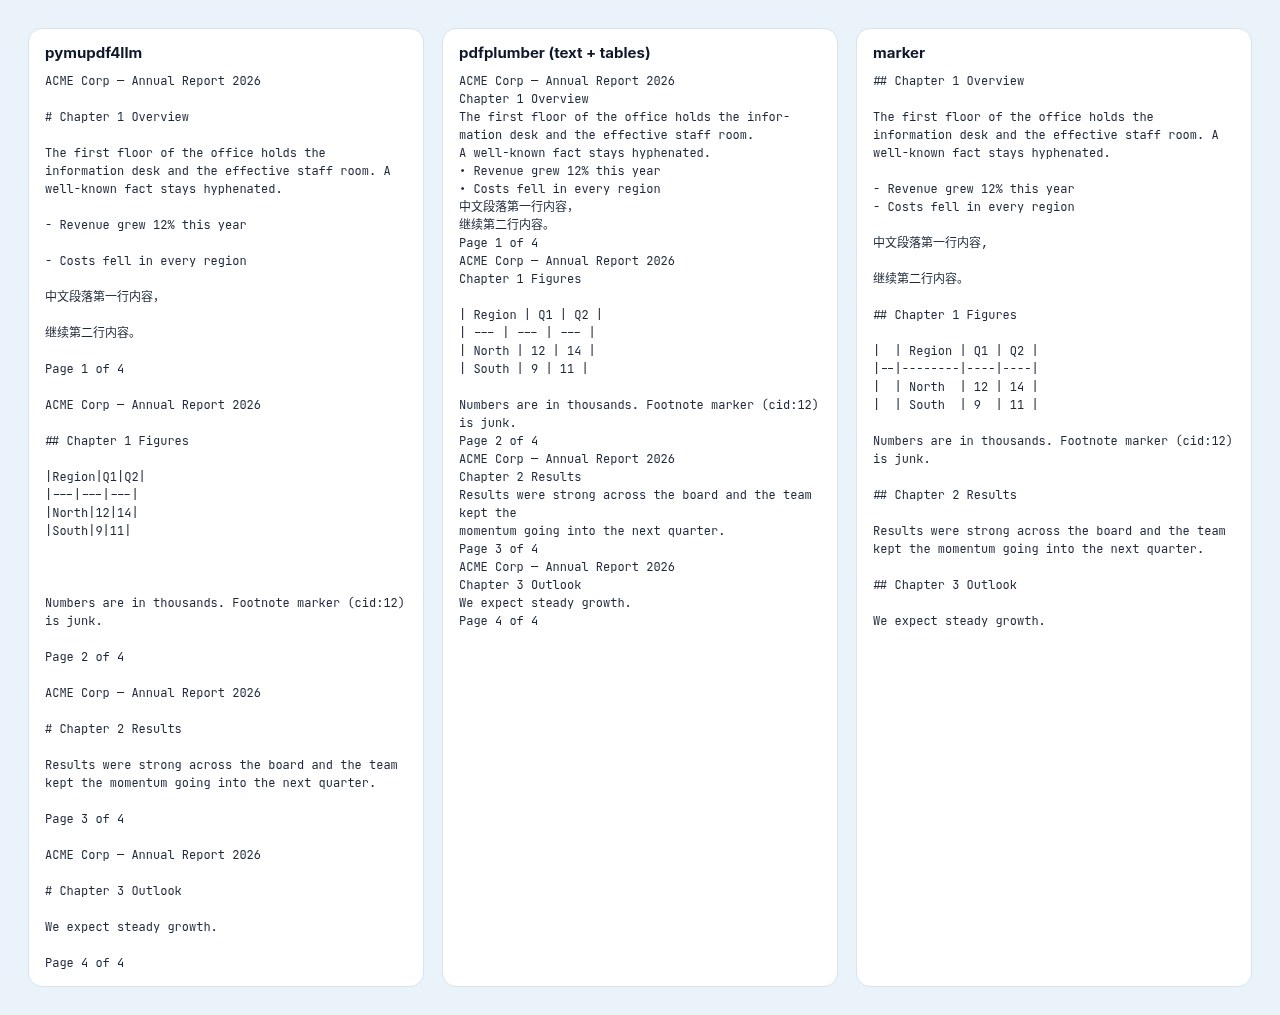
In het rapport van 4 pagina's hielden pymupdf4llm en pdfplumber alle 4 kopieën van de herhaalde koptekst en alle 4 paginanummers; marker haalde beide weg. Dat is het duidelijkste geval van pymupdf4llm vs marker: het lay-outmodel van marker weet wat een koptekst is, de lichte bibliotheken niet. pdfplumber liet ook een afgebroken woord aan het eind van een regel staan.
Tabellen: met randen, zonder randen, samengevoegd
| Voorbeeld | pymupdf4llm | pdfplumber | marker |
|---|---|---|---|
| Raster met randen | exact | exact | exact |
| Office-export | 81% van de cellen | exact | 94% van de cellen |
| Zonder randen | 40% van de cellen | niet gevonden | 90% van de cellen |
| Cellen met meerdere regels | exact | exact | 83% van de cellen |
| Zonder randen, meerdere regels | niet gevonden | niet gevonden | 83% van de cellen |
| Office, zonder randen | niet gevonden | niet gevonden | niet gevonden |
| Tabel tussen tekst | exact | niet gevonden | exact |
| Twee tabellen | exact | 33% van de cellen | exact |
| Samengevoegde cellen | 83% van de cellen | exact | 42% van de cellen |
Bij tabellen hangt de volgorde af van de vraag of de PDF lijnen tekent. De tabellen van pdfplumber zijn exact als de PDF het raster tekent, ook met samengevoegde cellen, omdat find_tables() de lijnen volgt. Zonder lijnen vond het niets. pymupdf4llm was exact bij de meeste tabellen met randen, maar brak een Office-tabel waarvan een cel een niet-ge-escapete | bevatte. marker vond beide eenvoudige voorbeelden zonder randen met 83–90% van de cellen, waar pymupdf4llm er één vond met 40% en pdfplumber geen; bij het voorbeeld met samengevoegde cellen voegde marker wel kolommen samen.
Geen enkele bibliotheek herkende de randloze tabel uit een Office-export. Zijn tabellen je prioriteit, dan legt onze gids voor PDF-tabellen uit waarom randloze lay-outs voor elk hulpmiddel lastig zijn.
Chinese tekst: dekking, spaties, leestekens
| Bibliotheek | Chinese tekens behouden | Spaties binnen zinnen | Regeleinden binnen zinnen | Volbreedte-komma's behouden |
|---|---|---|---|---|
| pymupdf4llm | 100% | 159 | 0 | 100% |
| pdfplumber | 100% | 0 | 140 | 100% |
| marker (standaard) | 98,6% | 166 | 0 | 0% |
Chinese tekst gooit de volgorde opnieuw om. De bron-PDF heeft geen spaties binnen zinnen. pymupdf4llm hield elk teken en elke volbreedte-komma, maar voegde 159 spaties binnen zinnen in. pdfplumber hield de tekens ook, maar liet 140 regeleinden midden in zinnen staan. marker verloor 1,4% van de tekens, waaronder enkele sectiekoppen, verving elke volbreedte-komma door een ASCII-komma en voegde 152 <sup>-tags toe. Bij Chinese PDF's vroeg de uitvoer van marker in onze tests het meeste nawerk.
Licenties: AGPL vs MIT vs Apache, plus de modelvoorwaarden
- pdfplumber: MIT, volgens het LICENSE-bestand. Je mag het gebruiken in gesloten en commerciële code, zolang je de licentievermelding behoudt.
- pymupdf4llm en PyMuPDF: de repositories bevatten de GNU AGPL 3.0 en de pakketmetadata vermelden "Dual Licensed - GNU AFFERO GPL 3.0 or Artifex Commercial License". Kort gezegd: als je een programma verspreidt dat erop leunt, of een aangepaste versie via een netwerk aan gebruikers aanbiedt, verwacht de AGPL dat je de broncode van dat programma onder dezelfde licentie deelt, tenzij je een commerciële licentie bij Artifex koopt.
- marker: de code is Apache-2.0, maar de modelgewichten vallen onder een aangepaste AI Pubs Open RAIL-M-licentie. Volgens MODEL_LICENSE zijn de gewichten gratis voor onderzoek, persoonlijk gebruik en organisaties onder 5 miljoen dollar bruto-omzet of financiering; daarboven heb je een licentie van Datalab nodig.
Als de licentie de doorslag geeft, is AGPL vs MIT voor de meeste commerciële teams de echte keuze tussen de twee lichte bibliotheken, en marker voegt een omzetdrempel toe. Dit is een samenvatting, geen juridisch advies; lees de licentiebestanden voordat je iets uitbrengt.
Bronnen
- PyMuPDF4LLM documentation — Artifex
- pymupdf4llm repository and licence — GitHub
- pdfplumber README and LICENSE.txt — GitHub
- marker README, LICENSE and MODEL_LICENSE — GitHub (Datalab)
- GNU Affero General Public License v3.0 — Free Software Foundation
- tiktoken — GitHub (OpenAI)
Veelgestelde vragen
Welke is het best: pymupdf4llm vs pdfplumber vs marker?
In onze tests pymupdf4llm voor gewone documenten en Chinese tekst, pdfplumber voor exacte tabellen met randen onder MIT, en marker voor tabellen zonder randen en pagina's met herhaalde kopteksten.
Is pymupdf4llm gratis voor commercieel gebruik?
Onder de AGPL wel, als je ook je eigen broncode publiceert wanneer je het programma verspreidt of als dienst aanbiedt. Anders verkoopt Artifex een commerciële licentie.
Heeft marker een GPU nodig?
Nee. Het draaide op onze machine met 8 vCPU zonder GPU, maar had llama-server van llama.cpp nodig en was vele malen trager dan de lichte bibliotheken.
Kan pdfplumber Markdown maken?
Niet direct. Het levert tekst, woorden, lijnen en tabellen; de Markdown schrijf je zelf, zoals wij voor deze test deden.
Welke bibliotheek kan gescande PDF's aan?
marker is gebouwd rond OCR-modellen. Met de standaardinstellingen lezen pymupdf4llm en pdfplumber de tekstlaag, dus een scan blijft leeg.
Kan ik deze test herhalen?
Ja. Script, versies en hardware staan hierboven; de tijden verschillen op een andere machine, de kwaliteitsresultaten zouden dat niet moeten doen.