PyMuPDF4LLM vs pdfplumber vs Marker, testés sur de vrais PDF
Par Équipe pdftomd.tools · Mis à jour le · 9 min de lecture
La réponse courte de nos tests : pymupdf4llm est le meilleur choix par défaut, rapide et avec les titres les plus propres, si la licence AGPL vous convient. pdfplumber, sous MIT, est le plus précis sur les tableaux à bordures mais ne produit aucun titre. marker gère le mieux les tableaux sans bordures et retire le superflu des pages, mais il est plusieurs fois plus lent sur CPU et a abîmé notre texte chinois. Pour un fichier isolé, notre guide PDF en Markdown avec Python propose aussi une voie sans installation.
PyMuPDF4LLM vs pdfplumber vs Marker : le verdict
| Si vous avez besoin de… | Choisissez | Pourquoi |
|---|---|---|
| Un bon Markdown, vite, avec les titres | pymupdf4llm | Tous les titres attendus au bon niveau dans les trois documents |
| Des cellules exactes de tableaux à bordures, licence permissive | pdfplumber | Exact sur les grilles à bordures et les cellules fusionnées ; licence MIT |
| Des tableaux sans bordures, sans en-têtes répétés | marker | A trouvé les deux exemples simples sans bordures ; a retiré en-têtes et numéros de page |
| Du texte chinois ou japonais | pymupdf4llm | Tous les caractères et la ponctuation conservés ; marker a perdu des caractères |
Aucune bibliothèque n'a gagné tous les tests. La suite de l'article donne les chiffres derrière chaque ligne, pour que vous puissiez trancher entre pymupdf4llm vs pdfplumber vs marker avec les PDF que vous avez réellement.
Comment nous avons testé : matériel, versions, documents
Pour un comparatif équitable, chaque bibliothèque a reçu les mêmes fichiers sur la même machine. Tous les passages étaient de la pure analyse de PDF sur CPU : Intel(R) Xeon(R) Processor, 8 vCPU, 16 Go de RAM, sans GPU, Linux 6.12.94+ x86_64, Python 3.13.5. Versions : pymupdf4llm 1.28.2 (PyMuPDF 1.28.2), pdfplumber 0.11.9 (pdfminer.six 20251230), marker-pdf 2.0.0 (surya-ocr 0.22.1, torch 2.14.1+cpu). Nous avons compté les tokens avec tiktoken 0.14.0 et l'encodage o200k_base. Le test a eu lieu le 19 octobre 2026.
- Documents : un guide anglais de 5 pages avec 13 titres et un tableau ; un rapport chinois de 11 pages avec 29 titres et 4 tableaux ; un rapport anglais de 4 pages avec un en-tête et un numéro de page répétés sur chaque page.
- Exemples de tableaux : 11 PDF d'une page dont nous connaissons les tableaux corrects cellule par cellule, dont deux sans aucun tableau.
- Réglages : les valeurs par défaut de chaque bibliothèque. pdfplumber n'a pas de sortie Markdown ; nous avons donc écrit une vingtaine de lignes qui remettent ses lignes de texte et les résultats de
find_tables()dans l'ordre de lecture. marker a tourné une fois avec ses réglages par défaut (mode rapide, son défaut sur CPU) et une fois avec--disable_ocr. - Chronométrage : la médiane de trois passages. Les modèles de marker ont été chargés une fois au préalable (4,79 secondes), et un passage de chauffe a été écarté.
import pymupdf4llm
md = pymupdf4llm.to_markdown("report.pdf")

import pdfplumber
with pdfplumber.open("report.pdf") as pdf:
    for page in pdf.pages:
        lines = page.extract_text_lines()
        tables = page.find_tables()

from marker.converters.pdf import PdfConverter
from marker.models import create_model_dict
from marker.output import text_from_rendered
converter = PdfConverter(artifact_dict=create_model_dict())
md, _, _ = text_from_rendered(converter("report.pdf"))Sur CPU, marker 2.0 a aussi besoin d'un binaire llama-server issu de llama.cpp, à installer séparément selon son README, et au premier lancement il a téléchargé environ 1,8 Go de fichiers de modèles sur notre machine. Nos deux premières tentatives ont échoué : une fois à cause de versions incompatibles de torch et torchvision, une fois parce que llama-server manquait. C'étaient des problèmes d'installation, pas des bugs de la bibliothèque, mais prévoyez du temps pour cela.
Vitesse et nombre de tokens
| Bibliothèque | Guide en anglais (5 p.) | Rapport en chinois (11 p.) | Rapport anglais à en-têtes répétés (4 p.) | Tokens, rapport chinois |
|---|---|---|---|---|
| pymupdf4llm | 0,693 s | 1,419 s | 0,387 s | 8908 |
| pdfplumber | 0,713 s | 3,579 s | 0,023 s | 8782 |
| marker (par défaut) | 3,354 s | 4,563 s | 2,325 s | 10001 |
| marker (--disable_ocr) | 1,425 s | 3,146 s | 0,447 s | 10001 |
C'est sur la vitesse que pymupdf4llm vs pdfplumber vs marker diffèrent le plus. pdfplumber a été le plus rapide sur le rapport court (0,023 s), mais le plus lent des outils légers sur le rapport chinois. pymupdf4llm est resté stable, autour de 0,1 à 0,14 seconde par page. marker a été 5 fois plus lent que pymupdf4llm sur le guide anglais, alors que ses modèles étaient déjà chargés ; avec --disable_ocr, l'écart s'est réduit.
Les nombres de tokens des deux bibliothèques légères étaient proches. marker a produit environ 12 % de tokens en plus sur le rapport chinois, en partie à cause de balises <sup> et d'espaces supplémentaires, et moins sur le rapport court, parce qu'il a supprimé les en-têtes répétés.
Titres et superflu des pages
| Bibliothèque | Guide en anglais (13) | Rapport en chinois (29) | Rapport anglais à en-têtes répétés (4) |
|---|---|---|---|
| pymupdf4llm | 13 (13 au bon niveau) | 29 (29 au bon niveau) | 4 (4 au bon niveau) |
| pdfplumber | 0 (0 au bon niveau) | 0 (0 au bon niveau) | 0 (0 au bon niveau) |
| marker (par défaut) | 11 (4 au bon niveau) | 23 (14 au bon niveau) | 4 (3 au bon niveau) |
| marker (--disable_ocr) | 11 (4 au bon niveau) | 23 (14 au bon niveau) | 4 (3 au bon niveau) |
Les titres sont la deuxième grande différence. pymupdf4llm a trouvé chaque titre au bon niveau. Il a aussi marqué comme titres les questions de FAQ en gras du guide (6 lignes), ce qui peut être utile. pdfplumber ne connaît pas les titres : vous obtenez du texte à plat. marker a trouvé la plupart des titres, mais souvent au mauvais niveau.
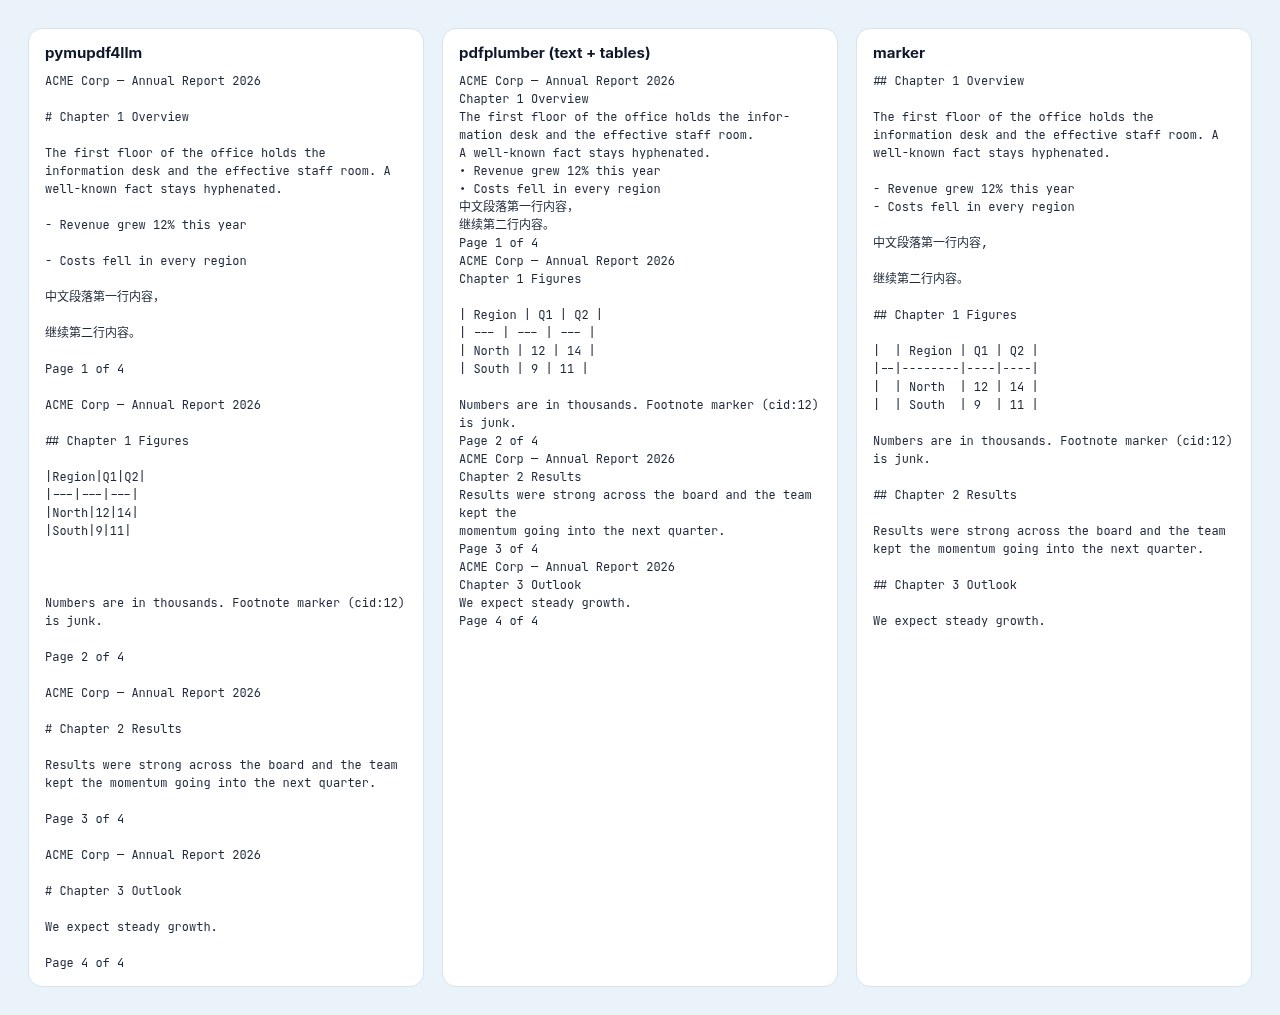
Sur le rapport de 4 pages, pymupdf4llm et pdfplumber ont gardé les 4 copies de l'en-tête répété et les 4 numéros de page ; marker a retiré les deux. C'est le cas le plus net pour pymupdf4llm vs marker : le modèle de mise en page de marker sait ce qu'est un en-tête, les bibliothèques légères non. pdfplumber a aussi laissé un mot coupé en fin de ligne.
Tableaux : à bordures, sans bordures, fusionnés
| Exemple | pymupdf4llm | pdfplumber | marker |
|---|---|---|---|
| Grille à bordures | exact | exact | exact |
| Export bureautique | 81 % des cellules | exact | 94 % des cellules |
| Sans bordures | 40 % des cellules | non trouvé | 90 % des cellules |
| Cellules sur plusieurs lignes | exact | exact | 83 % des cellules |
| Sans bordures, sur plusieurs lignes | non trouvé | non trouvé | 83 % des cellules |
| Bureautique, sans bordures | non trouvé | non trouvé | non trouvé |
| Tableau dans le texte | exact | non trouvé | exact |
| Deux tableaux | exact | 33 % des cellules | exact |
| Cellules fusionnées | 83 % des cellules | exact | 42 % des cellules |
Pour les tableaux, le classement dépend de la présence de traits dans le PDF. Les tableaux de pdfplumber sont exacts quand le PDF dessine ses lignes de grille, y compris avec des cellules fusionnées, parce que find_tables() suit les traits. Sans traits, il n'a rien trouvé. pymupdf4llm était exact sur la plupart des tableaux à bordures, mais a cassé un tableau bureautique dont une cellule contenait un | non échappé. marker a trouvé les deux exemples simples sans bordures avec 83 à 90 % des cellules, là où pymupdf4llm en a trouvé un avec 40 % et pdfplumber aucun ; dans l'exemple à cellules fusionnées, marker a toutefois fusionné des colonnes.
Aucune bibliothèque n'a détecté le tableau sans bordures d'un export bureautique. Si les tableaux sont votre priorité, notre guide des tableaux PDF explique pourquoi les mises en page sans bordures sont difficiles pour tous les outils.
Texte chinois : couverture, espaces, ponctuation
| Bibliothèque | Caractères chinois conservés | Espaces dans les phrases | Retours à la ligne dans les phrases | Virgules pleine chasse conservées |
|---|---|---|---|---|
| pymupdf4llm | 100 % | 159 | 0 | 100 % |
| pdfplumber | 100 % | 0 | 140 | 100 % |
| marker (par défaut) | 98,6 % | 166 | 0 | 0 % |
Le texte chinois rebat encore les cartes. Le PDF source n'a aucune espace à l'intérieur de ses phrases. pymupdf4llm a gardé chaque caractère et chaque virgule pleine chasse, mais a inséré 159 espaces dans des phrases. pdfplumber a aussi gardé les caractères, mais a laissé 140 retours à la ligne au milieu de phrases. marker a perdu 1,4 % des caractères, dont quelques titres de section, a remplacé chaque virgule pleine chasse par une virgule ASCII et a ajouté 152 balises <sup>. Sur les PDF chinois, c'est la sortie de marker qui a demandé le plus de reprises dans nos tests.
Licences : AGPL vs MIT vs Apache, plus les conditions des modèles
- pdfplumber : MIT, selon son fichier LICENSE. Vous pouvez l'utiliser dans du code propriétaire et commercial tant que la mention de licence est conservée.
- pymupdf4llm et PyMuPDF : les dépôts fournissent la GNU AGPL 3.0, et les métadonnées du paquet indiquent « Dual Licensed - GNU AFFERO GPL 3.0 or Artifex Commercial License ». En bref : si vous distribuez un programme qui s'appuie dessus, ou si vous mettez une version modifiée à disposition d'utilisateurs via un réseau, l'AGPL attend que vous partagiez le code source de ce programme sous la même licence, sauf si vous achetez une licence commerciale à Artifex.
- marker : le code est sous Apache-2.0, mais les poids des modèles sont sous une licence AI Pubs Open RAIL-M modifiée. Selon MODEL_LICENSE, les poids sont libres pour la recherche, l'usage personnel et les organisations sous 5 M$ de chiffre d'affaires brut ou de financement ; au-delà, il faut une licence de Datalab.
Si la licence décide pour vous, AGPL vs MIT est le vrai choix entre les deux bibliothèques légères pour la plupart des équipes commerciales, et marker ajoute un seuil de chiffre d'affaires. Ceci est un résumé, pas un conseil juridique ; lisez les fichiers de licence avant de publier quoi que ce soit.
Sources
- PyMuPDF4LLM documentation — Artifex
- pymupdf4llm repository and licence — GitHub
- pdfplumber README and LICENSE.txt — GitHub
- marker README, LICENSE and MODEL_LICENSE — GitHub (Datalab)
- GNU Affero General Public License v3.0 — Free Software Foundation
- tiktoken — GitHub (OpenAI)
FAQ
Lequel est le meilleur : pymupdf4llm vs pdfplumber vs marker ?
Dans nos tests, pymupdf4llm pour les documents courants et le texte chinois, pdfplumber pour des tableaux à bordures exacts sous MIT, et marker pour les tableaux sans bordures et les pages à en-têtes répétés.
pymupdf4llm est-il gratuit pour un usage commercial ?
Sous l'AGPL, oui, si vous publiez aussi votre code source dès que vous distribuez le programme ou le proposez comme service. Sinon, Artifex vend une licence commerciale.
marker a-t-il besoin d'un GPU ?
Non. Il a tourné sur notre machine à 8 vCPU sans GPU, mais il lui fallait llama-server de llama.cpp et il était plusieurs fois plus lent que les bibliothèques légères.
pdfplumber peut-il produire du Markdown ?
Pas directement. Il renvoie du texte, des mots, des lignes et des tableaux ; le Markdown, vous l'écrivez vous-même, comme nous l'avons fait pour ce test.
Quelle bibliothèque gère les PDF scannés ?
marker est construit autour de modèles OCR. Avec leurs réglages par défaut, pymupdf4llm et pdfplumber lisent la couche texte, donc un scan reste vide.
Puis-je refaire ce test ?
Oui. Le script, les versions et le matériel sont indiqués plus haut ; les temps varieront sur une autre machine, les résultats de qualité ne devraient pas.