Extraction avec structure
Convertisseur PDF en MD en ligne
Mis à jour le · Équipe pdftomd.tools
Un convertisseur PDF en MD transforme un PDF à couche texte en Markdown qui arrive déjà avec son plan. Celui-ci analyse la taille des caractères et les puces pour reconstruire titres, listes et paragraphes. Vous modifiez donc le contenu au lieu de retaper la structure.
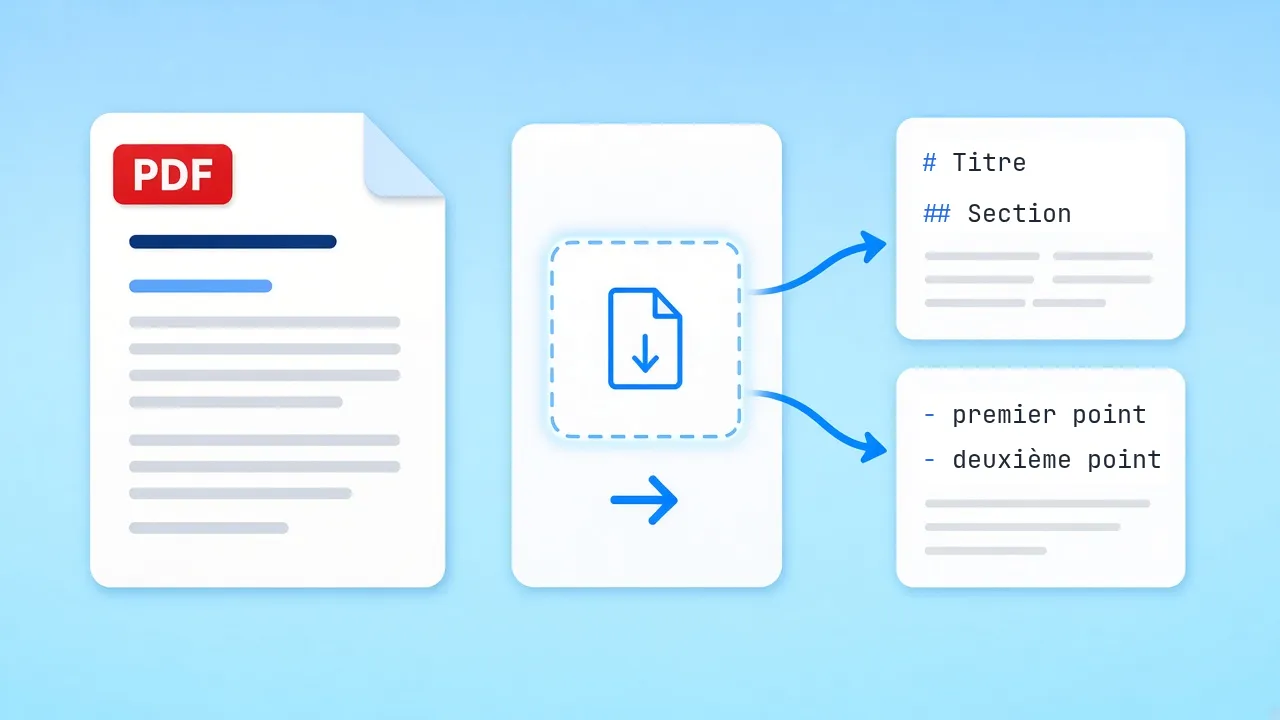
Le convertisseur PDF en MD ci-dessous traite un fichier à la fois. Déposez le document, lisez l’aperçu du PDF en MD, puis copiez-le ou enregistrez-le en .md. Tout se passe dans cet onglet.
PDF source
Déposez un PDF ici ou cliquez pour choisir
PDF avec texte uniquement. Les scans demanderaient de l’OCR, ce que cet outil ne fait pas.
Aperçu Markdown
Le Markdown apparaîtra ici.
Comment le convertisseur PDF en MD lit une page
Quatre passes de PDF en MD tournent dans le navigateur dès qu’un fichier arrive.
 01
Charger la couche texte
pdf.js ouvre le fichier en local et lit chaque fragment de texte avec sa position et sa taille. Aucun pixel n’est deviné : le passage du PDF en MD ne fonctionne donc que là où il y a du vrai texte.
Déposer un fichier 02
Former les lignes
Les fragments posés sur la même ligne de base sont réunis en lignes, puis les lignes sont rangées dans l’ordre de lecture, de haut en bas.
Voir en action 03
Repérer la structure
Les lignes nettement plus grandes deviennent des titres, sur quatre niveaux au plus. Les puces et les numéros deviennent des éléments de liste, les lignes alignées en colonnes un tableau, et le reste forme des paragraphes.
Vérifier l’aperçu 04
Écrire le Markdown
Les pages sont assemblées en un fichier propre, et un paragraphe coupé par un saut de page est recollé. Vous copiez ou téléchargez le résultat en un clic.
Copier ou télécharger
Ce qu’un convertisseur PDF en MD doit conserver
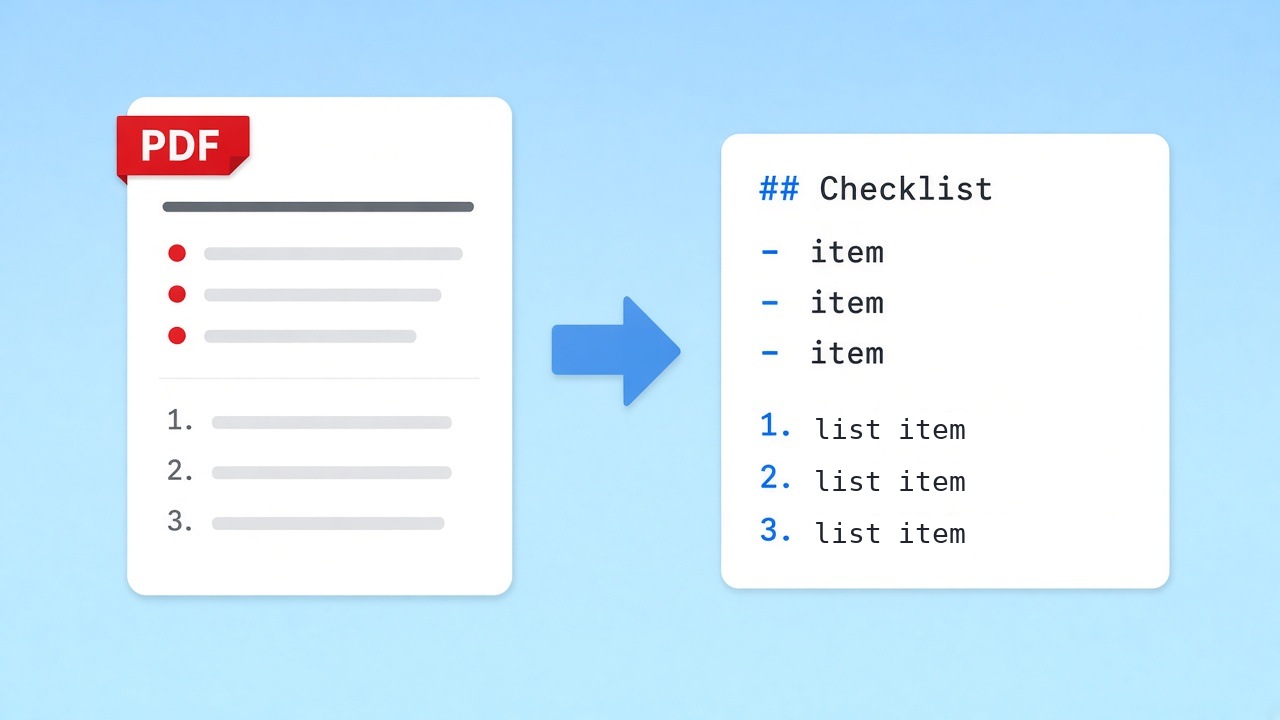
On juge un convertisseur PDF en MD au plan qu’il rend. Un PDF, décrit par la norme ISO 32000, stocke les mots comme des fragments positionnés, pas comme des titres et des listes. Un simple copier-coller donne donc un long mur de texte, et c’est pour cela que le passage du PDF en MD demande une détection de structure. Notre convertisseur reconstruit la hiérarchie à partir d’indices visuels : taille relative pour les titres, symboles en début de ligne pour les puces, chiffres suivis d’un point ou d’une parenthèse pour les étapes numérotées.
La sortie est volontairement du CommonMark sobre. Les titres utilisent #, les listes - ou 1., et les paragraphes sont séparés par des lignes vides. Le fichier reste ainsi agréable pour les diffs Git, les générateurs de sites statiques et les applications de notes. Les lignes courtes en majuscules sont traitées comme des titres de section.
- Titres sur quatre niveaux au plus, d’après la taille relative
- Listes à puces et numérotées, d’après leurs marqueurs
- Tableaux en GitHub Flavored Markdown
- Paragraphes recollés par-dessus les limites de page
Là où le PDF en MD demande encore un œil humain
Les tableaux reviennent en GitHub Flavored Markdown quand leurs colonnes sont alignées ou tracées avec des filets ; la première ligne devient l’en-tête. Les cellules fusionnées sont séparées, les tableaux pivotés retombent en lignes simples. Le gras, l’italique et les liens deviennent du texte simple, les images sont ignorées. Les mises en page à deux colonnes peuvent mélanger les lignes, et les pages scannées n’ont aucune couche texte : le convertisseur vous prévient alors.
Qui utilise un convertisseur PDF en MD
Des documents longs et structurés, où le PDF en MD vaut le coup.
Lire des articles scientifiques
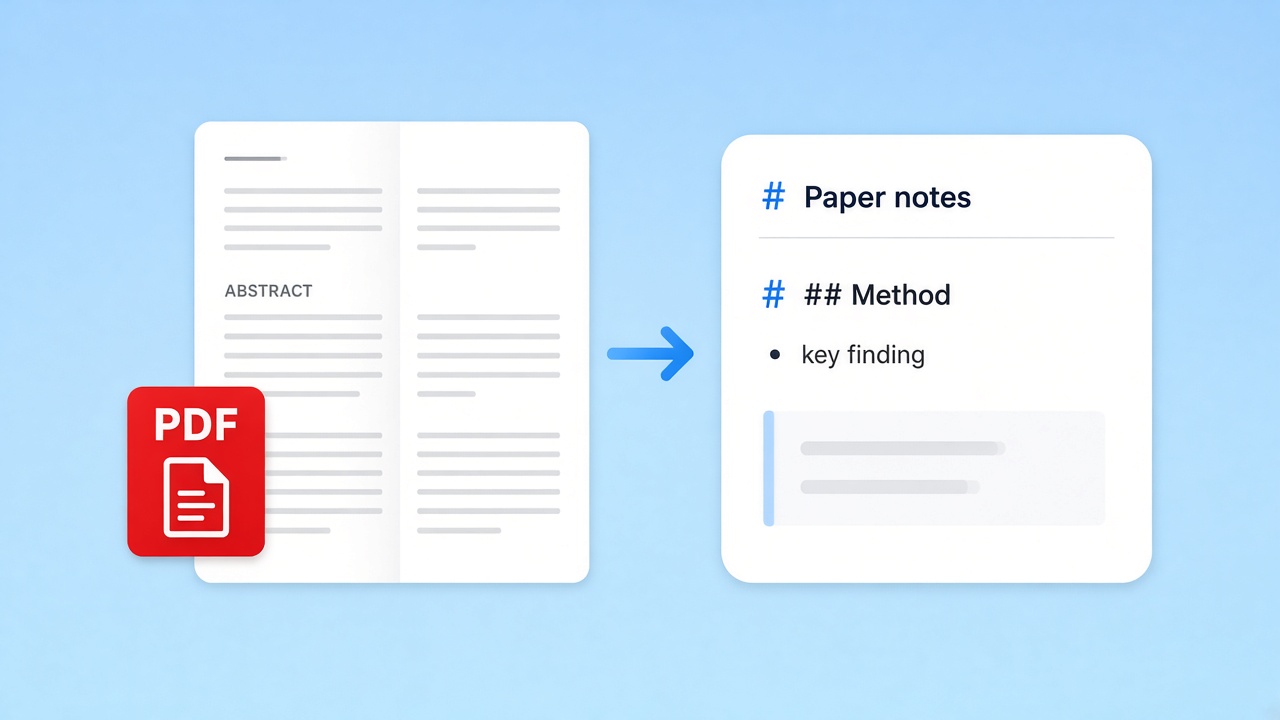
Passez un article dans le convertisseur, gardez son plan et annotez le Markdown dans votre application de notes au lieu d’une visionneuse verrouillée.
Guide Obsidian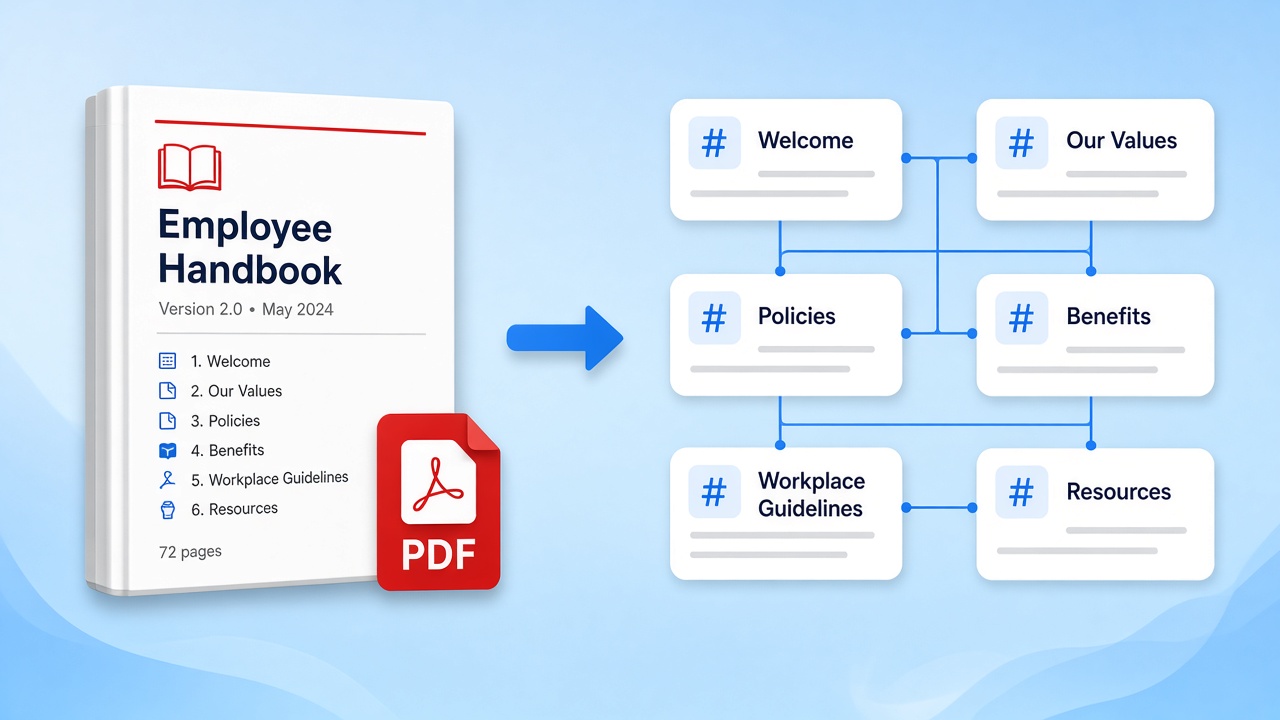
Des manuels vers le wiki
Faites entrer un manuel du personnel ou un guide produit dans un wiki. Le convertisseur PDF en MD garde les titres de chapitre, le découpage en pages va donc vite.
Convertir un manuel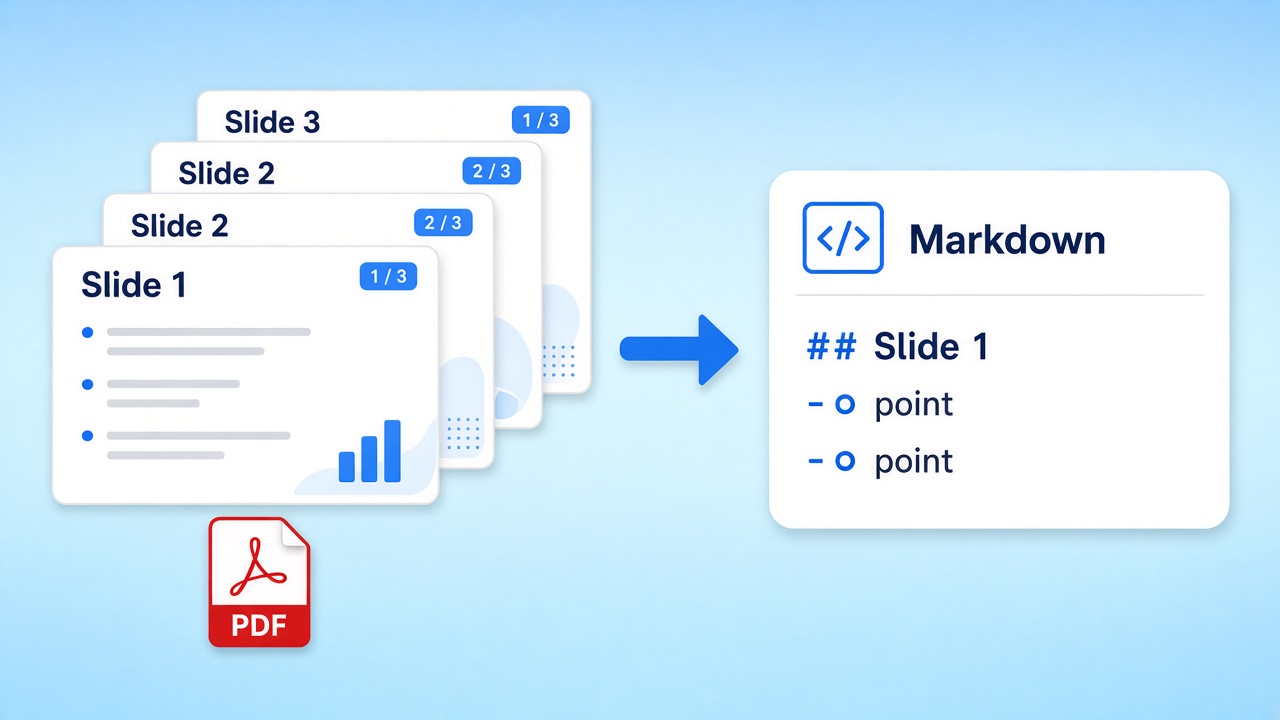
Des diapos en plan
Les présentations exportées deviennent un plan à puces pour un document, un script ou un prompt. Les titres des diapositives restent des titres.
Texte pour les prompts
Un convertisseur PDF en MD qui reste sur votre appareil
Ce convertisseur fait tout dans votre onglet avec pdf.js. Le fichier n’est jamais envoyé à nos serveurs. Sur un ordinateur partagé, fermez l’onglet quand vous avez terminé.
Du Markdown au document
Besoin d’une version imprimable du texte retravaillé ? L’outil inverse rend le Markdown dans le style GitHub et enregistre un fichier A4 dans le navigateur.
Outils associés
Des pages qui prennent le relais là où ce convertisseur s’arrête.
Lancer le convertisseur PDF en MD
Choisissez un fichier à couche texte, déposez-le et obtenez un brouillon structuré de PDF en MD. Gratuit, privé, sans installation.
Ouvrir le convertisseurSources
- ISO 32000-2:2020 (PDF 2.0) — ISO, 2020
- CommonMark Spec 0.31.2 — CommonMark, 2024
- GitHub Flavored Markdown Spec — GitHub
- pdf.js — Mozilla
FAQ
Comment la conversion se comporte, ce qu’elle garde et où elle s’arrête.
Comment le convertisseur PDF en MD trouve-t-il les titres ?
Il compare la taille de chaque ligne à la taille habituelle du texte. Les lignes nettement plus grandes deviennent des titres de # à ####, et les lignes courtes en majuscules deviennent des titres de section.
Mes tableaux sont-ils conservés ?
Oui, pour la plupart des tableaux à couche texte ; dans nos tests, les 12 fichiers de test de tableaux ont réussi. Les grilles à filets et les tableaux sans bordure aux colonnes alignées deviennent des tableaux GitHub Flavored Markdown, avec la première ligne comme en-tête. Les cellules fusionnées sont séparées et les tableaux pivotés arrivent en texte simple.
Le PDF en MD marche-t-il avec des pages scannées ?
Non. Les scans n’ont pas de couche texte, et il n’y a pas d’OCR. Le convertisseur affiche un avertissement quand un fichier ressemble à des images.
Y a-t-il une limite de pages ou de taille ?
Pas de plafond fixe ; les très gros fichiers dépendent de la mémoire de votre appareil.
Le convertisseur envoie-t-il mon fichier ?
Non. Le fichier est lu avec pdf.js dans votre navigateur et n’est jamais envoyé à nos serveurs.
Que se passe-t-il aux sauts de page ?
Les pages sont réunies en un seul fichier, sans marqueur de page. Un paragraphe qui continue sur la page suivante est recollé si la coupure tombe au milieu d’une phrase ; sinon une ligne vide sépare les pages.
Puis-je convertir plusieurs fichiers d’un coup ?
Cette page traite un fichier à la fois. La page de conversion par lot convertit plusieurs fichiers et regroupe le Markdown dans un ZIP.