带结构的提取
在线 PDF转MD工具
更新于 · pdftomd.tools 团队
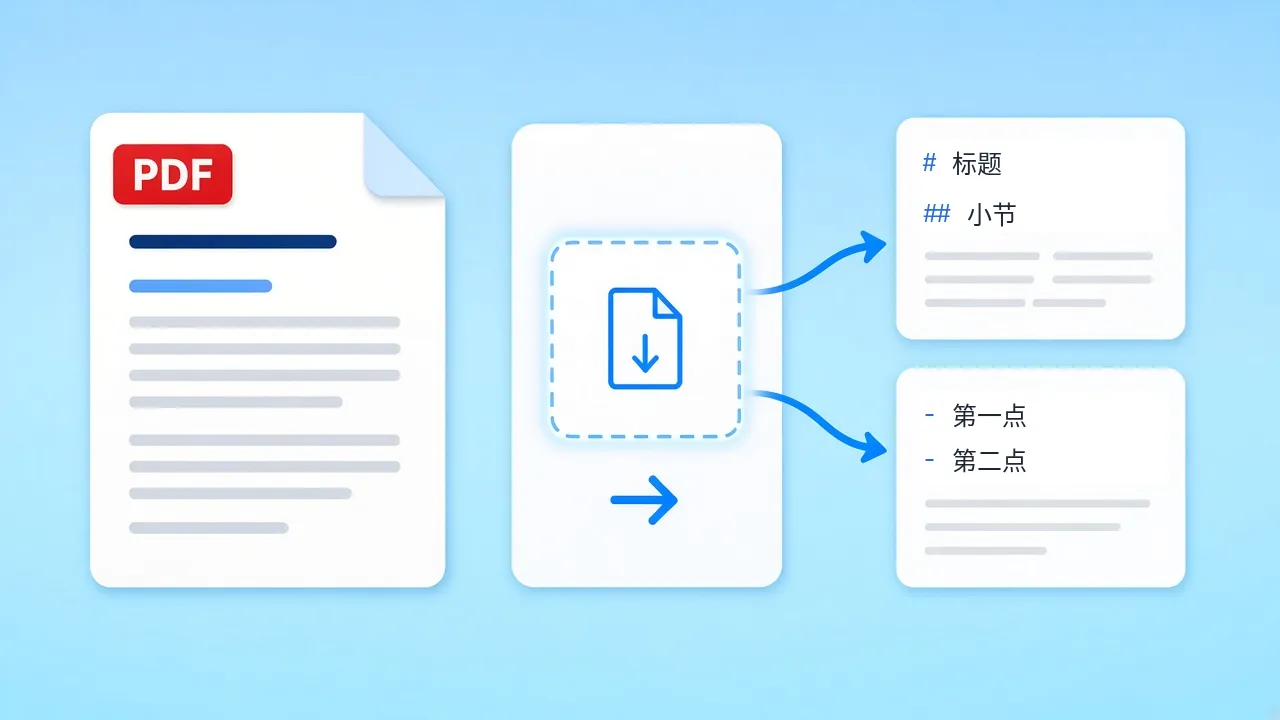
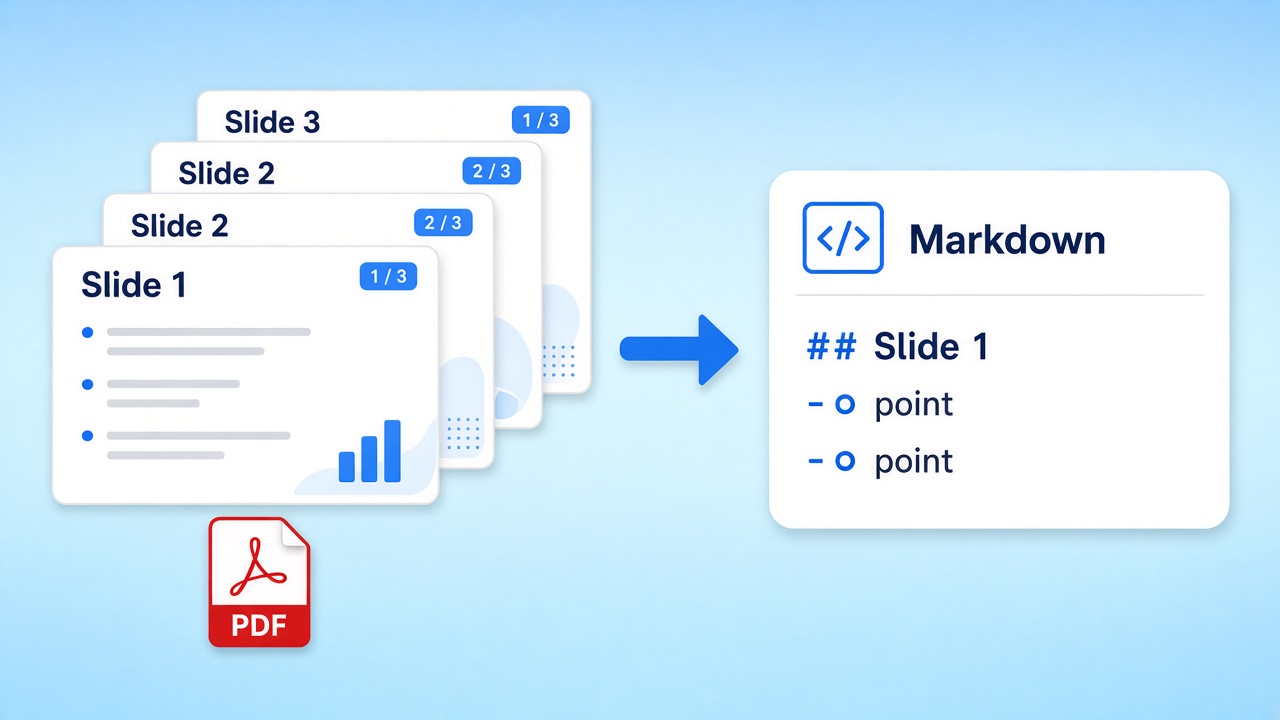
PDF转MD工具能把带文字层的 PDF 变成自带层级结构的 Markdown。它会分析字号和列表符号,重建标题、列表和段落。你只需要修改内容,不用再手动敲一遍结构。
下面的转换器一次处理一个文件。拖入文档,查看预览,然后复制或保存为 .md。所有操作都在当前标签页里完成。
源 PDF
把 PDF 拖到这里,或点击选择
仅支持带文字层的 PDF。扫描件需要 OCR,本工具不做 OCR。
Markdown 预览
Markdown 会显示在这里。
PDF转MD工具如何读取一页
文件一进来,浏览器里就会依次跑四个步骤。




一个好的 PDF转MD工具应该保留什么
评价 PDF转MD工具,要看它还原出来的层级结构。ISO 32000 规范定义的 PDF 把文字存成一个个带坐标的片段,而不是标题和列表。所以直接复制粘贴只会得到一大段文字,这也是 PDF转MD 必须做结构识别的原因。我们的转换器依据视觉线索重建层级:用相对字号判断标题,用行首符号判断无序列表,用带句点或括号的数字判断有序步骤。
输出刻意采用朴素的 CommonMark。标题用 #,列表用 - 或 1.,段落之间用空行分隔。这样的文件对 Git diff、静态网站生成器和笔记软件都很友好。全大写的短行会被当作小节标题。
- 按相对字号识别最多四级标题
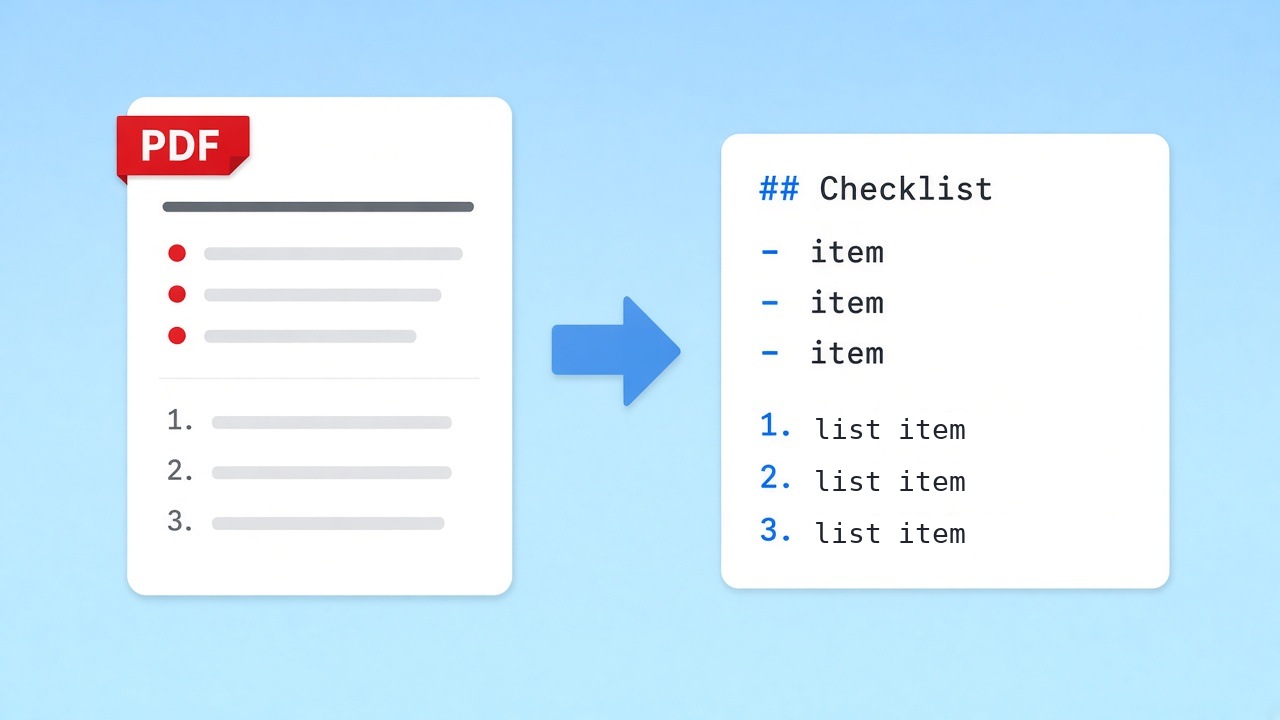
- 按符号识别无序列表和有序列表
- GitHub Flavored Markdown 表格
- 跨页的段落会重新接上
哪些地方还需要人工看一眼
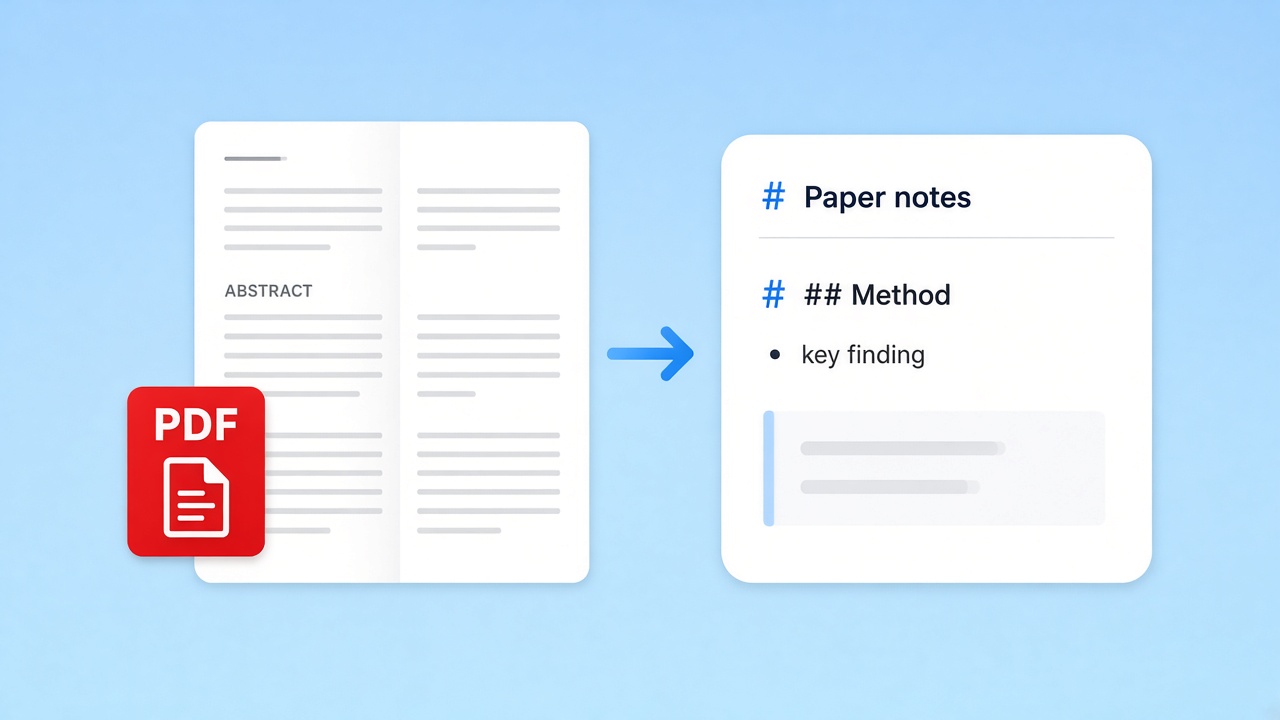
如果表格的列是对齐的,或者用线条画出,就会转成 GitHub Flavored Markdown 表格,第一行作为表头。合并单元格会被拆开,旋转的表格会退回成普通行。粗体、斜体和链接变成普通文字,图片会被跳过。双栏版式可能把行混在一起,扫描页则完全没有文字层,这时转换器会给出提示。
谁在用 PDF转MD工具
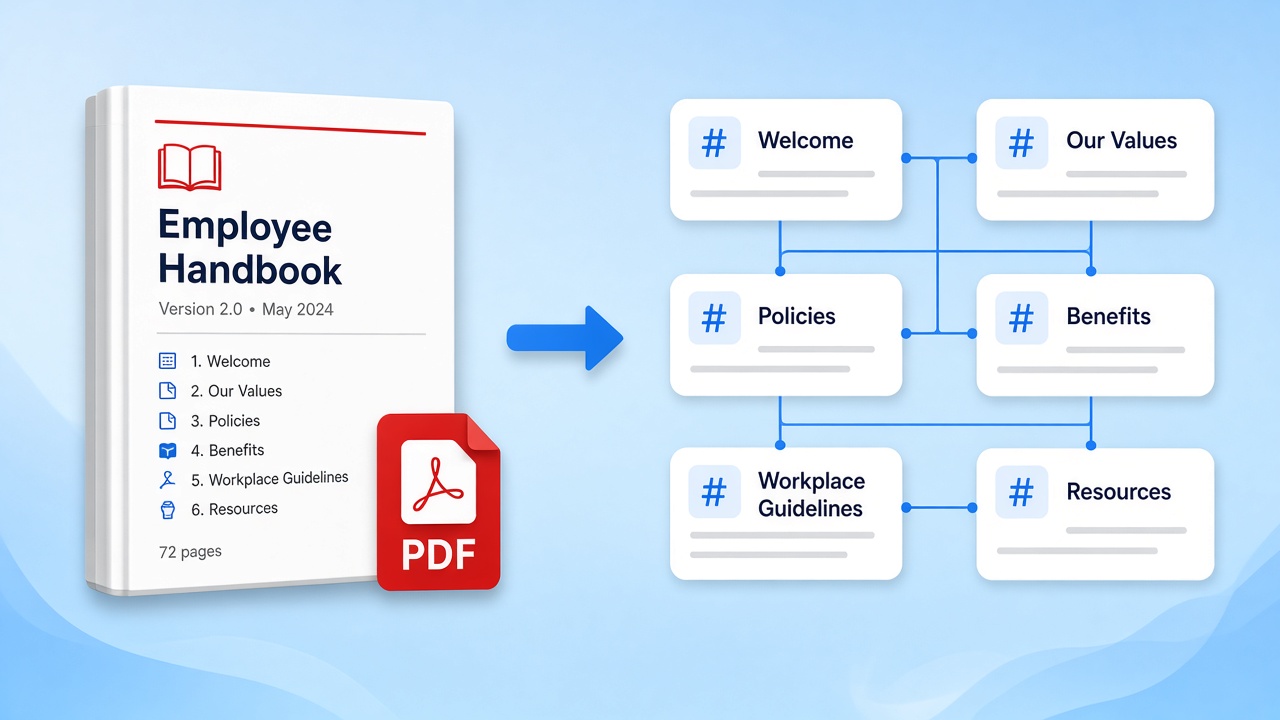
篇幅长、结构清楚的文档,最值得转换。

相关工具
接着这个转换器往下走的页面。
参考来源
- ISO 32000-2:2020 (PDF 2.0) — ISO, 2020
- CommonMark Spec 0.31.2 — CommonMark, 2024
- GitHub Flavored Markdown Spec — GitHub
- pdf.js — Mozilla
常见问题
转换怎么工作、保留什么、到哪里为止。
转换器怎么找出标题?
它把每一行的字号和正文的常见字号做比较。明显更大的行会成为 # 到 #### 的标题,全大写的短行会成为小节标题。
表格能保留吗?
大多数带文字层的表格都能保留;在我们的测试中,12 个表格测试文件全部通过。带线条的网格表和列对齐的无框表会变成 GitHub Flavored Markdown 表格,第一行作为表头。合并单元格会被拆开,旋转的表格会以普通文字输出。
扫描页也能 PDF转MD 吗?
不能。扫描件没有文字层,也没有 OCR。文件看起来像图片时,转换器会显示提示。
页数或文件大小有限制吗?
没有固定上限;特别大的文件取决于你设备的内存。
转换器会上传我的文件吗?
不会。文件在你的浏览器里用 pdf.js 读取,从不发送到我们的服务器。
分页处会怎样?
各页会合并成一个文件,不留分页标记。如果段落在句子中间被分页截断,会重新接上;否则用空行把页面隔开。
能一次转换多个文件吗?
这个页面一次处理一个文件。批量页面可以转换多个文件,并把 Markdown 打包进一个 ZIP。