给模型读的文字
大模型PDF转Markdown
更新于 · pdftomd.tools 团队
做一次大模型PDF转Markdown,标题、列表和表格就会以纯文本保留下来。对话模型或检索流水线看到的文档,和人读到的一样有条理。
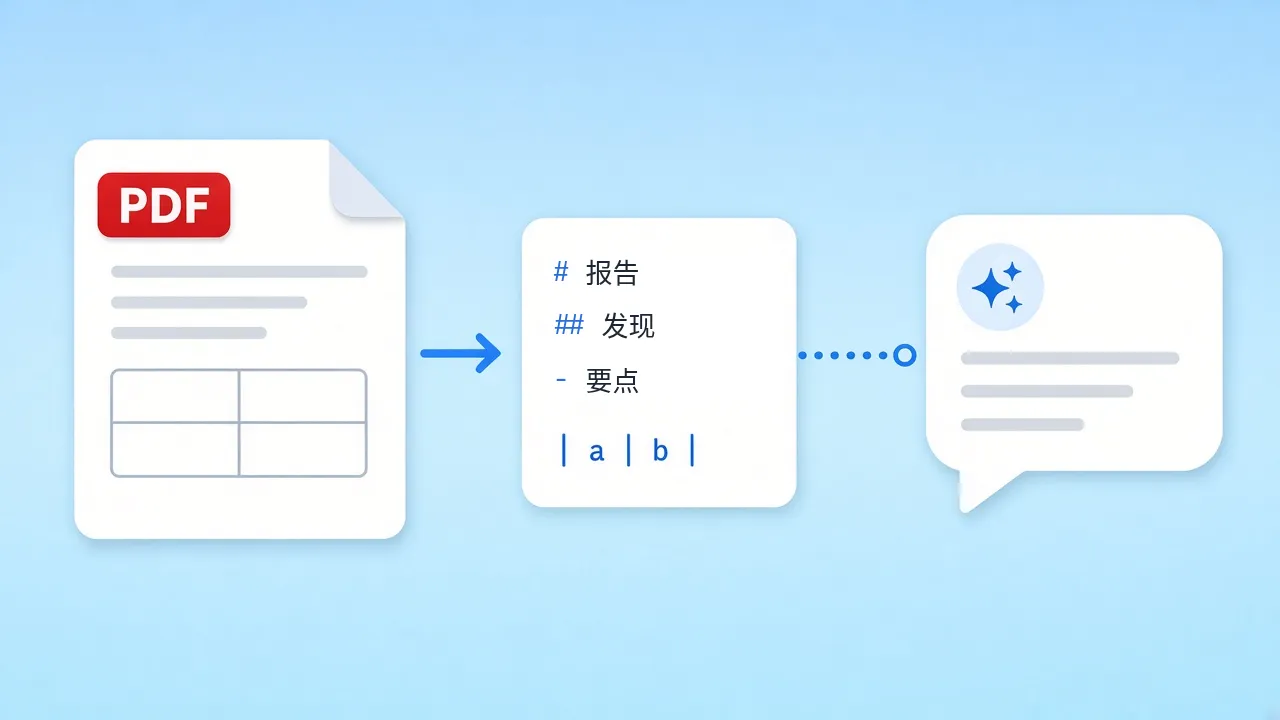
在下面放入一个带文字层的文件。结果会出现在右边,可以直接复制到提示词里,也可以存成 .md 文件交给你的流水线。
源 PDF
把 PDF 拖到这里,或点击选择
仅支持带文字层的 PDF。扫描件需要 OCR,本工具不做 OCR。
Markdown 预览
Markdown 会显示在这里。
从 PDF 经过 Markdown 到提示词
四个步骤,几秒钟完成,全部在你自己的设备上运行。




为什么要大模型PDF转Markdown?
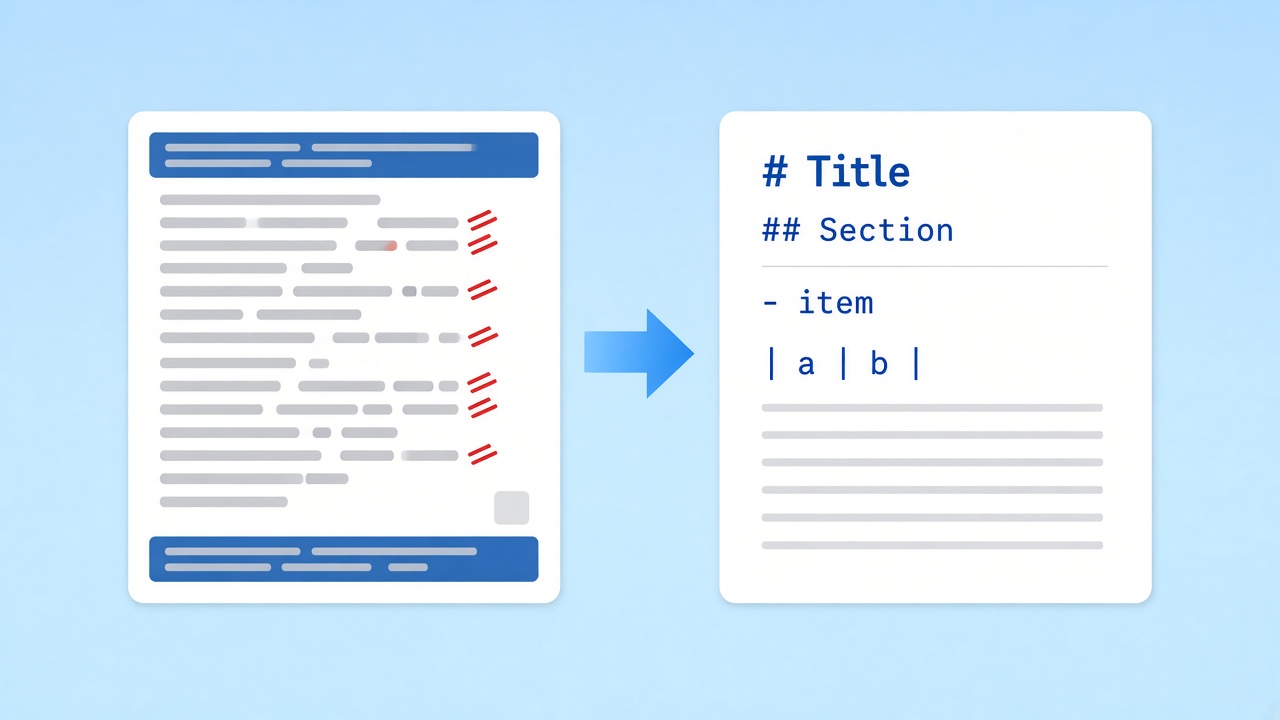
直接从打印版式复制出来的文字,混着重复的页眉、页码、断开的连字符,还有散落到好几行的表格单元格。模型得先花注意力和 token 把这些理清,才能开始回答。把 PDF 转成 Markdown 能提前去掉大部分噪音:章节用 # 标出,步骤用 1.,表格数据用 GFM 竖线,模型因此分得清标题和脚注。
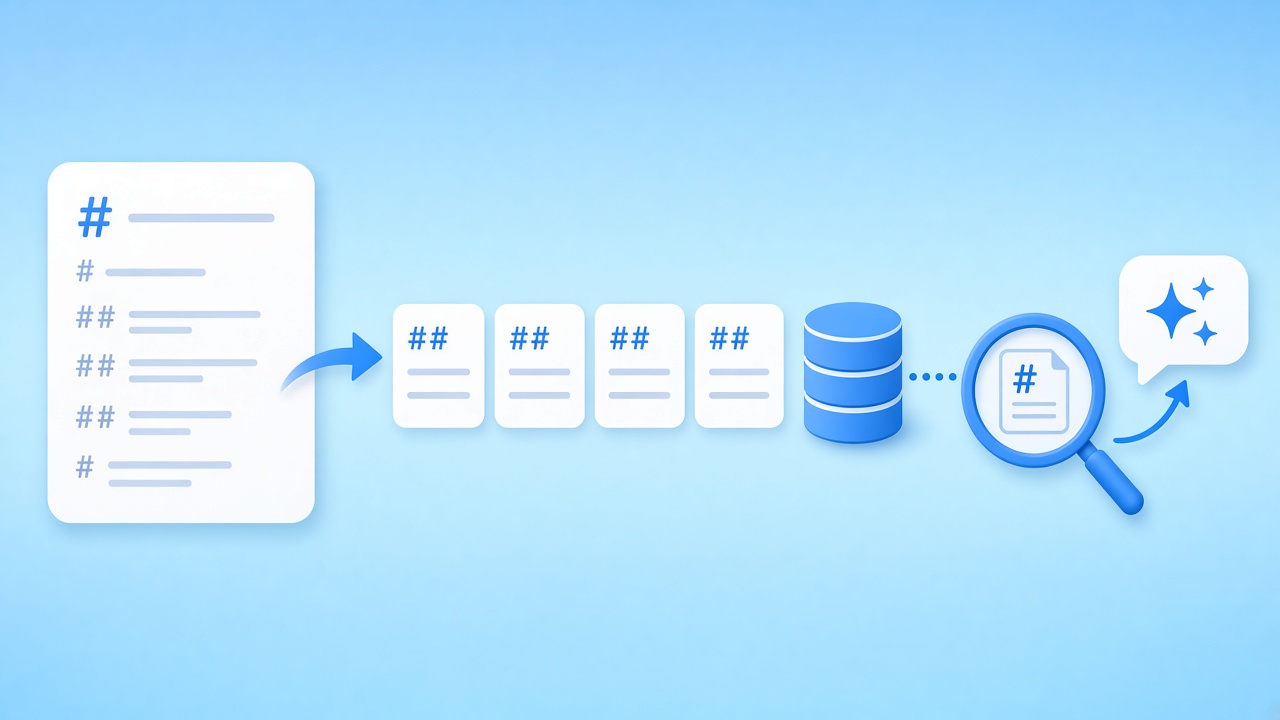
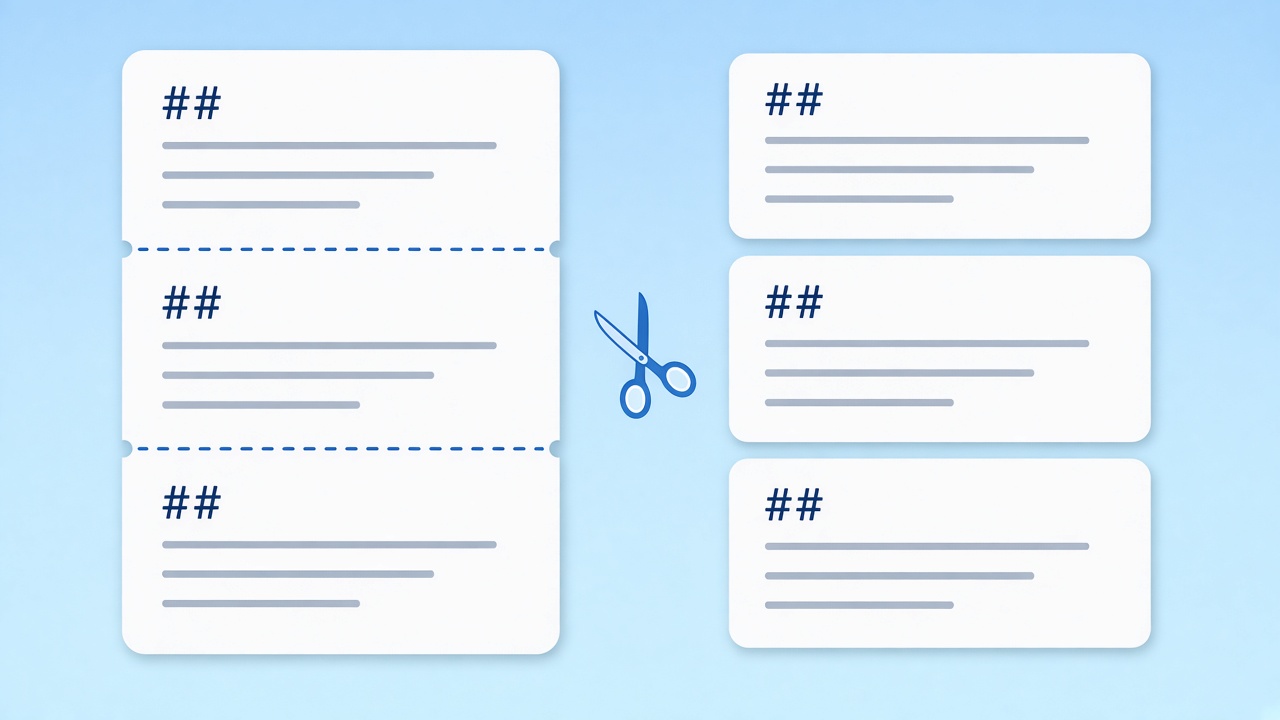
有了结构,文字也更容易切块。每个章节都以标题开头,长文件就能切成独立的片段,标题留作标签,回答需要出处时可以准确引用那一节。Anthropic 指出,提示词的格式会影响回答的风格;OpenAI 的 GPT-4.1 指南在谈到如何选择提示词分隔符时,对 Markdown 是这样说的:
“我们建议从这里入手,用 Markdown 标题标出主要章节和子章节(包括更深的层级,直到 H4 及以下)。”
- 标题标出每个新主题
- 列表和表格保持为易读的纯文本
- 去掉页码和重复页眉
写提示词之前要了解的限制
三页及以上的文件中,大多数页面都重复出现的页码和页眉页脚会被自动去掉;措辞会变化或只出现在少数几页的页眉可能会留下,所以请扫一眼预览。合并单元格会被拆开,旋转的表格会变成普通行,双栏版式可能会串行。扫描件没有文字层,本工具也不做 OCR。没有 token 计数器,也不会自动切块;长输出请按标题手动切分。
大模型项目里的 PDF 转 Markdown
团队把 PDF 提取出的 Markdown 用在大模型流水线里的三种常见方式。

私密完成的大模型PDF转Markdown
转换由 pdf.js 在你的浏览器里完成,文件从不到达我们的服务器。源文件是合同或内部报告时,这一点很重要:哪些章节离开你的设备、交给哪个模型,都由你决定。
相关工具
更多关于 PDF 和 Markdown 的页面。
参考来源
- GPT-4.1 Prompting Guide — OpenAI
- Prompting best practices — Anthropic
- GitHub Flavored Markdown Spec — GitHub
常见问题
关于提示词、检索和限制的问题。
为什么用 Markdown 而不是纯文本?
Markdown 明确标出了标题、列表和表格,模型可以直接顺着结构读,不用从换行里去猜。
工具会统计 token 或帮我切分文件吗?
不会。目前还没有 token 计数器,也没有自动切块。长输出请按标题切分,并用你自己的大模型工具检查长度。
PDF 转成 Markdown 时表格会保留吗?
大多数带文字层的表格会保留,变成带表头的竖线表格。合并单元格会被拆开,旋转的表格会变成普通文字。
为大模型转换是私密的吗?
是的。处理在你的浏览器里完成,文件从不上传。只有你粘贴给模型的内容才会离开设备。
扫描的文档能转换吗?
不能。扫描件没有文字层,本工具也不做 OCR。文件看起来像图片时会提醒你。
哪些大模型能读这种输出?
任何接受文字的模型都可以。Markdown 就是纯文本,对话助手、向量化任务和本地模型都能读。
长 Markdown 文件怎么切块?
在 ## 或 ### 标题处切开,每块开头保留标题,并记下文件名,这样回答就能指向出处。