給模型讀的文字
AI用PDF轉Markdown
更新於 · pdftomd.tools 團隊
做一次 AI用PDF轉Markdown,標題、清單和表格都會以純文字保留下來。聊天模型或檢索流程看到的文件,就跟人讀起來一樣有條理。
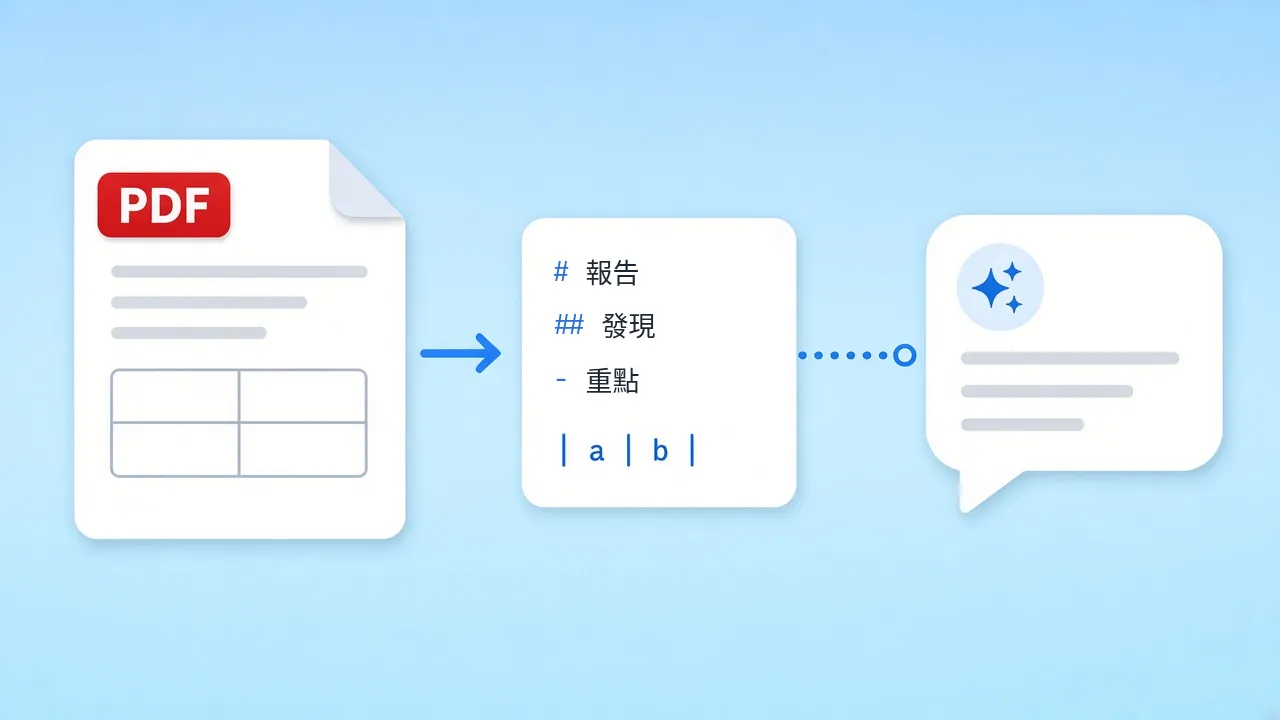
在下方放入有文字層的檔案。結果會出現在右邊,可以直接複製到提示詞裡,也可以存成 .md 檔交給你的處理流程。
來源 PDF
把 PDF 拖曳到這裡,或點一下選擇檔案
只支援有文字層的 PDF。掃描檔需要 OCR,這個工具不做 OCR。
Markdown 預覽
Markdown 會顯示在這裡。
從 PDF 經過 Markdown 到提示詞
四個步驟,幾秒鐘就好,全部在你自己的裝置上執行。




為什麼需要 AI用PDF轉Markdown?
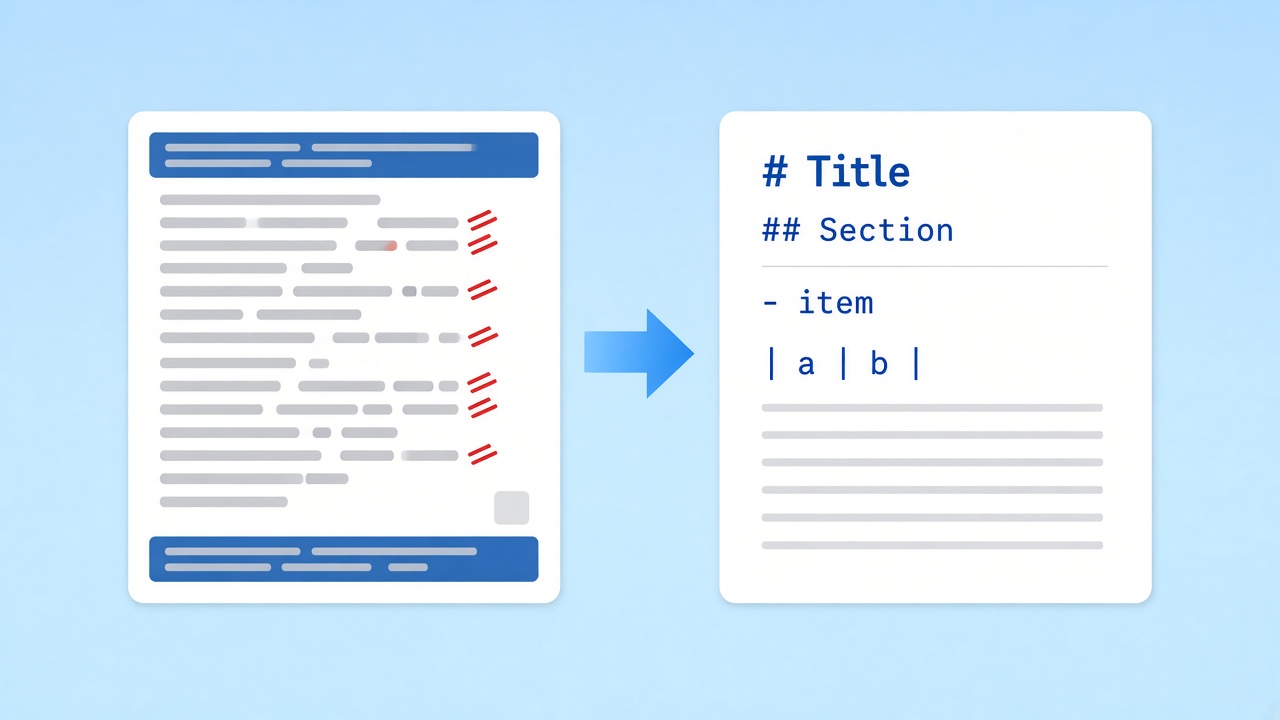
直接從列印版面複製出來的文字,會混著重複的頁首、頁碼、斷掉的連字號,還有散落在好幾行的表格儲存格。模型得先花注意力和 token 理清這些,才能開始回答。把 PDF 轉成 Markdown,可以事先清掉大部分雜訊:章節用 # 標示,步驟用 1.,表格資料用 GFM 直線,模型就分得出標題和註腳。
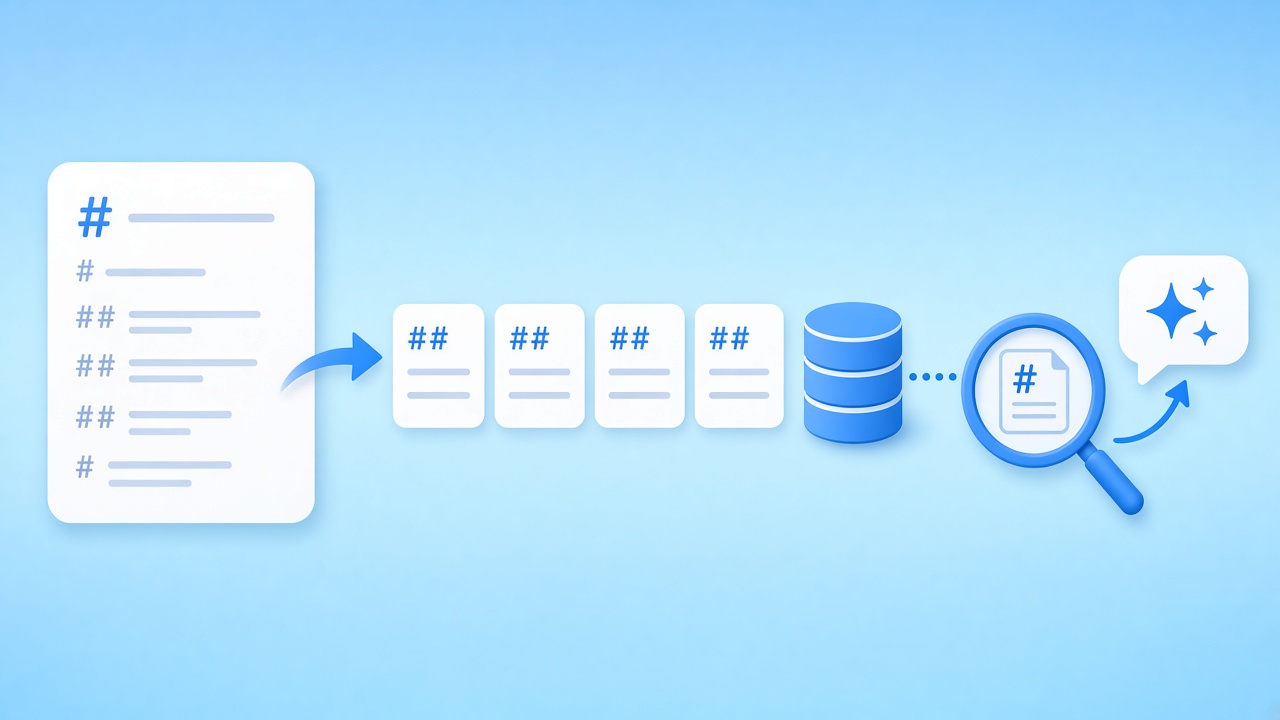
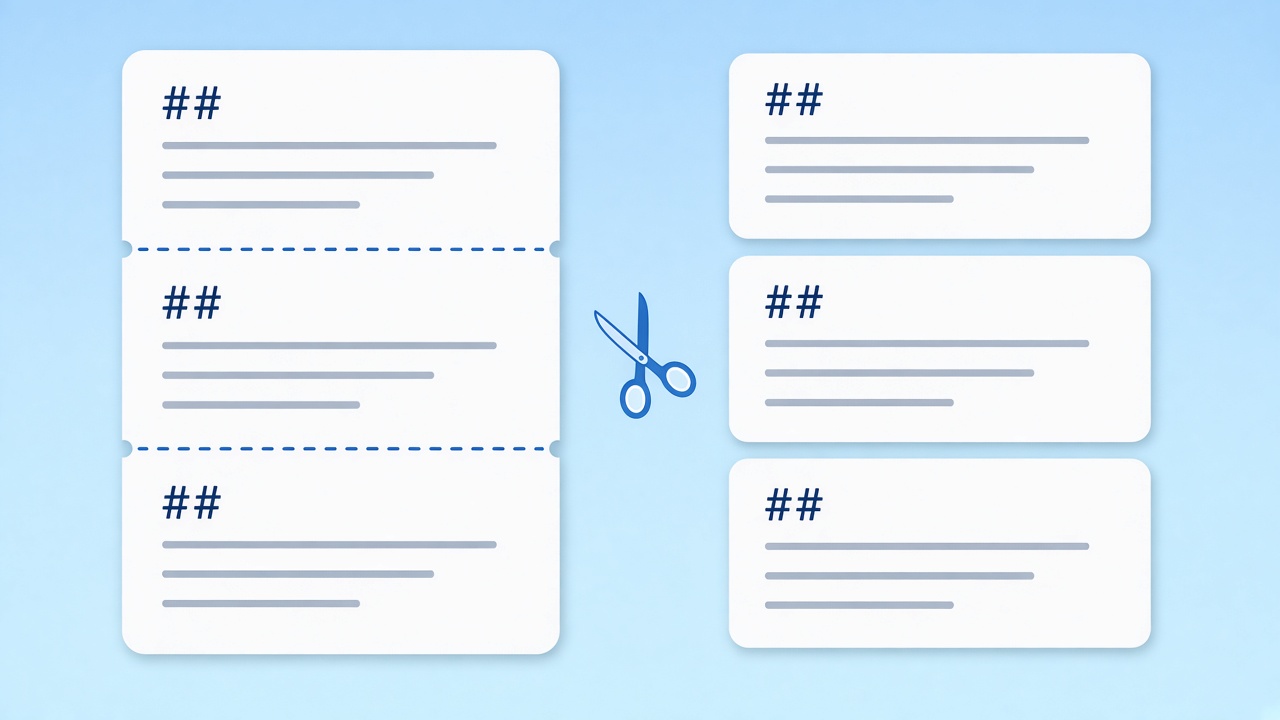
有了結構,文字也更好切塊。每個章節都從標題開始,長檔案就能切成獨立的片段,標題留作標籤,回答需要出處時可以精準引用那一節。Anthropic 提到,提示詞的格式會影響回答的風格;OpenAI 的 GPT-4.1 指南在談到怎麼挑選提示詞分隔符號時,對 Markdown 是這麼說的:
“我們建議從這裡開始,用 Markdown 標題標出主要章節和子章節(包括更深的層級,一路到 H4 以下)。”
- 標題標出每個新主題
- 清單和表格維持好讀的純文字
- 移除頁碼和重複的頁首
寫提示詞之前要知道的限制
三頁以上的檔案中,大部分頁面都重複出現的頁碼和頁首頁尾會自動移除;文字會變動或只出現在少數幾頁的頁首可能會留下,所以請瀏覽一下預覽。合併儲存格會被拆開,旋轉的表格會變成一般文字行,雙欄版面可能會混在一起。掃描檔沒有文字層,這個工具也不做 OCR。沒有 token 計數器,也不會自動切塊;長輸出請依標題自己切開。
AI 專案裡的 PDF 轉 Markdown
團隊把 PDF 擷取出的 Markdown 用在 AI 處理流程的三種常見方式。

私密完成的 AI用PDF轉Markdown
轉換由 pdf.js 在你的瀏覽器裡完成,檔案從來不會到達我們的伺服器。來源是合約或內部報告時,這點很重要:哪些章節離開你的裝置、交給哪個模型,都由你決定。
相關工具
更多關於 PDF 和 Markdown 的頁面。
資料來源
- GPT-4.1 Prompting Guide — OpenAI
- Prompting best practices — Anthropic
- GitHub Flavored Markdown Spec — GitHub
常見問題
關於提示詞、檢索和限制的問題。
為什麼用 Markdown,而不是純文字?
Markdown 會明確標出標題、清單和表格,模型可以直接順著結構讀,不必從換行去猜。
工具會計算 token 或幫我切檔案嗎?
不會。目前還沒有 token 計數器,也沒有自動切塊。長輸出請依標題切開,再用你自己的 AI 工具檢查長度。
PDF 轉成 Markdown 時表格會保留嗎?
大部分有文字層的表格會保留,變成有標題列的直線表格。合併儲存格會被拆開,旋轉的表格會變成一般文字。
為 AI 轉換是私密的嗎?
是的。處理在你的瀏覽器裡完成,檔案從來不會上傳。只有你貼給模型的內容才會離開裝置。
掃描的文件可以轉換嗎?
不行。掃描檔沒有文字層,這個工具也不做 OCR。檔案看起來像圖片時會提醒你。
哪些 AI 模型讀得懂這種輸出?
任何接受文字的模型都可以。Markdown 就是純文字,聊天助理、向量化工作和本機模型都讀得懂。
長的 Markdown 檔要怎麼切塊?
在 ## 或 ### 標題處切開,每塊開頭保留標題,並記下檔名,這樣回答就能指向出處。