ChatGPT最適合的檔案格式:拿真實檔案測給你看
作者 pdftomd.tools 團隊 · 更新於 · 約 6 分鐘閱讀
如果是文字為主的文件,乾淨的 Markdown 就是 ChatGPT最適合的檔案格式:標題、清單和表格都用簡單字元保留下來,token 用量和純文字差不多。圖表或頁面版面很重要時,就保留 PDF。要產生 Markdown,用 AI用PDF轉Markdown 工具轉一次,再檢查標題就好。
簡短回答:ChatGPT最適合的檔案格式是哪一種?
該用哪一種格式,要看文件的內容。簡單整理如下:
| 你的內容 | 交給模型的格式 | 原因 |
|---|---|---|
| 報告、手冊、合約、筆記 | Markdown | 用簡單字元表達結構(標題、清單、表格) |
| 沒有結構的連續文字 | 純文字 | 成本和 Markdown 一樣,沒什麼損失 |
| 圖表、掃描檔、表單、簡報 | PDF 原檔 | 模型需要看到頁面影像 |
| 資料列 | CSV 或試算表 | 一列一筆紀錄,方便計數和篩選 |
| 給程式用的紀錄 | JSON | 欄位和型別精確,但 token 成本較高 |
本文接下來說明原因:上傳 PDF 時模型實際收到什麼;我們把同樣的文件轉成六種格式、計算 token 的結果;以及怎麼準備檔案,讓回答根據的是正確的段落。
上傳 PDF 時發生了什麼事
要選出 ChatGPT最適合的檔案格式,先看看 PDF 會變成什麼。PDF 是頁面的描述,不是文字檔。要讀懂它,模型供應商得先把文字擷取出來,大型供應商還會把每一頁算繪成圖片。根據 OpenAI 的 檔案輸入指南,把 PDF 送給看得懂圖片的模型時,平台會同時擷取文字和每一頁的影像,一起交給模型;其他文字檔只會以文字形式送入。Anthropic 對 Claude 也說明了同樣的做法:
“系統會將文件的每一頁轉換成影像。每頁的文字會被擷取出來,並與該頁影像一起提供。”
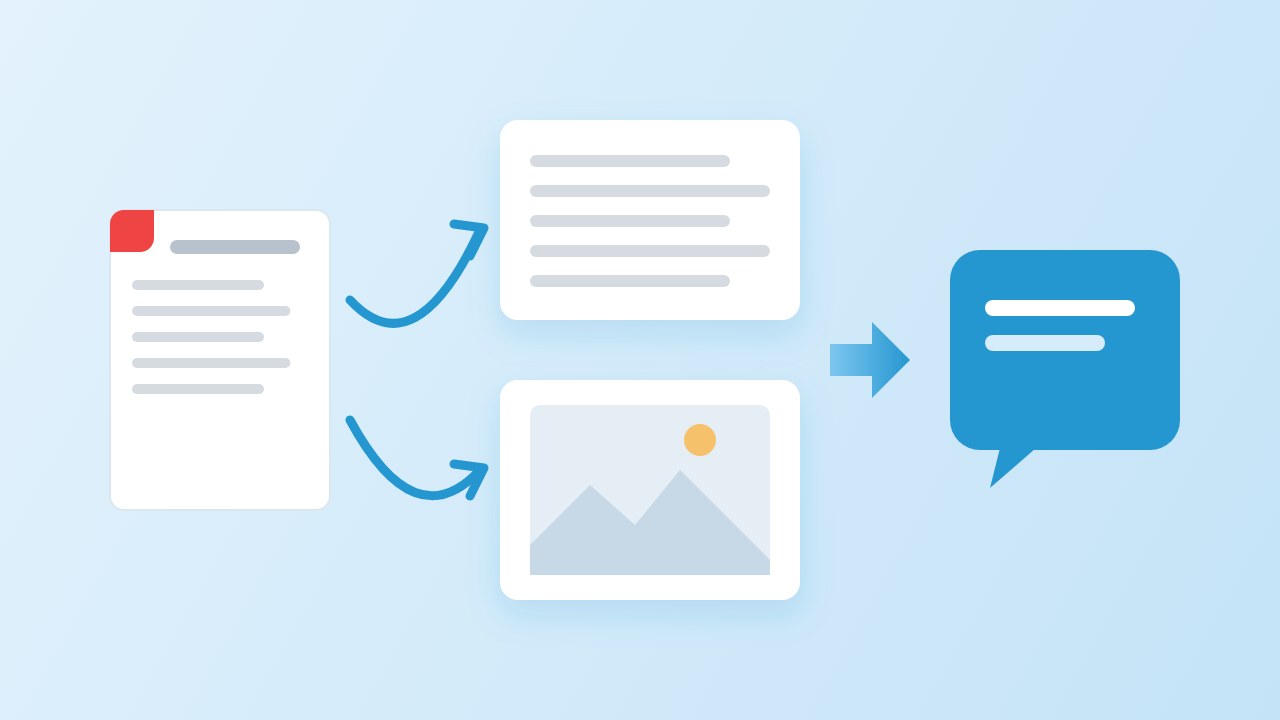
這正是 AI 該用 Markdown 還是 PDF 的關鍵。頁面上有圖表或掃描的簽名時,影像很有幫助,但要額外付出成本:Anthropic 估計光是文字每頁就要 1,500 到 3,000 個 token,還不含影像;OpenAI 也提醒,PDF 輸入可能會增加 token 用量。此外,擷取出的文字只會和 PDF 的文字層一樣好,重複的頁首、頁碼和破掉的表格都會原封不動送進來。這兩份文件說明的都是開發者平台;一般使用者用的聊天 App 沒有公開同樣詳細的資訊。
Token:PDF 和 Markdown,以及另外四種格式
為了取得 PDF 和 Markdown 的 token 比較數據,我們在 2026年10月19日 挑了四個 PDF,把每個都轉成六種文字格式:我們乾淨的 Markdown 轉檔結果、pdftotext 輸出的純文字(保留版面與不保留版面各一份)、從 Markdown 算繪的 HTML,以及每個區塊一個物件的 JSON(縮排版和壓縮版)。token 用 OpenAI 的 tiktoken 函式庫計算(編碼 o200k_base)。PDF 這條路本身我們沒有計算,因為每家供應商計算頁面影像的方式都不同。
| 文件 | Markdown | 純文字 | 保留版面的文字 | HTML | JSON | JSON(壓縮) |
|---|---|---|---|---|---|---|
| 英文指南,5 頁 | 2,651 | 2,667 | 2,724 | 3,237 | 4,086 | 3,195 |
| 中文報告,11 頁 | 8,697 | 8,713 | 8,804 | 9,796 | 11,063 | 9,402 |
| 英文報告,4 頁 | 145 | 217 | 229 | 246 | 379 | 225 |
| 表格,1 頁 | 106 | 99 | 102 | 211 | 265 | 154 |
| 四份合計 | 11,599 | 11,696 | 11,859 | 13,490 | 15,793 | 12,976 |
| 和 Markdown 相比 | 1.00× | 1.01× | 1.02× | 1.16× | 1.36× | 1.12× |
老實說:Markdown 和純文字的成本幾乎一樣。四個檔案合計,純文字多了 1%;在那份一頁的表格檔裡,純文字甚至少一點,因為直線也要用掉 token。4 頁報告差距很大,是清除的功勞,不是語法的關係:純文字裡留著四份重複頁首和四個頁碼。HTML 比 Markdown 多 16%,縮排的 JSON 多 36%,壓縮的 JSON 多 12%。
所以 Markdown 會是 ChatGPT最適合的檔案格式,不是因為檔案很小,而是因為結構幾乎不花成本:純文字用掉一樣多的 token,卻把標題和表格欄位都丟了。
為什麼 LLM 用 Markdown 比 JSON 或 HTML 好?
那麼,為什麼 Markdown 比較適合 LLM?有三個站得住腳的理由。第一,結構看得見:## 開頭的一行是章節,| 開頭的一行是表格,模型看過的這兩種內容多到數不清。第二,雜訊少:沒有結束標籤,不必替每個鍵加引號,也沒有跳脫字元。第三,各家的指南都指向同一個方向。OpenAI 的 GPT-4.1 Prompting Guide 建議以 Markdown 作為安排提示詞結構的起點,指出 JSON 可能比較冗長、需要跳脫字元,也提到在長脈絡測試中,用 JSON 裝很多份文件的效果很差,XML 則表現不錯。
所以 JSON 還是 Markdown 可以這樣決定:結果要給程式讀,或資料是一組欄位固定的紀錄,就用 JSON;文件要讓模型閱讀和推理,就用 Markdown。一次放進好幾份文件時,替每個 Markdown 檔包一個簡單標籤,例如 <document title="…">,就能有 XML 那種分隔效果,又不用轉換內容。
怎麼替 ChatGPT 準備文件
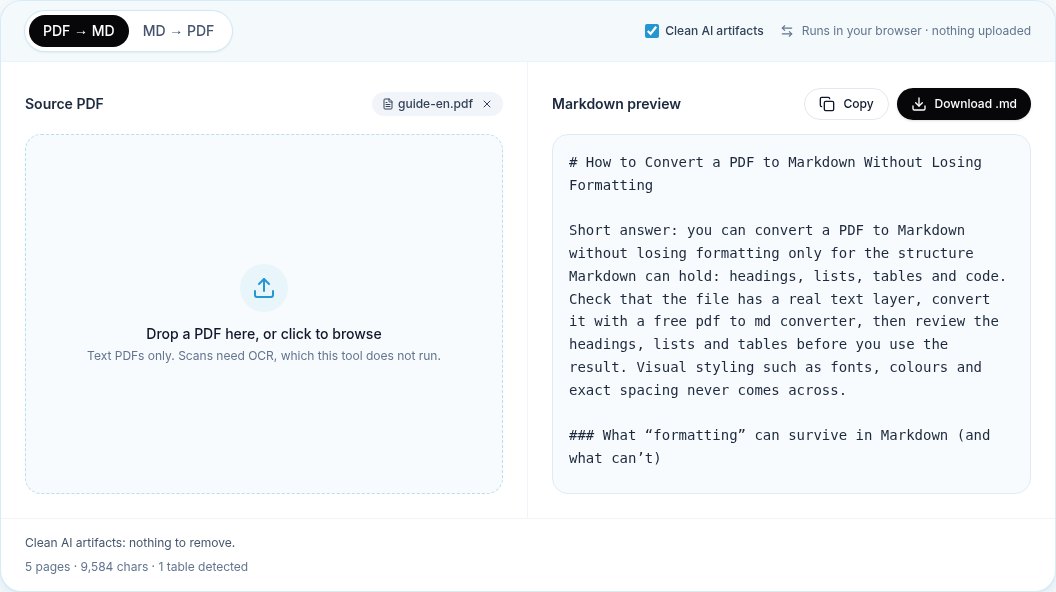
- 把有文字層的 PDF 轉成 Markdown,並開啟清除功能,拿掉重複的頁首和頁碼。我們的 PDF轉Markdown 工具在瀏覽器裡就能完成。
- 檢查結構:一個
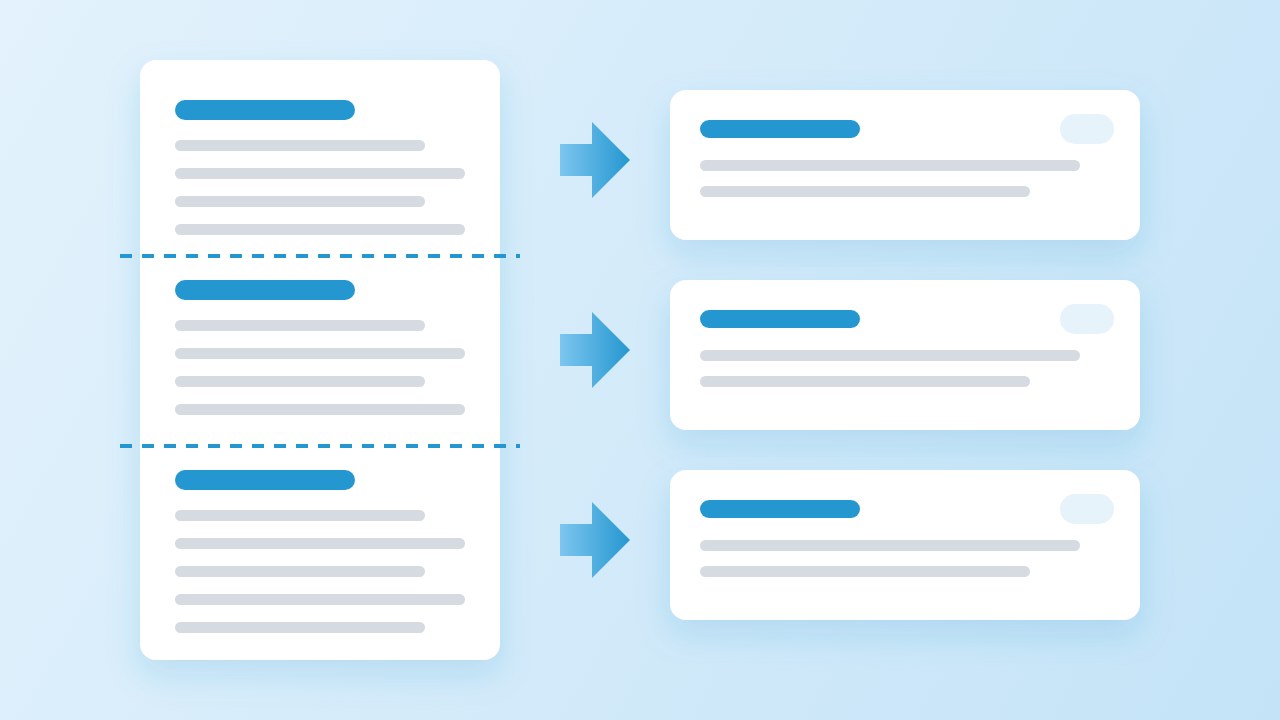
#標題,章節用##,表格用直線表格。以一般文字出現的標題要改回來。 - 長檔案依標題切分,不要用固定字數切,讓每一段都以自己的標題開頭。這對檢索增強(RAG)系統特別重要。
- 文件放前面,問題放最後。Anthropic 的 長脈絡技巧 建議這個順序,並表示在他們的測試中,回答品質最多提升了 30%。
- PDF 也留在手邊,遇到和圖表、插圖有關的問題時,另外上傳。
如果是自動化流程而不是單次聊天,Python 做法 可以用程式碼完成同樣的轉檔;我們的 本機轉檔教學 則說明怎麼讓機密檔案一直留在自己的電腦,直到你決定送出。
什麼時候還是該用 PDF
Markdown 並不是每種情況都是 ChatGPT 讀得最好的格式。意義藏在畫面裡時,請用原檔:圖表和示意圖、掃描頁面(沒有人跑 OCR 的話,掃描檔轉出的 Markdown 是空的)、位置很重要的表單,以及版面本身就是訊息的簡報。這些情況下,PDF 本身就是 ChatGPT最適合的檔案格式:供應商附上的頁面影像正是你需要的,多花的 token 也值得。
如果是一份很長的報告,ChatGPT最適合的檔案格式常常是混搭:內文送 Markdown,有圖表的那兩三頁另外做成 PDF 或圖片送出。這樣大部分問題用便宜、結構清楚的版本,需要看圖時再用視覺版本。兩個檔案的名稱要取得清楚,例如 report.md 和 report-charts.pdf,並在提示詞裡說明哪個檔案有圖,模型回答前就知道該去哪裡找。
資料來源
- File inputs (PDF files) — OpenAI API documentation
- GPT-4.1 Prompting Guide — OpenAI Cookbook, 2025
- PDF support — Anthropic, Claude documentation
- Long context prompting tips — Anthropic, Claude documentation
- tiktoken — OpenAI, GitHub
常見問題
ChatGPT最適合的檔案格式是什麼?
文字為主的文件用 Markdown:它保留標題、清單和表格,token 用量和純文字差不多。圖表和掃描檔用 PDF,資料用 CSV,給程式讀的紀錄用 JSON。
PDF 和 Markdown,哪個是 ChatGPT最適合的檔案格式?
內容是文字時,貼上或上傳 Markdown。PDF 會被當成擷取文字加頁面影像來讀,token 比較多,頁首、頁尾和頁碼也會留在文字裡。
Markdown 比純文字更省 token 嗎?
幾乎沒差。在我們的測試中,四個檔案合計兩者相差約 1%。只有在我們的轉檔工具拿掉重複頁首和頁碼的檔案裡,Markdown 才比較小。
JSON 適合拿來放文件嗎?
不適合拿來閱讀。在我們的測試中,縮排的 JSON 比 Markdown 多用 36% 的 token;根據 OpenAI 的指南,它在長脈絡文件上的表現也不好。JSON 適合結構化紀錄。
ChatGPT 讀得懂掃描的 PDF 嗎?
看得到頁面影像的模型可以讀懂部分掃描頁。掃描檔轉成 Markdown,沒有 OCR 就是空的,所以掃描檔請直接送 PDF,或先做 OCR。
長文件送出前要切分嗎?
聊天時,一個結構清楚的檔案通常就夠了。用於檢索,或碰到脈絡長度上限時,依標題切分,讓每一部分都保留自己的標題。

