Il miglior formato di file per ChatGPT, testato su file veri
Di Team di pdftomd.tools · Aggiornato il · 8 min di lettura
Per i documenti di testo, un Markdown pulito è il miglior formato di file per ChatGPT: titoli, elenchi e tabelle restano come caratteri semplici, e costa più o meno gli stessi token del testo semplice. Tieni il PDF quando contano i grafici o l'impaginazione. Per ottenere il Markdown, passa il file in un convertitore PDF in Markdown per LLM e controlla i titoli.
Risposta breve: qual è il miglior formato di file per ChatGPT?
Il miglior formato di file per ChatGPT dipende da che cosa è il documento. In sintesi:
| Il tuo contenuto | Da dare al modello | Perché |
|---|---|---|
| Report, manuali, contratti, appunti | Markdown | La struttura (titoli, elenchi, tabelle) in caratteri semplici |
| Testo continuo senza struttura | Testo semplice | Stesso costo di Markdown, niente da perdere |
| Grafici, scansioni, moduli, slide | Il PDF stesso | Il modello ha bisogno delle immagini delle pagine |
| Righe di dati | CSV o un foglio di calcolo | Un record per riga, facile da contare e filtrare |
| Record per un programma | JSON | Campi e tipi esatti, con un costo in token più alto |
Il resto della guida spiega il perché: cosa riceve davvero il modello quando carichi un PDF, cosa abbiamo misurato contando i token degli stessi documenti in sei formati, e come preparare un file perché la risposta si basi sulla sezione giusta.
Cosa succede quando carichi un PDF
Per scegliere il miglior formato di file per ChatGPT, guarda prima che fine fa un PDF. Un PDF è una descrizione di pagine, non un file di testo. Per leggerlo, il fornitore del modello deve estrarne il testo, e i grandi fornitori renderizzano anche le pagine come immagini. Secondo la guida ai file in input di OpenAI, con un PDF inviato a un modello che capisce le immagini, la piattaforma estrae sia il testo sia un'immagine di ogni pagina e passa entrambi al modello; gli altri file di testo entrano solo come testo. Anthropic descrive lo stesso approccio per Claude:
“Il sistema converte ogni pagina del documento in un'immagine. Il testo di ogni pagina viene estratto e fornito insieme all'immagine della pagina.”
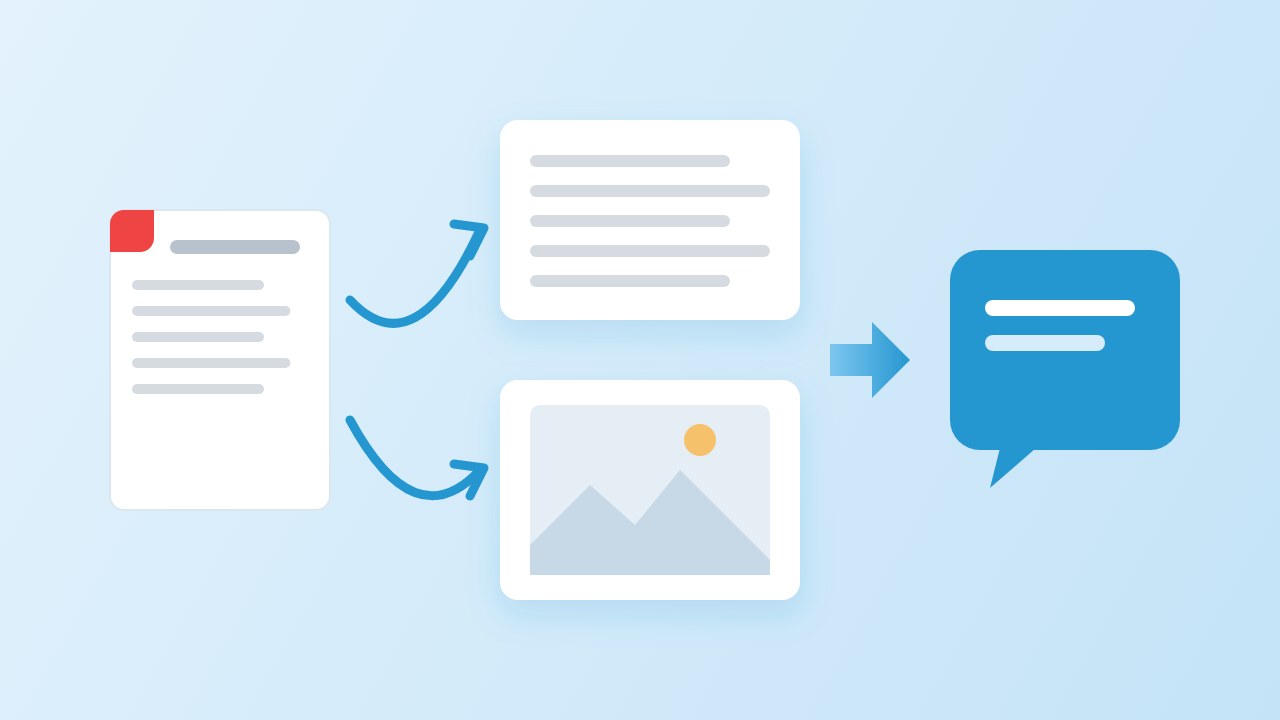
Questo è il nodo di Markdown o PDF per l'IA. Le immagini aiutano quando la pagina contiene un grafico o una firma scansionata, e costano in più: Anthropic stima da 1.500 a 3.000 token per pagina solo per il testo, immagini escluse, e OpenAI avverte che i PDF in input possono aumentare il consumo di token. Inoltre il testo estratto vale quanto il livello di testo del PDF: intestazioni ripetute, numeri di pagina e tabelle spezzate arrivano così come sono. Entrambi i documenti descrivono le piattaforme per sviluppatori; le app di chat per il pubblico non pubblicano lo stesso livello di dettaglio.
Token: PDF vs Markdown e altri quattro formati
Per avere numeri sui token di un PDF rispetto al Markdown, il 19 ott 2026 abbiamo preso quattro PDF e trasformato ciascuno in sei formati di testo: la nostra conversione pulita in Markdown, testo semplice da pdftotext con e senza layout, HTML generato dal Markdown e JSON con un oggetto per blocco, indentato e minificato. Abbiamo contato i token con la libreria tiktoken di OpenAI (codifica o200k_base). La via del PDF in sé non l'abbiamo contata, perché ogni fornitore calcola le immagini delle pagine a modo suo.
| Documento | Markdown | Testo semplice | Testo con layout | HTML | JSON | JSON minificato |
|---|---|---|---|---|---|---|
| Guida in inglese, 5 pagine | 2.651 | 2.667 | 2.724 | 3.237 | 4.086 | 3.195 |
| Report in cinese, 11 pagine | 8.697 | 8.713 | 8.804 | 9.796 | 11.063 | 9.402 |
| Report in inglese, 4 pagine | 145 | 217 | 229 | 246 | 379 | 225 |
| Tabelle, 1 pagina | 106 | 99 | 102 | 211 | 265 | 154 |
| Tutti e quattro | 11.599 | 11.696 | 11.859 | 13.490 | 15.793 | 12.976 |
| Rispetto a Markdown | 1,00× | 1,01× | 1,02× | 1,16× | 1,36× | 1,12× |
La lettura onesta: Markdown e testo semplice costano quasi uguale. Sui quattro file il testo semplice era più grande del 1 %, e nel file di tabelle di una pagina persino un po' più piccolo, perché le barre verticali costano token. Il grande scarto sul report di 4 pagine viene dalla pulizia, non dalla sintassi: il testo semplice teneva quattro copie dell'intestazione ripetuta e quattro numeri di pagina. L'HTML costava il 16 % in più di Markdown, il JSON indentato il 36 % in più e il JSON minificato il 12 % in più.
Markdown quindi non è il miglior formato di file per ChatGPT perché sia minuscolo, ma perché la sua struttura non costa quasi nulla: il testo semplice consuma gli stessi token e butta via titoli e colonne delle tabelle.
Perché Markdown è meglio di JSON o HTML per gli LLM?
Allora, perché Markdown è meglio per gli LLM? Tre ragioni reggono. Primo, la struttura è visibile: una riga ## è una sezione, una riga | è una tabella, e un modello ne ha viste quantità enormi. Secondo, c'è poco rumore: niente tag di chiusura, niente virgolette attorno a ogni chiave, niente caratteri di escape. Terzo, le guide dei fornitori vanno nella stessa direzione. La GPT-4.1 Prompting Guide di OpenAI consiglia Markdown come punto di partenza per strutturare i prompt, osserva che JSON può essere più prolisso e richiede l'escape dei caratteri, e riporta che nei suoi test a contesto lungo JSON è andato male come contenitore di molti documenti, mentre XML è andato bene.
Su JSON o Markdown per gli LLM, quindi: usa JSON quando il risultato lo legge un programma o i dati sono un elenco di record con campi fissi. Usa Markdown per i documenti che un modello deve leggere e su cui deve ragionare. Se inserisci più documenti insieme, un semplice tag attorno a ogni file Markdown, per esempio <document title="…">, ti dà la separazione che offre XML senza convertire il contenuto.
Come preparare un documento per ChatGPT
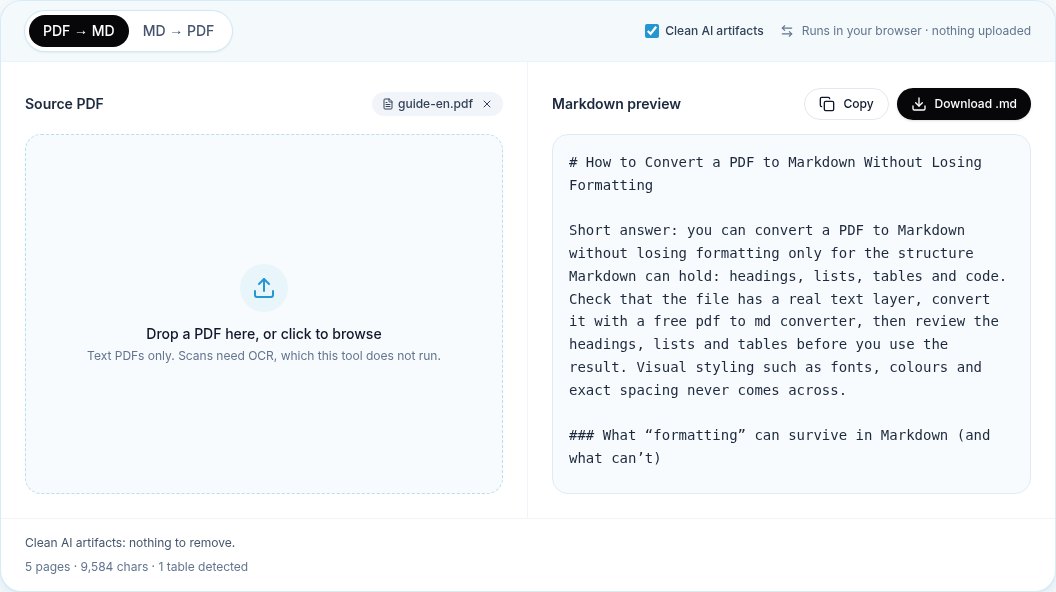
- Converti in Markdown un PDF con livello di testo, con la pulizia attiva, così spariscono intestazioni ripetute e numeri di pagina. Il nostro convertitore PDF in Markdown lo fa nel browser.
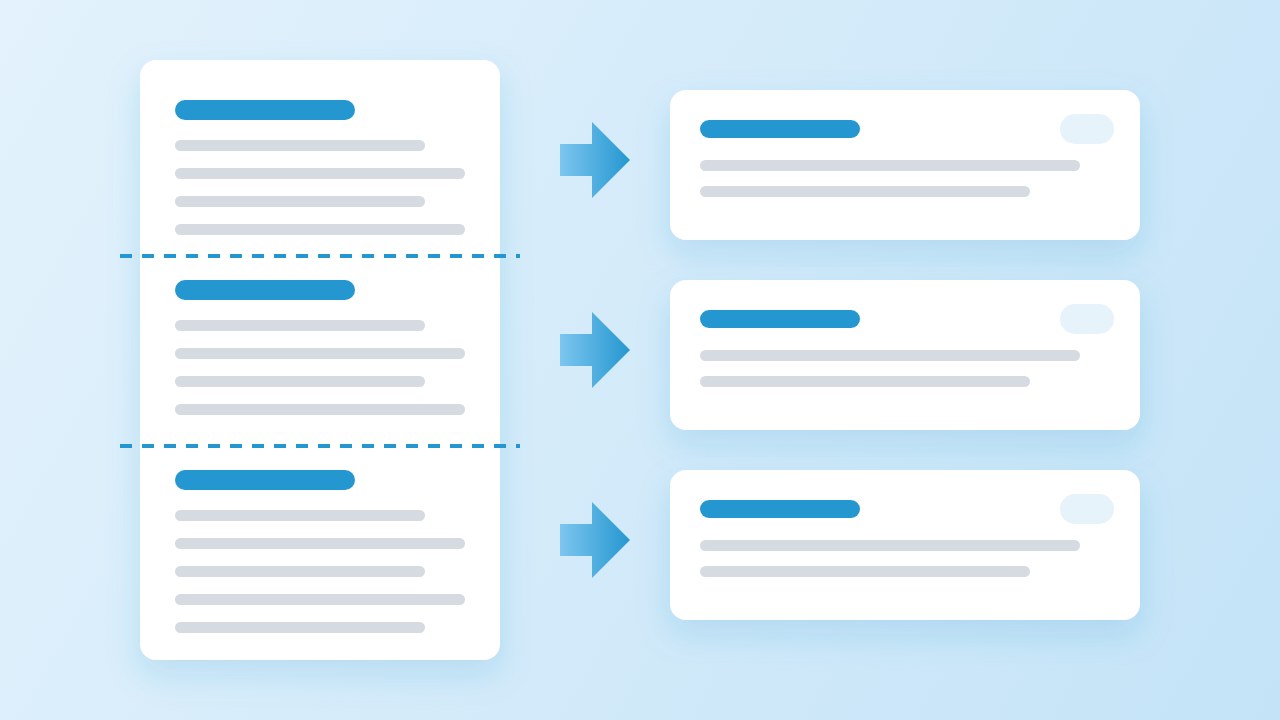
- Controlla la struttura: un titolo
#,##per le sezioni, le tabelle come tabelle con barre verticali. Correggi ogni titolo arrivato come testo normale. - Dividi i file lunghi ai titoli, non a un numero fisso di caratteri, così ogni pezzo inizia con il suo titolo. Conta soprattutto nei sistemi di recupero documenti (RAG).
- Prima il documento, la domanda alla fine. I consigli per il contesto lungo di Anthropic raccomandano quest'ordine e riferiscono che nei loro test ha migliorato le risposte fino al 30 %.
- Tieni a portata di mano il PDF per grafici e figure, e caricalo a parte quando una domanda riguarda un'immagine.
Per flussi automatici invece di chat singole, la strada con Python fa la stessa conversione nel codice, e la nostra guida alla conversione in locale spiega come tenere i file riservati sul tuo computer finché non decidi di inviarli.
Quando il PDF resta la scelta giusta
Markdown non è in ogni caso il formato che ChatGPT legge meglio. Tieni l'originale quando il significato sta nell'immagine: grafici e diagrammi, pagine scansionate (il Markdown di una scansione è vuoto finché nessuno esegue l'OCR), moduli in cui conta la posizione e slide il cui layout è il messaggio. In questi casi il PDF stesso è il miglior formato di file per ChatGPT: le immagini delle pagine aggiunte dal fornitore sono proprio quello che ti serve, e i token in più valgono la spesa.
Per un report lungo, il miglior formato di file per ChatGPT è spesso un mix: invia il Markdown per il testo e le due o tre pagine di grafici come PDF separato o come immagini. Così hai la versione strutturata ed economica per la maggior parte delle domande e quella visiva quando serve. Dai ai due file nomi chiari, per esempio report.md e report-grafici.pdf, e scrivi nel prompt quale contiene le figure, così il modello sa dove guardare prima di rispondere.
Fonti
- File inputs (PDF files) — OpenAI API documentation
- GPT-4.1 Prompting Guide — OpenAI Cookbook, 2025
- PDF support — Anthropic, Claude documentation
- Long context prompting tips — Anthropic, Claude documentation
- tiktoken — OpenAI, GitHub
Domande frequenti
Qual è il miglior formato di file per ChatGPT?
Per i documenti di testo, Markdown: conserva titoli, elenchi e tabelle e costa circa gli stessi token del testo semplice. Usa il PDF per grafici e scansioni, il CSV per i dati e il JSON per i record letti da un programma.
PDF o Markdown: qual è il miglior formato di file per ChatGPT?
Incolla o carica Markdown quando il contenuto è testo. Un PDF viene letto come testo estratto più immagini delle pagine; costa più token e lascia nel testo intestazioni, piè di pagina e numeri di pagina.
Markdown usa meno token del testo semplice?
Di poco. Nei nostri test i due sono rimasti entro circa l'1 % l'uno dall'altro su quattro file. Markdown era più piccolo solo dove il nostro convertitore aveva tolto intestazioni ripetute e numeri di pagina.
JSON è un buon formato per i documenti?
Non per la lettura. Nei nostri test il JSON indentato costava il 36 % di token in più di Markdown, e secondo la guida di OpenAI andava male con documenti a contesto lungo. Usalo per record strutturati.
ChatGPT sa leggere i PDF scansionati?
I modelli che vedono le immagini delle pagine possono leggere alcune pagine scansionate. Una conversione in Markdown di una scansione è vuota senza OCR, quindi per le scansioni invia il PDF o esegui prima un OCR.
Devo dividere un documento lungo prima di inviarlo?
Per una chat di solito basta un unico file ben strutturato. Per il recupero documenti o se arrivi ai limiti di contesto, dividi ai titoli così ogni parte conserva il suo titolo.

