ChatGPT에 가장 좋은 파일 형식, 실제 파일로 테스트했습니다
작성 pdftomd.tools 팀 · 업데이트 · 5분 분량
텍스트 문서라면 깔끔한 마크다운이 ChatGPT에 가장 좋은 파일 형식입니다. 제목, 목록, 표가 단순한 문자로 유지되고, 토큰은 일반 텍스트와 거의 같습니다. 차트나 페이지 레이아웃이 중요하면 PDF를 그대로 두세요. 마크다운은 LLM용 PDF 마크다운 변환 도구로 만들고 제목을 확인하면 됩니다.
짧은 답: ChatGPT에 가장 좋은 파일 형식은?
ChatGPT에 가장 좋은 파일 형식은 문서의 종류에 따라 다릅니다. 요약하면 다음과 같습니다.
| 내 콘텐츠 | 모델에 줄 형식 | 이유 |
|---|---|---|
| 보고서, 매뉴얼, 계약서, 메모 | 마크다운 | 구조(제목, 목록, 표)를 단순한 문자로 표현 |
| 구조 없는 줄글 | 일반 텍스트 | 비용은 마크다운과 같고 잃을 것이 없음 |
| 차트, 스캔본, 서식, 슬라이드 | PDF 그대로 | 모델이 페이지 이미지를 봐야 함 |
| 데이터 행 | CSV 또는 스프레드시트 | 한 행에 레코드 하나, 세기와 필터링이 쉬움 |
| 프로그램용 레코드 | JSON | 정확한 필드와 타입, 대신 토큰이 더 듦 |
이 글의 나머지 부분은 그 이유를 설명합니다. PDF를 업로드하면 모델이 실제로 무엇을 받는지, 같은 문서를 여섯 형식으로 바꿔 토큰을 세어 보니 어땠는지, 그리고 답변이 올바른 섹션에 근거하도록 파일을 준비하는 방법입니다.
PDF를 업로드하면 일어나는 일
ChatGPT에 가장 좋은 파일 형식을 고르려면 먼저 PDF가 어떻게 바뀌는지 봐야 합니다. PDF는 텍스트 파일이 아니라 페이지를 묘사한 파일입니다. 읽으려면 모델 제공사가 텍스트를 뽑아내야 하고, 주요 제공사는 페이지를 이미지로도 렌더링합니다. OpenAI의 파일 입력 가이드에 따르면, 이미지를 이해하는 모델에 PDF를 보내면 플랫폼이 텍스트와 각 페이지의 이미지를 모두 추출해 함께 모델에 넘깁니다. 다른 텍스트 파일은 텍스트로만 들어갑니다. Anthropic도 Claude에 대해 같은 방식을 설명합니다.
“시스템은 문서의 각 페이지를 이미지로 변환합니다. 각 페이지의 텍스트를 추출해 해당 페이지 이미지와 함께 제공합니다.”
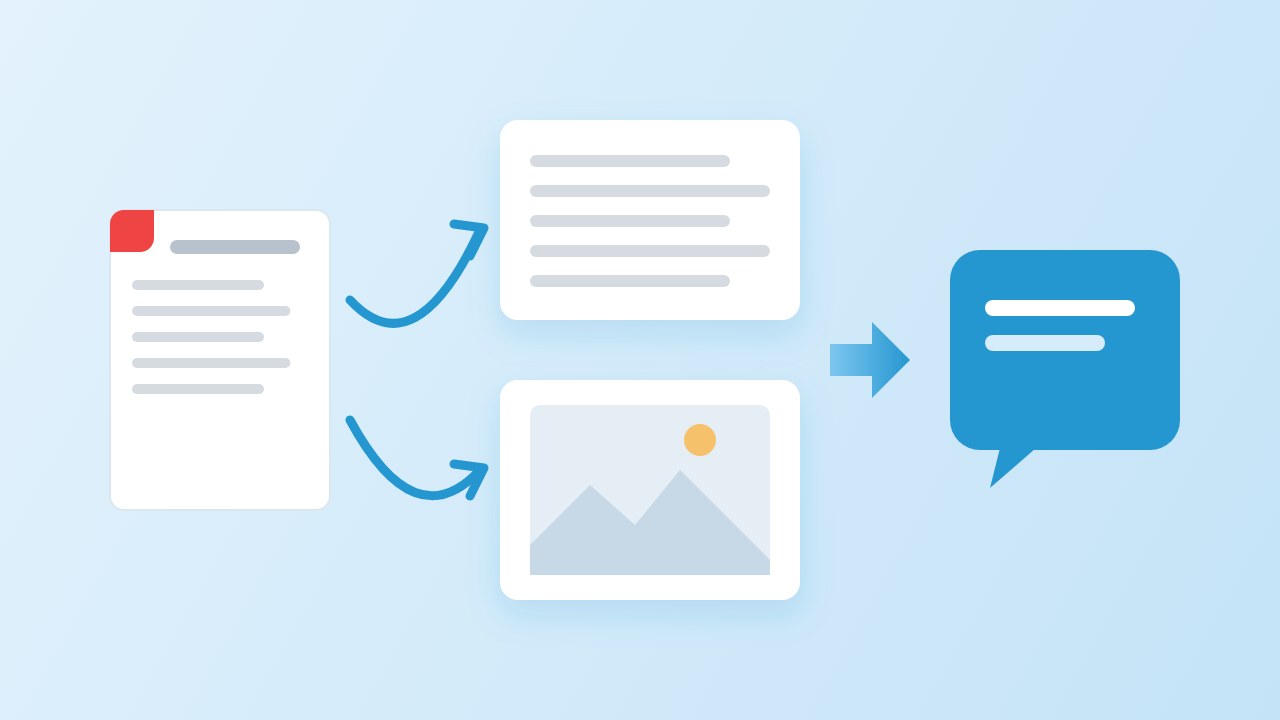
AI에 마크다운과 PDF 중 무엇을 줄지의 핵심이 여기 있습니다. 페이지에 차트나 스캔한 서명이 있으면 이미지가 도움이 되지만, 비용이 따로 듭니다. Anthropic은 이미지를 빼고 텍스트만으로도 페이지당 1,500~3,000토큰으로 추정하고, OpenAI도 PDF 입력이 토큰 사용량을 늘릴 수 있다고 안내합니다. 게다가 추출된 텍스트는 PDF 텍스트 레이어의 품질을 넘지 못해서, 반복되는 머리글, 쪽 번호, 깨진 표가 그대로 들어옵니다. 두 문서 모두 개발자용 플랫폼을 설명하며, 일반 사용자용 채팅 앱은 같은 수준의 세부 정보를 공개하지 않습니다.
토큰: PDF vs 마크다운, 그리고 다른 네 가지 형식
PDF와 마크다운의 토큰 수를 비교하려고 2026년 10월 19일에 PDF 네 개를 골라 각각 여섯 가지 텍스트 형식으로 바꿨습니다. 저희의 깔끔한 마크다운 변환, pdftotext의 레이아웃 유지/미유지 일반 텍스트, 마크다운에서 렌더링한 HTML, 블록마다 객체 하나인 JSON(들여쓰기판과 축소판)입니다. 토큰은 OpenAI의 tiktoken 라이브러리(인코딩 o200k_base)로 셌습니다. PDF 경로 자체는 세지 않았는데, 제공사마다 페이지 이미지를 계산하는 방식이 다르기 때문입니다.
| 문서 | 마크다운 | 일반 텍스트 | 레이아웃 유지 텍스트 | HTML | JSON | JSON(축소) |
|---|---|---|---|---|---|---|
| 영어 가이드, 5쪽 | 2,651 | 2,667 | 2,724 | 3,237 | 4,086 | 3,195 |
| 중국어 보고서, 11쪽 | 8,697 | 8,713 | 8,804 | 9,796 | 11,063 | 9,402 |
| 영어 보고서, 4쪽 | 145 | 217 | 229 | 246 | 379 | 225 |
| 표, 1쪽 | 106 | 99 | 102 | 211 | 265 | 154 |
| 네 개 합계 | 11,599 | 11,696 | 11,859 | 13,490 | 15,793 | 12,976 |
| 마크다운 대비 | 1.00× | 1.01× | 1.02× | 1.16× | 1.36× | 1.12× |
솔직하게 읽으면, 마크다운과 일반 텍스트의 비용은 거의 같습니다. 네 파일 전체로 일반 텍스트가 1% 컸고, 한 쪽짜리 표 파일에서는 세로 막대가 토큰을 쓰기 때문에 오히려 조금 작았습니다. 4쪽 보고서에서 차이가 크게 난 것은 문법이 아니라 정리 덕분입니다. 일반 텍스트에는 반복 머리글 네 개와 쪽 번호 네 개가 남아 있었습니다. HTML은 마크다운보다 16%, 들여쓴 JSON은 36%, 축소한 JSON은 12% 더 들었습니다.
그러니 마크다운이 ChatGPT에 가장 좋은 파일 형식인 이유는 크기가 작아서가 아니라, 구조를 거의 공짜로 담기 때문입니다. 일반 텍스트는 같은 토큰을 쓰면서 제목과 표의 열을 버립니다.
LLM에는 왜 JSON이나 HTML보다 마크다운이 나을까?
그럼 LLM에 마크다운이 더 나은 이유는 무엇일까요? 설득력 있는 이유가 세 가지 있습니다. 첫째, 구조가 눈에 보입니다. ## 줄은 섹션이고 | 줄은 표이며, 모델은 둘 다 엄청나게 많이 봤습니다. 둘째, 군더더기가 적습니다. 닫는 태그도, 모든 키를 감싸는 따옴표도, 이스케이프 문자도 없습니다. 셋째, 제공사 가이드도 같은 방향을 가리킵니다. OpenAI의 GPT-4.1 Prompting Guide는 프롬프트 구조의 출발점으로 마크다운을 권하고, JSON은 장황해질 수 있으며 문자를 이스케이프해야 한다고 지적합니다. 또 긴 컨텍스트 테스트에서 여러 문서를 담는 그릇으로 JSON은 성적이 나빴고 XML은 좋았다고 보고합니다.
그래서 LLM에 JSON과 마크다운 중 무엇을 쓸지는 이렇게 정리됩니다. 결과를 프로그램이 읽거나 데이터가 고정 필드를 가진 레코드 목록이라면 JSON을 쓰세요. 모델이 읽고 따져 봐야 하는 문서라면 마크다운을 쓰세요. 여러 문서를 한 번에 넣는다면 각 마크다운 파일을 <document title="…"> 같은 간단한 태그로 감싸면, 내용을 변환하지 않고도 XML이 주는 구분을 얻을 수 있습니다.
ChatGPT용 문서 준비하는 법
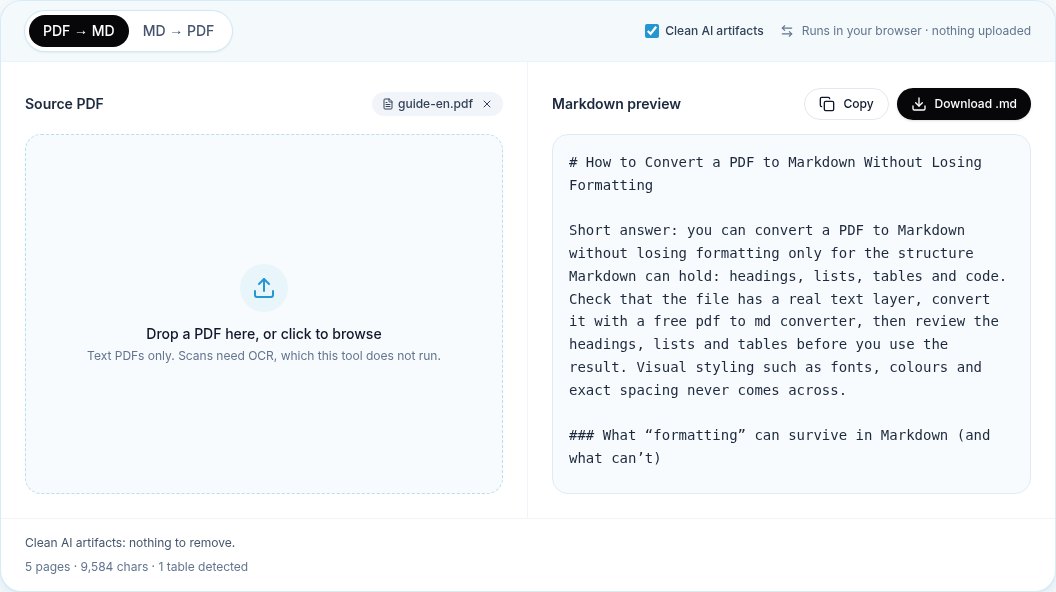
- 텍스트 레이어가 있는 PDF를 마크다운으로 변환하세요. 정리 기능을 켜면 반복 머리글과 쪽 번호가 사라집니다. 저희 PDF 마크다운 변환 도구가 브라우저에서 처리합니다.
- 구조를 확인하세요.
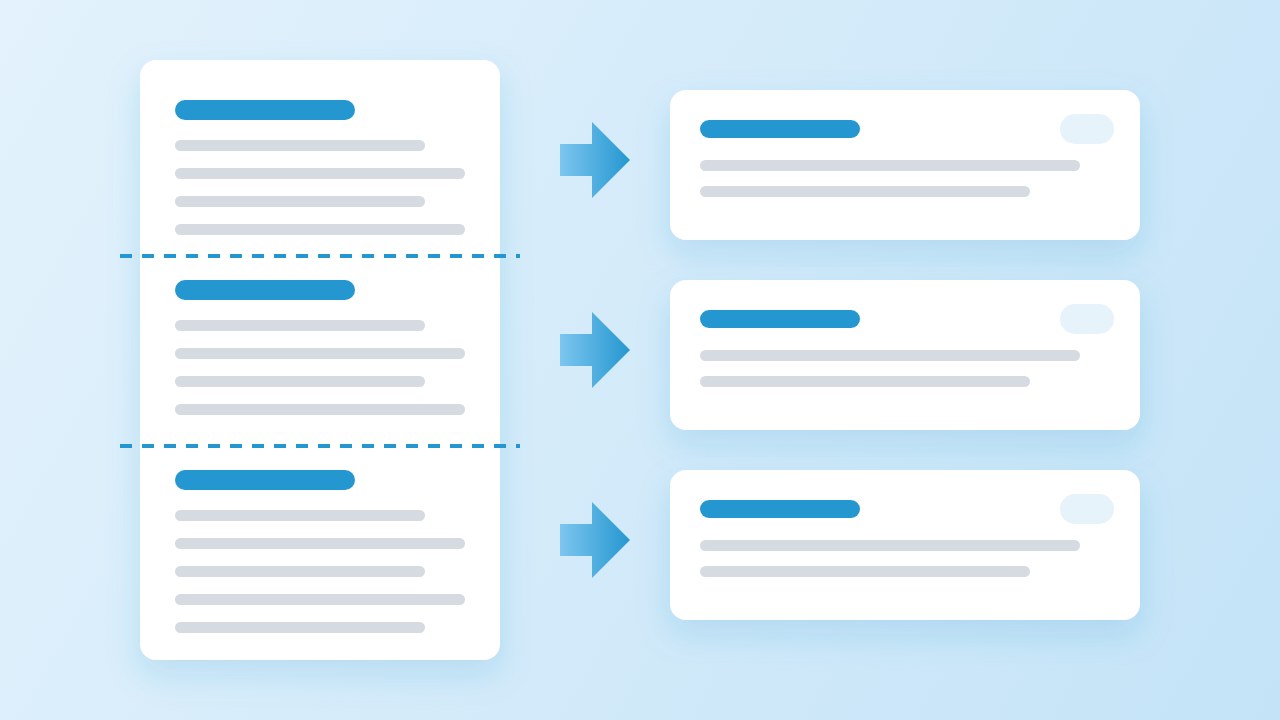
#제목 하나, 섹션은##, 표는 파이프 표로. 일반 텍스트로 넘어온 제목은 고쳐 주세요. - 긴 파일은 제목 단위로 나누세요. 고정 글자 수로 자르지 말고, 각 조각이 자기 제목으로 시작하게 하세요. 특히 검색 기반 시스템(RAG)에서 중요합니다.
- 문서를 먼저, 질문은 마지막에. Anthropic의 긴 컨텍스트 팁은 이 순서를 권하며, 테스트에서 답변이 최대 30% 좋아졌다고 밝힙니다.
- PDF도 함께 갖고 계세요. 차트와 그림이 필요할 때, 이미지에 관한 질문이면 따로 업로드하세요.
단발성 채팅이 아니라 파이프라인이라면 파이썬 방식으로 같은 변환을 코드로 할 수 있고, 로컬 변환 가이드는 보내기로 결정할 때까지 기밀 파일을 내 컴퓨터에 두는 방법을 알려 줍니다.
그래도 PDF가 맞는 경우
마크다운이 언제나 ChatGPT가 가장 잘 읽는 형식은 아닙니다. 의미가 이미지에 담겨 있을 때는 원본을 쓰세요. 차트와 다이어그램, 스캔한 페이지(누군가 OCR을 돌리기 전까지 스캔본의 마크다운은 비어 있습니다), 위치가 중요한 서식, 레이아웃 자체가 메시지인 슬라이드가 그렇습니다. 이런 경우에는 PDF 자체가 ChatGPT에 가장 좋은 파일 형식입니다. 제공사가 덧붙이는 페이지 이미지가 바로 필요한 것이고, 추가 토큰은 그만한 가치가 있습니다.
긴 보고서라면 섞어 쓰는 것이 ChatGPT에 가장 좋은 파일 형식인 경우가 많습니다. 본문은 마크다운으로 보내고, 차트가 있는 두세 쪽은 별도 PDF나 이미지로 보내세요. 그러면 대부분의 질문에는 구조가 잡힌 저렴한 버전을, 중요할 때는 시각 자료를 쓸 수 있습니다. 두 파일 이름을 report.md, report-charts.pdf처럼 분명하게 짓고, 그림이 어느 파일에 있는지 프롬프트에 적어 두면 모델이 답하기 전에 어디를 봐야 할지 압니다.
출처
- File inputs (PDF files) — OpenAI API documentation
- GPT-4.1 Prompting Guide — OpenAI Cookbook, 2025
- PDF support — Anthropic, Claude documentation
- Long context prompting tips — Anthropic, Claude documentation
- tiktoken — OpenAI, GitHub
자주 묻는 질문
ChatGPT에 가장 좋은 파일 형식은 무엇인가요?
텍스트 문서라면 마크다운입니다. 제목, 목록, 표를 유지하면서 토큰은 일반 텍스트와 비슷합니다. 차트와 스캔본은 PDF, 데이터는 CSV, 프로그램이 읽을 레코드는 JSON을 쓰세요.
PDF와 마크다운 중 ChatGPT에 가장 좋은 파일 형식은?
내용이 텍스트라면 마크다운을 붙여 넣거나 업로드하세요. PDF는 추출된 텍스트와 페이지 이미지로 읽히기 때문에 토큰이 더 들고, 머리글, 바닥글, 쪽 번호가 텍스트에 남습니다.
마크다운이 일반 텍스트보다 토큰을 덜 쓰나요?
거의 차이가 없습니다. 저희 테스트에서 네 파일 기준 둘의 차이는 약 1% 이내였습니다. 마크다운이 더 작았던 것은 저희 변환기가 반복 머리글과 쪽 번호를 지운 경우뿐이었습니다.
JSON은 문서에 좋은 형식인가요?
읽기용으로는 아닙니다. 저희 테스트에서 들여쓴 JSON은 마크다운보다 토큰이 36% 더 들었고, OpenAI 가이드에 따르면 긴 컨텍스트 문서에서 성적이 나빴습니다. 구조화된 레코드에 쓰세요.
ChatGPT는 스캔한 PDF를 읽을 수 있나요?
페이지 이미지를 보는 모델은 일부 스캔 페이지를 읽을 수 있습니다. 스캔본을 마크다운으로 변환하면 OCR 없이는 비어 있으므로, 스캔본은 PDF를 보내거나 먼저 OCR을 돌리세요.
긴 문서는 보내기 전에 나눠야 하나요?
채팅이라면 보통 구조가 잘 잡힌 파일 하나로 충분합니다. 검색 시스템에 쓰거나 컨텍스트 한도에 걸린다면 제목 단위로 나눠 각 부분이 제목을 유지하게 하세요.

