O melhor formato de arquivo para o ChatGPT, testado com arquivos reais
Por Equipe pdftomd.tools · Atualizado em · 8 min de leitura
Para documentos de texto, um Markdown limpo é o melhor formato de arquivo para o ChatGPT: títulos, listas e tabelas ficam como caracteres simples, e ele custa mais ou menos os mesmos tokens que texto puro. Fique com o PDF quando gráficos ou o layout da página importarem. Para gerar o Markdown, passe o arquivo por um conversor de PDF em Markdown para LLM e confira os títulos.
Resposta curta: qual é o melhor formato de arquivo para o ChatGPT?
O melhor formato de arquivo para o ChatGPT depende do que é o documento. Resumindo:
| Seu conteúdo | Entregue ao modelo | Por quê |
|---|---|---|
| Relatórios, manuais, contratos, anotações | Markdown | A estrutura (títulos, listas, tabelas) em caracteres simples |
| Texto corrido sem estrutura | Texto puro | Mesmo custo do Markdown, nada a perder |
| Gráficos, digitalizações, formulários, slides | O próprio PDF | O modelo precisa das imagens das páginas |
| Linhas de dados | CSV ou uma planilha | Um registro por linha, fácil de contar e filtrar |
| Registros para um programa | JSON | Campos e tipos exatos, com custo maior em tokens |
O resto deste guia explica o porquê: o que o modelo realmente recebe quando você envia um PDF, o que medimos ao contar os tokens dos mesmos documentos em seis formatos, e como preparar um arquivo para a resposta se basear na seção certa.
O que acontece quando você envia um PDF
Para escolher o melhor formato de arquivo para o ChatGPT, veja primeiro no que um PDF se transforma. Um PDF é uma descrição de páginas, não um arquivo de texto. Para lê-lo, o fornecedor do modelo precisa extrair o texto, e os grandes fornecedores também renderizam as páginas como imagens. Segundo o guia de arquivos de entrada da OpenAI, com um PDF enviado a um modelo que entende imagens, a plataforma extrai tanto o texto quanto uma imagem de cada página e manda as duas coisas para o modelo; outros arquivos de texto entram só como texto. A Anthropic descreve a mesma abordagem para o Claude:
“O sistema converte cada página do documento em uma imagem. O texto de cada página é extraído e fornecido junto com a imagem de cada página.”
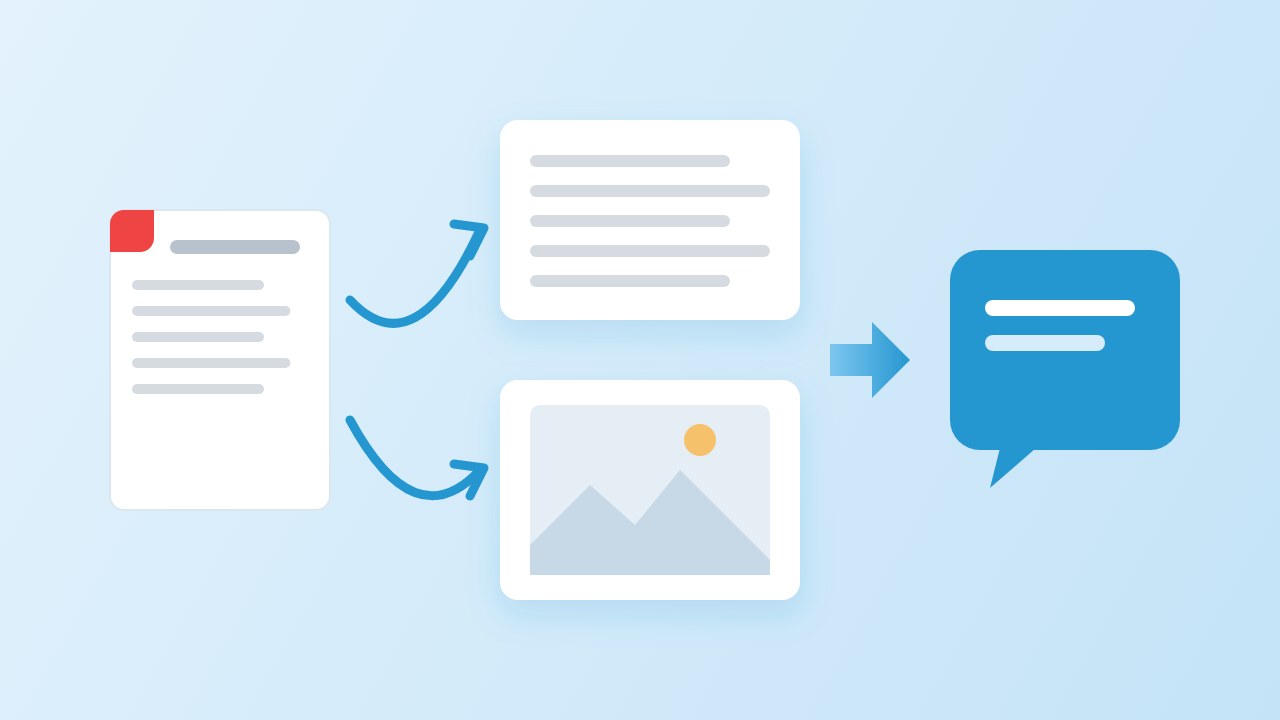
Esse é o ponto central de Markdown ou PDF para IA. As imagens ajudam quando a página tem um gráfico ou uma assinatura digitalizada, e custam à parte: a Anthropic estima de 1.500 a 3.000 tokens por página só para o texto, sem contar as imagens, e a OpenAI avisa que PDFs de entrada podem aumentar o consumo de tokens. Além disso, o texto extraído é tão bom quanto a camada de texto do PDF; cabeçalhos repetidos, números de página e tabelas quebradas chegam do jeito que estão. Os dois documentos descrevem as plataformas para desenvolvedores; os apps de chat para o público não publicam o mesmo nível de detalhe.
Tokens: PDF vs Markdown e mais quatro formatos
Para ter números de tokens de PDF em comparação com Markdown, em 19 de out. de 2026 pegamos quatro PDFs e transformamos cada um em seis formatos de texto: nossa conversão limpa para Markdown, texto puro do pdftotext com e sem layout, HTML gerado a partir do Markdown e JSON com um objeto por bloco, indentado e minificado. Contamos os tokens com a biblioteca tiktoken da OpenAI (codificação o200k_base). Não contamos o caminho do PDF em si, porque cada fornecedor calcula as imagens das páginas do seu jeito.
| Documento | Markdown | Texto puro | Texto com layout | HTML | JSON | JSON minificado |
|---|---|---|---|---|---|---|
| Guia em inglês, 5 páginas | 2.651 | 2.667 | 2.724 | 3.237 | 4.086 | 3.195 |
| Relatório em chinês, 11 páginas | 8.697 | 8.713 | 8.804 | 9.796 | 11.063 | 9.402 |
| Relatório em inglês, 4 páginas | 145 | 217 | 229 | 246 | 379 | 225 |
| Tabelas, 1 página | 106 | 99 | 102 | 211 | 265 | 154 |
| Os quatro | 11.599 | 11.696 | 11.859 | 13.490 | 15.793 | 12.976 |
| Em relação ao Markdown | 1,00× | 1,01× | 1,02× | 1,16× | 1,36× | 1,12× |
A leitura honesta: Markdown e texto puro custam quase o mesmo. Nos quatro arquivos, o texto puro ficou 1 % maior, e no arquivo de tabelas de uma página ficou até um pouco menor, porque as barras verticais custam tokens. A grande diferença no relatório de 4 páginas vem da limpeza, não da sintaxe: o texto puro manteve quatro cópias do cabeçalho repetido e quatro números de página. O HTML custou 16 % a mais que o Markdown, o JSON indentado 36 % a mais e o JSON minificado 12 % a mais.
Então o Markdown não é o melhor formato de arquivo para o ChatGPT por ser minúsculo, e sim porque a estrutura quase não custa nada: o texto puro gasta os mesmos tokens e joga fora os títulos e as colunas das tabelas.
Por que Markdown é melhor para LLMs do que JSON ou HTML?
Então, por que Markdown é melhor para LLMs? Três motivos se sustentam. Primeiro, a estrutura é visível: uma linha ## é uma seção, uma linha | é uma tabela, e um modelo já viu quantidades enormes das duas coisas. Segundo, há pouco ruído: sem tags de fechamento, sem aspas em volta de cada chave, sem caracteres escapados. Terceiro, os guias dos fornecedores apontam na mesma direção. O GPT-4.1 Prompting Guide da OpenAI recomenda Markdown como ponto de partida para estruturar prompts, observa que JSON pode ser mais verboso e exige escapar caracteres, e relata que nos testes de contexto longo o JSON foi mal como contêiner para muitos documentos, enquanto o XML foi bem.
Sobre JSON ou Markdown para LLMs, então: use JSON quando um programa for ler o resultado ou os dados forem uma lista de registros com campos fixos. Use Markdown para documentos que um modelo precisa ler e analisar. Se você mandar vários documentos de uma vez, uma tag simples em volta de cada arquivo Markdown, por exemplo <document title="…">, dá a separação que o XML oferece sem converter o conteúdo.
Como preparar um documento para o ChatGPT
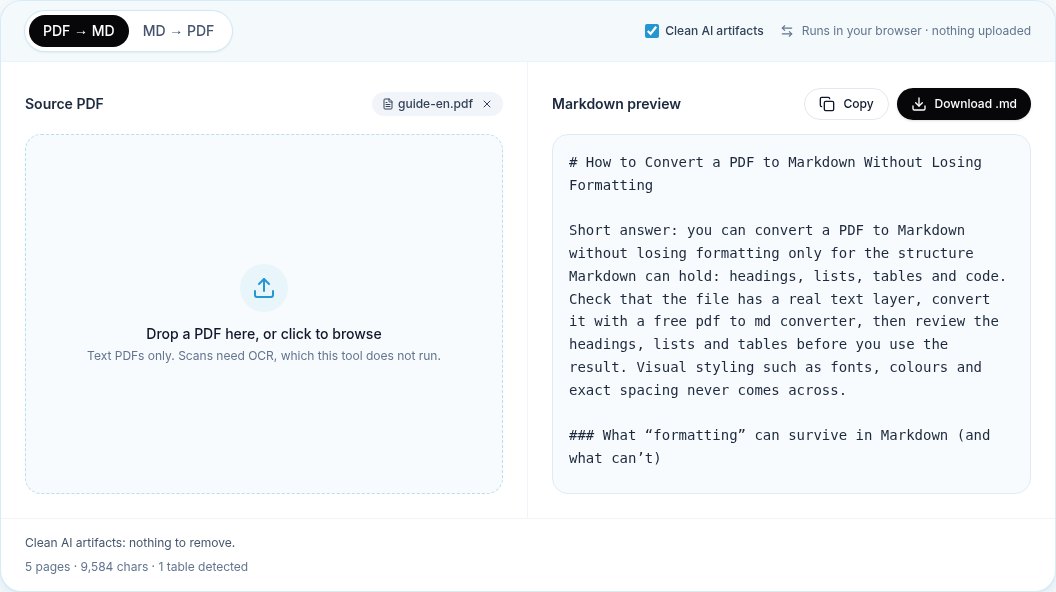
- Converta para Markdown um PDF com camada de texto, com a limpeza ligada, para sumir com cabeçalhos repetidos e números de página. Nosso conversor de PDF em Markdown faz isso no navegador.
- Confira a estrutura: um título
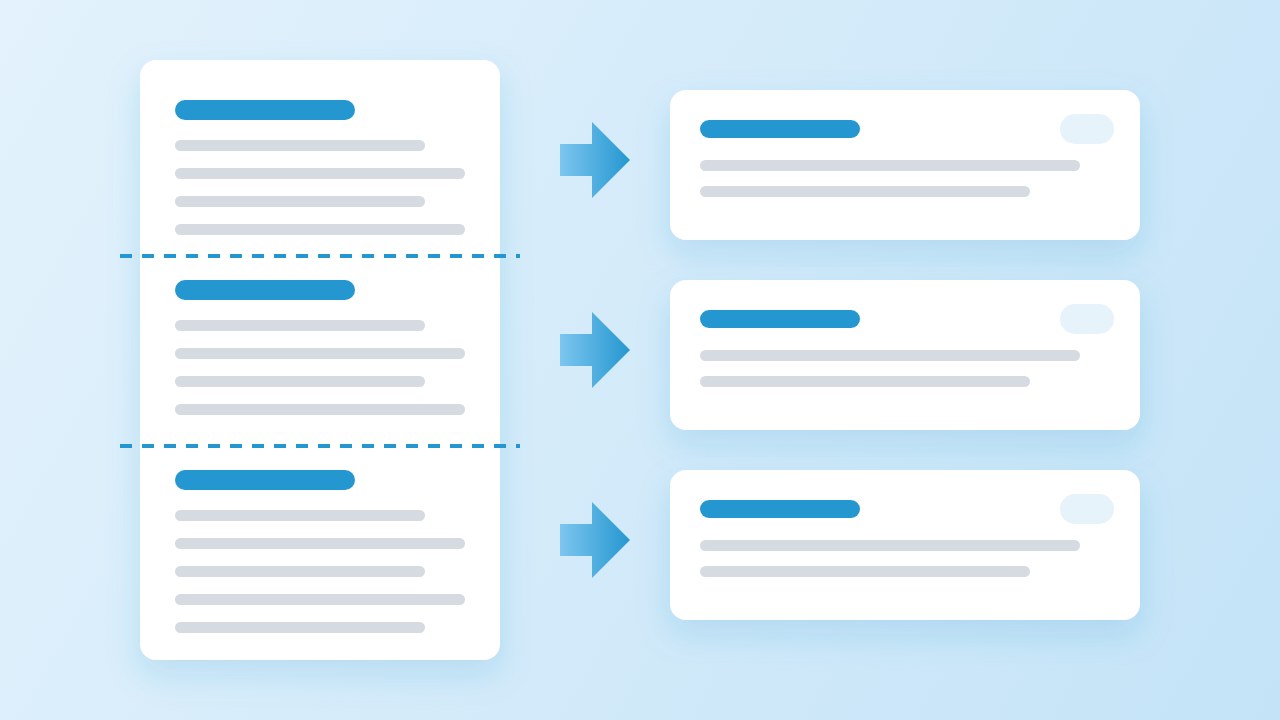
#,##para as seções, tabelas como tabelas com barras verticais. Corrija qualquer título que tenha vindo como texto comum. - Divida arquivos longos nos títulos, não por um número fixo de caracteres, para cada pedaço começar com o próprio título. Isso importa principalmente em sistemas de busca de documentos (RAG).
- Primeiro o documento, a pergunta no fim. As dicas para contexto longo da Anthropic recomendam essa ordem e dizem que ela melhorou as respostas em até 30 % nos testes deles.
- Deixe o PDF à mão para gráficos e figuras, e envie-o separado quando a pergunta for sobre uma imagem.
Para fluxos automáticos em vez de conversas avulsas, o caminho com Python faz a mesma conversão em código, e nosso guia de conversão local mostra como manter arquivos confidenciais no seu próprio computador até você decidir enviá-los.
Quando o PDF ainda é a escolha certa
O Markdown não é, em todos os casos, o formato que o ChatGPT lê melhor. Mantenha o original quando o sentido está na imagem: gráficos e diagramas, páginas digitalizadas (o Markdown de uma digitalização fica vazio enquanto ninguém rodar OCR), formulários em que a posição importa e slides cujo layout é a mensagem. Nesses casos, o próprio PDF é o melhor formato de arquivo para o ChatGPT: as imagens de página que o fornecedor adiciona são exatamente o que você precisa, e os tokens extras valem a pena.
Para um relatório longo, o melhor formato de arquivo para o ChatGPT costuma ser uma mistura: mande o Markdown para o texto e as duas ou três páginas com gráficos como um PDF separado ou como imagens. Assim você tem a versão estruturada e barata para a maioria das perguntas, e a visual quando ela faz diferença. Dê nomes claros aos dois arquivos, por exemplo relatorio.md e relatorio-graficos.pdf, e diga no prompt qual deles tem as figuras, para o modelo saber onde olhar antes de responder.
Fontes
- File inputs (PDF files) — OpenAI API documentation
- GPT-4.1 Prompting Guide — OpenAI Cookbook, 2025
- PDF support — Anthropic, Claude documentation
- Long context prompting tips — Anthropic, Claude documentation
- tiktoken — OpenAI, GitHub
Perguntas frequentes
Qual é o melhor formato de arquivo para o ChatGPT?
Para documentos de texto, Markdown: ele mantém títulos, listas e tabelas e custa mais ou menos os mesmos tokens que texto puro. Use o PDF para gráficos e digitalizações, CSV para dados e JSON para registros que um programa vai ler.
PDF ou Markdown: qual é o melhor formato de arquivo para o ChatGPT?
Cole ou envie Markdown quando o conteúdo for texto. Um PDF é lido como texto extraído mais imagens das páginas; isso custa mais tokens e deixa cabeçalhos, rodapés e números de página no texto.
O Markdown gasta menos tokens que texto puro?
Quase nada. Nos nossos testes, os dois ficaram a cerca de 1 % um do outro em quatro arquivos. O Markdown só ficou menor onde nosso conversor removeu cabeçalhos repetidos e números de página.
JSON é um bom formato para documentos?
Não para leitura. Nos nossos testes, o JSON indentado custou 36 % mais tokens que o Markdown, e segundo o guia da OpenAI foi mal com documentos de contexto longo. Use-o para registros estruturados.
O ChatGPT consegue ler PDFs digitalizados?
Modelos que veem as imagens das páginas conseguem ler algumas páginas digitalizadas. Uma conversão para Markdown de uma digitalização fica vazia sem OCR, então, com digitalizações, envie o PDF ou rode um OCR antes.
Devo dividir um documento longo antes de enviar?
Para uma conversa, um único arquivo bem estruturado costuma bastar. Para busca em documentos ou se você bater no limite de contexto, divida nos títulos para cada parte manter o seu título.

