Het beste bestandsformaat voor ChatGPT, getest met echte bestanden
Door pdftomd.tools-team · Bijgewerkt op · 7 min leestijd
Voor tekstdocumenten is schone Markdown het beste bestandsformaat voor ChatGPT: koppen, lijsten en tabellen blijven bewaard als eenvoudige tekens, en het kost ongeveer evenveel tokens als platte tekst. Houd de PDF als grafieken of de paginalay-out ertoe doen. Voor de Markdown haal je het bestand door een converter voor PDF naar Markdown voor LLM's en controleer je de koppen.
Kort antwoord: wat is het beste bestandsformaat voor ChatGPT?
Het beste bestandsformaat voor ChatGPT hangt af van wat het document is. Een kort overzicht:
| Jouw inhoud | Geef het model | Waarom |
|---|---|---|
| Rapporten, handleidingen, contracten, notities | Markdown | Structuur (koppen, lijsten, tabellen) in eenvoudige tekens |
| Doorlopende tekst zonder structuur | Platte tekst | Dezelfde kosten als Markdown, niets te verliezen |
| Grafieken, scans, formulieren, dia's | De PDF zelf | Het model heeft de paginabeelden nodig |
| Rijen met data | CSV of een spreadsheet | Eén record per rij, makkelijk te tellen en te filteren |
| Records voor een programma | JSON | Exacte velden en typen, tegen hogere tokenkosten |
De rest van deze gids legt uit waarom: wat het model echt krijgt als je een PDF uploadt, wat we maten toen we de tokens van dezelfde documenten in zes formaten telden, en hoe je een bestand zo voorbereidt dat het antwoord op de juiste sectie berust.
Wat er gebeurt als je een PDF uploadt
Om het beste bestandsformaat voor ChatGPT te kiezen, kijk je eerst wat er van een PDF wordt. Een PDF is een paginabeschrijving, geen tekstbestand. Om hem te lezen moet een modelaanbieder de tekst eruit halen, en de grote aanbieders renderen de pagina's ook als afbeeldingen. Volgens de gids over invoerbestanden van OpenAI haalt het platform bij een PDF voor een model dat beelden begrijpt zowel de tekst als een afbeelding van elke pagina eruit en stuurt het beide naar het model; andere tekstbestanden gaan er alleen als tekst in. Anthropic beschrijft dezelfde aanpak voor Claude:
“Het systeem zet elke pagina van het document om in een afbeelding. De tekst van elke pagina wordt geëxtraheerd en samen met de afbeelding van die pagina aangeleverd.”
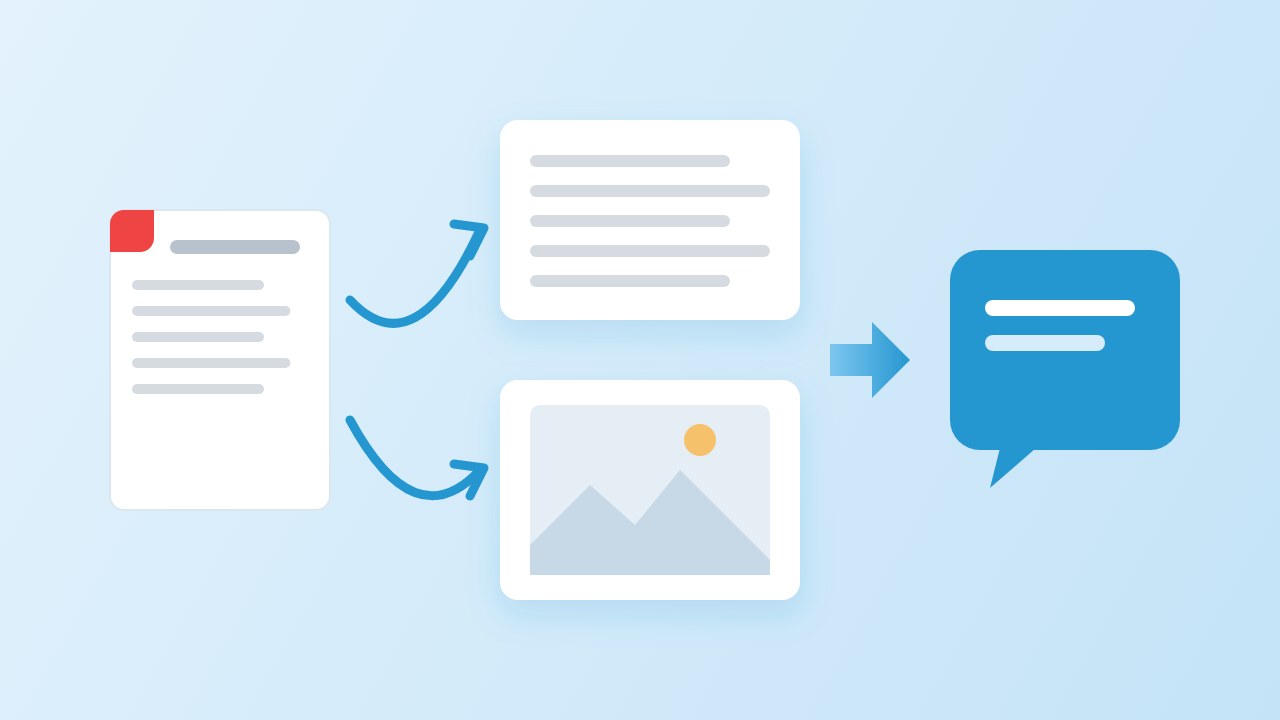
Dat is de kern van Markdown of PDF voor AI. De afbeeldingen helpen als de pagina een grafiek of een gescande handtekening bevat, en ze kosten extra: Anthropic schat 1.500 tot 3.000 tokens per pagina alleen voor de tekst, nog zonder de afbeeldingen, en OpenAI wijst erop dat PDF-invoer het tokengebruik kan verhogen. De uitgelezen tekst is bovendien maar zo goed als de tekstlaag van de PDF; terugkerende kopteksten, paginanummers en kapotte tabellen komen binnen zoals ze zijn. Beide documenten beschrijven de platforms voor ontwikkelaars; de chat-apps voor gewone gebruikers publiceren niet hetzelfde detailniveau.
Tokens: PDF vs Markdown en vier andere formaten
Om cijfers te krijgen over tokens bij PDF tegenover Markdown, namen we op 19 okt. 2026 vier PDF's en zetten we elk om in zes tekstformaten: onze schone Markdown-conversie, platte tekst uit pdftotext met en zonder lay-out, HTML gerenderd uit de Markdown, en JSON met één object per blok, opgemaakt en geminificeerd. De tokens telden we met de tiktoken-bibliotheek van OpenAI (codering o200k_base). De PDF-route zelf telden we niet, omdat elke aanbieder de paginabeelden op zijn eigen manier rekent.
| Document | Markdown | Platte tekst | Tekst met lay-out | HTML | JSON | JSON, geminificeerd |
|---|---|---|---|---|---|---|
| Engelse handleiding, 5 pagina's | 2.651 | 2.667 | 2.724 | 3.237 | 4.086 | 3.195 |
| Chinees rapport, 11 pagina's | 8.697 | 8.713 | 8.804 | 9.796 | 11.063 | 9.402 |
| Engels rapport, 4 pagina's | 145 | 217 | 229 | 246 | 379 | 225 |
| Tabellen, 1 pagina | 106 | 99 | 102 | 211 | 265 | 154 |
| Alle vier | 11.599 | 11.696 | 11.859 | 13.490 | 15.793 | 12.976 |
| Ten opzichte van Markdown | 1,00× | 1,01× | 1,02× | 1,16× | 1,36× | 1,12× |
De eerlijke lezing: Markdown en platte tekst kosten bijna hetzelfde. Over alle vier bestanden was platte tekst 1 % groter, en bij het tabellenbestand van één pagina zelfs iets kleiner, omdat verticale strepen tokens kosten. Het grote verschil bij het rapport van 4 pagina's komt van het opschonen, niet van de syntax: de platte tekst hield vier kopieën van de terugkerende koptekst en vier paginanummers. HTML kostte 16 % meer dan Markdown, opgemaakte JSON 36 % meer en geminificeerde JSON 12 % meer.
Markdown is dus niet het beste bestandsformaat voor ChatGPT omdat het piepklein is, maar omdat de structuur bijna niets kost: platte tekst gebruikt dezelfde tokens en gooit koppen en tabelkolommen weg.
Waarom is Markdown beter voor LLM's dan JSON of HTML?
Waarom is Markdown dan beter voor LLM's? Drie redenen houden stand. Ten eerste is de structuur zichtbaar: een ##-regel is een sectie, een |-regel een tabel, en een model heeft van allebei enorme hoeveelheden gezien. Ten tweede is er weinig ruis: geen sluitende tags, geen aanhalingstekens rond elke sleutel, geen ge-escapete tekens. Ten derde wijzen de gidsen van de aanbieders dezelfde kant op. De GPT-4.1 Prompting Guide van OpenAI raadt Markdown aan als startpunt voor de structuur van prompts, merkt op dat JSON omslachtiger kan zijn en tekens moet escapen, en meldt dat JSON in zijn tests met lange context slecht scoorde als container voor veel documenten, terwijl XML het goed deed.
Dus, JSON of Markdown voor LLM's: neem JSON als een programma het resultaat leest of als de data een lijst records met vaste velden is. Neem Markdown voor documenten die een model moet lezen en doordenken. Geef je meerdere documenten tegelijk mee, dan geeft een eenvoudige tag rond elk Markdown-bestand, bijvoorbeeld <document title="…">, je de scheiding die XML biedt zonder de inhoud om te zetten.
Zo bereid je een document voor op ChatGPT
- Zet een PDF met tekstlaag om naar Markdown, met opschonen aan, zodat terugkerende kopteksten en paginanummers verdwijnen. Onze converter voor PDF naar Markdown doet dat in de browser.
- Controleer de structuur: één
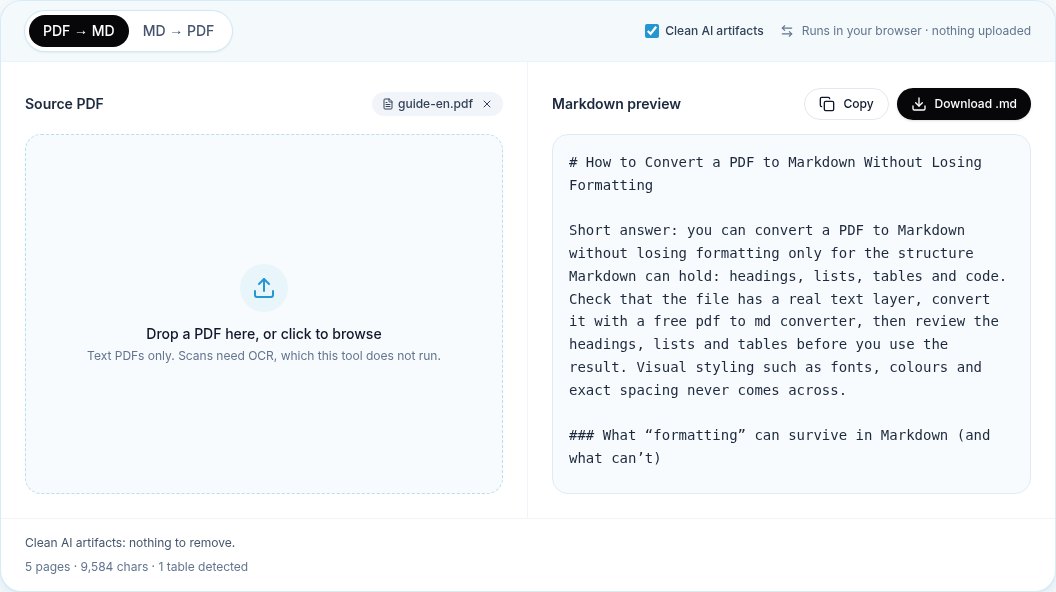
#-titel,##voor secties, tabellen als pipe-tabellen. Verbeter elke kop die als gewone tekst is doorgekomen. - Splits lange bestanden bij koppen, niet na een vast aantal tekens, zodat elk stuk met zijn eigen titel begint. Dat telt vooral bij retrievalsystemen (RAG).
- Eerst het document, de vraag als laatste. De tips voor lange context van Anthropic raden die volgorde aan en melden dat die de antwoorden in hun tests tot 30 procent verbeterde.
- Houd de PDF bij de hand voor grafieken en figuren, en upload hem apart als een vraag over een afbeelding gaat.
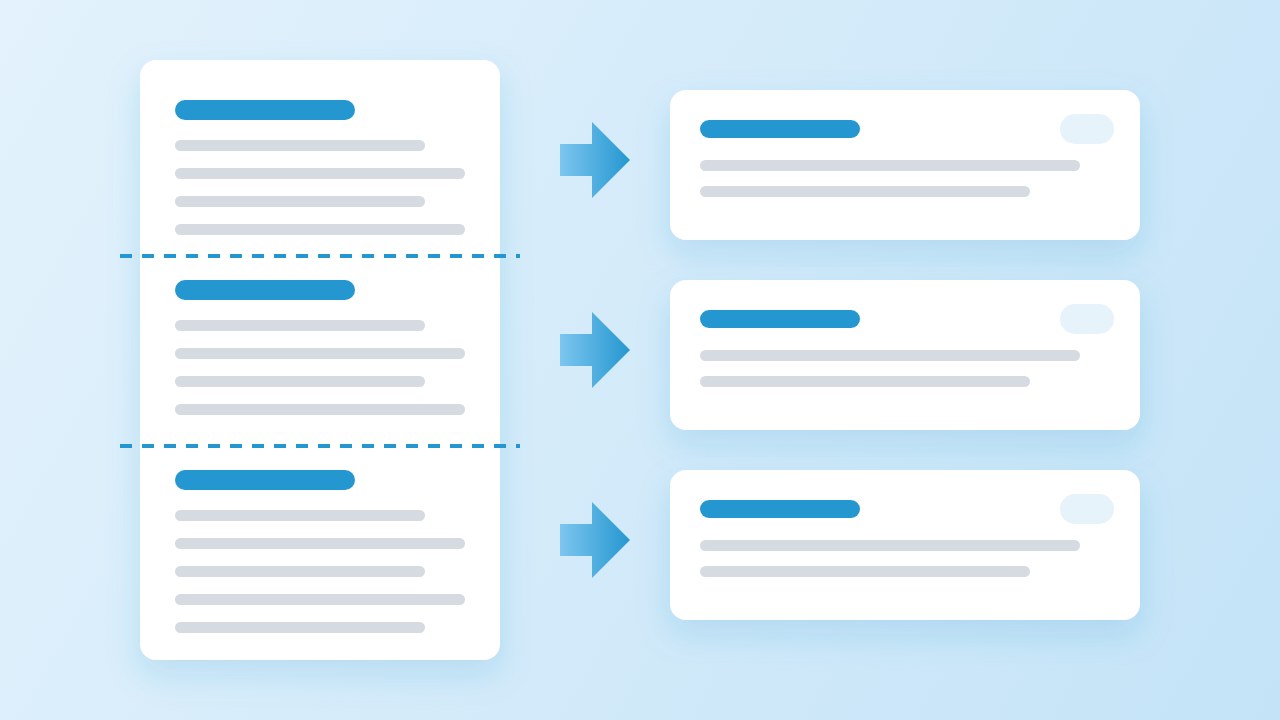
Voor pipelines in plaats van losse chats doet de Python-route dezelfde conversie in code, en onze gids voor lokaal converteren laat zien hoe vertrouwelijke bestanden op je eigen computer blijven tot je ze bewust verstuurt.
Wanneer de PDF toch de juiste keuze is
Markdown is niet in elk geval het formaat dat ChatGPT het best leest. Houd het origineel als de betekenis in het beeld zit: grafieken en diagrammen, gescande pagina's (Markdown uit een scan is leeg zolang niemand OCR draait), formulieren waarbij de positie telt, en dia's waarvan de lay-out de boodschap is. In die gevallen is de PDF zelf het beste bestandsformaat voor ChatGPT: de paginabeelden die de aanbieder toevoegt zijn precies wat je nodig hebt, en de extra tokens zijn het waard.
Bij een lang rapport is een mix vaak het beste bestandsformaat voor ChatGPT: stuur de Markdown voor de tekst en de twee of drie pagina's met grafieken als aparte PDF of als afbeeldingen. Zo heb je voor de meeste vragen de goedkope, gestructureerde versie, en de visuele als het erop aankomt. Geef de twee bestanden duidelijke namen, zoals rapport.md en rapport-grafieken.pdf, en zeg in de prompt welke de figuren bevat, zodat het model weet waar het moet kijken voordat het antwoordt.
Bronnen
- File inputs (PDF files) — OpenAI API documentation
- GPT-4.1 Prompting Guide — OpenAI Cookbook, 2025
- PDF support — Anthropic, Claude documentation
- Long context prompting tips — Anthropic, Claude documentation
- tiktoken — OpenAI, GitHub
Veelgestelde vragen
Wat is het beste bestandsformaat voor ChatGPT?
Voor tekstdocumenten Markdown: het behoudt koppen, lijsten en tabellen en kost ongeveer evenveel tokens als platte tekst. Neem de PDF voor grafieken en scans, CSV voor data en JSON voor records die een programma leest.
Is PDF of Markdown het beste bestandsformaat voor ChatGPT?
Plak of upload Markdown als de inhoud tekst is. Een PDF wordt gelezen als uitgelezen tekst plus paginabeelden; dat kost meer tokens en laat kop- en voetteksten en paginanummers in de tekst staan.
Gebruikt Markdown minder tokens dan platte tekst?
Nauwelijks. In onze tests lagen ze over vier bestanden binnen ongeveer 1 % van elkaar. Markdown was alleen kleiner waar onze converter terugkerende kopteksten en paginanummers had verwijderd.
Is JSON een goed formaat voor documenten?
Niet om te lezen. In onze tests kostte opgemaakte JSON 36 % meer tokens dan Markdown, en volgens de gids van OpenAI scoorde het slecht bij documenten met lange context. Gebruik het voor gestructureerde records.
Kan ChatGPT gescande PDF's lezen?
Modellen die paginabeelden zien, kunnen sommige gescande pagina's lezen. Een Markdown-conversie van een scan is leeg zonder OCR; stuur bij scans dus de PDF of draai eerst OCR.
Moet ik een lang document splitsen voor ik het stuur?
Voor een chat is één goed gestructureerd bestand meestal genoeg. Voor retrieval of als je tegen contextlimieten aanloopt, splits je bij koppen zodat elk deel zijn titel houdt.

