Das beste Dateiformat für ChatGPT, getestet mit echten Dateien
Von pdftomd.tools-Team · Aktualisiert am · 7 Min. Lesezeit
Für Textdokumente ist sauberes Markdown das beste Dateiformat für ChatGPT: Überschriften, Listen und Tabellen bleiben als einfache Zeichen erhalten, und es kostet etwa so viele Tokens wie reiner Text. Behalte die PDF, wenn Diagramme oder das Seitenlayout zählen. Für das Markdown schickst du die Datei durch einen Konverter für PDF in Markdown für LLMs und prüfst die Überschriften.
Kurze Antwort: Was ist das beste Dateiformat für ChatGPT?
Das beste Dateiformat für ChatGPT hängt davon ab, was das Dokument ist. Ein kurzer Überblick:
| Dein Inhalt | Gib dem Modell | Warum |
|---|---|---|
| Berichte, Handbücher, Verträge, Notizen | Markdown | Struktur (Überschriften, Listen, Tabellen) in einfachen Zeichen |
| Fließtext ohne Struktur | Reinen Text | Gleiche Kosten wie Markdown, nichts zu verlieren |
| Diagramme, Scans, Formulare, Folien | Die PDF selbst | Das Modell braucht die Seitenbilder |
| Datenzeilen | CSV oder eine Tabellenkalkulation | Ein Datensatz pro Zeile, leicht zu zählen und zu filtern |
| Datensätze für ein Programm | JSON | Exakte Felder und Typen, bei höheren Token-Kosten |
Der Rest dieses Ratgebers erklärt die Gründe: was das Modell tatsächlich bekommt, wenn du eine PDF hochlädst, was wir gemessen haben, als wir die Tokens derselben Dokumente in sechs Formaten gezählt haben, und wie du eine Datei so vorbereitest, dass die Antwort auf dem richtigen Abschnitt beruht.
Was passiert, wenn du eine PDF hochlädst
Um das beste Dateiformat für ChatGPT zu wählen, schau zuerst, was aus einer PDF wird. Eine PDF ist eine Seitenbeschreibung, keine Textdatei. Um sie zu lesen, muss ein Modellanbieter den Text herausziehen, und die großen Anbieter rendern die Seiten zusätzlich als Bilder. Laut dem Leitfaden zu Dateieingaben von OpenAI extrahiert die API bei PDFs für Modelle mit Bildverständnis sowohl den Text als auch ein Bild jeder Seite und schickt beides an das Modell; andere Textdateien gehen nur als Text hinein. Anthropic beschreibt dasselbe Vorgehen für Claude:
“Das System wandelt jede Seite des Dokuments in ein Bild um. Der Text jeder Seite wird extrahiert und zusammen mit dem Bild der jeweiligen Seite bereitgestellt.”
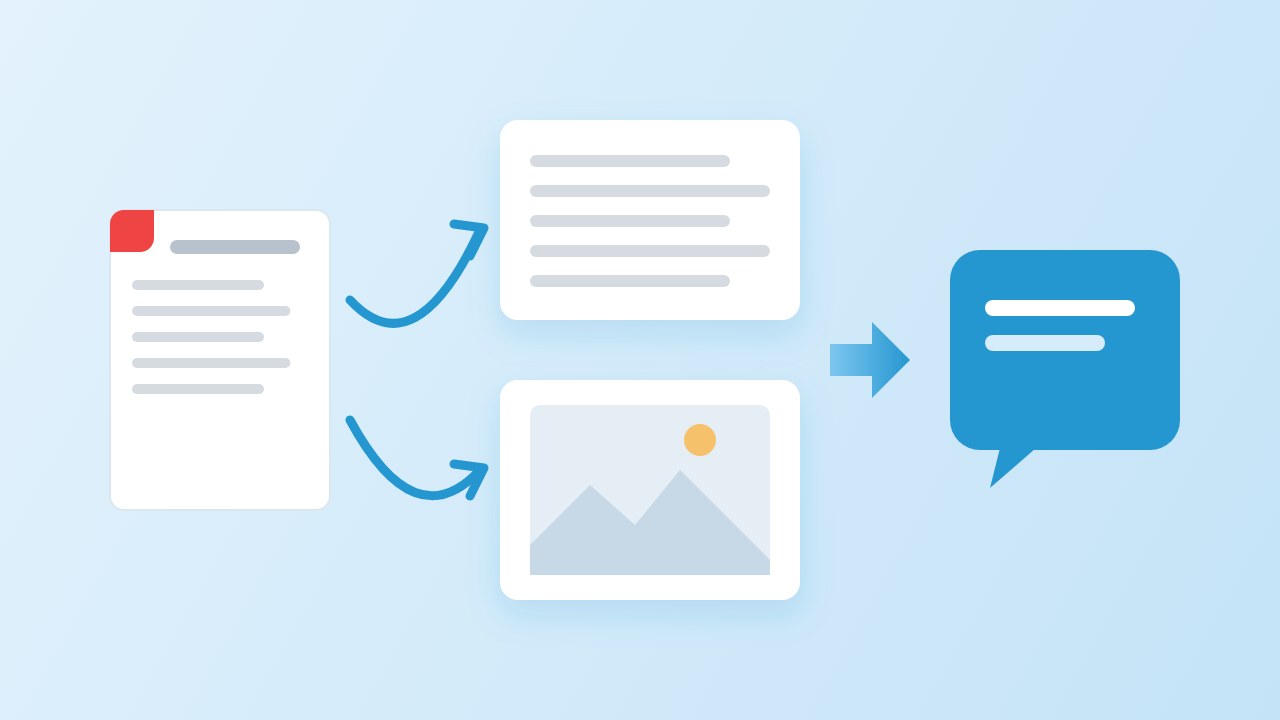
Das ist der Kern von Markdown vs. PDF für KI. Die Bilder helfen, wenn die Seite ein Diagramm oder eine gescannte Unterschrift enthält, und sie kosten extra: Anthropic schätzt 1.500 bis 3.000 Tokens pro Seite allein für den Text, noch ohne die Bilder, und OpenAI weist darauf hin, dass PDF-Eingaben den Token-Verbrauch erhöhen können. Der ausgelesene Text ist außerdem nur so gut wie die Textebene der PDF; laufende Kopfzeilen, Seitenzahlen und zerbrochene Tabellen kommen also so an, wie sie sind. Beide Dokumente beschreiben die Entwickler-APIs; die Chat-Apps für Endnutzer veröffentlichen nicht dieselbe Detailtiefe.
Tokens: PDF vs. Markdown und vier weitere Formate
Um Zahlen zu Tokens bei PDF vs. Markdown zu bekommen, haben wir am 19. Okt. 2026 vier PDFs genommen und jede in sechs Textformate verwandelt: unsere saubere Markdown-Umwandlung, reinen Text aus pdftotext mit und ohne Layout, aus dem Markdown gerendertes HTML und JSON mit einem Objekt pro Block, formatiert und minifiziert. Die Tokens haben wir mit der Bibliothek tiktoken von OpenAI gezählt (Kodierung o200k_base). Den PDF-Weg selbst haben wir nicht gezählt, weil jeder Anbieter die Seitenbilder auf seine eigene Weise berechnet.
| Dokument | Markdown | Reiner Text | Text mit Layout | HTML | JSON | JSON, minifiziert |
|---|---|---|---|---|---|---|
| Englischer Leitfaden, 5 Seiten | 2.651 | 2.667 | 2.724 | 3.237 | 4.086 | 3.195 |
| Chinesischer Bericht, 11 Seiten | 8.697 | 8.713 | 8.804 | 9.796 | 11.063 | 9.402 |
| Englischer Bericht, 4 Seiten | 145 | 217 | 229 | 246 | 379 | 225 |
| Tabellen, 1 Seite | 106 | 99 | 102 | 211 | 265 | 154 |
| Alle vier | 11.599 | 11.696 | 11.859 | 13.490 | 15.793 | 12.976 |
| Im Verhältnis zu Markdown | 1,00× | 1,01× | 1,02× | 1,16× | 1,36× | 1,12× |
Die ehrliche Lesart: Markdown und reiner Text kosten fast gleich viel. Über alle vier Dateien war reiner Text 1 % größer, und bei der einseitigen Tabellendatei sogar etwas kleiner, weil senkrechte Striche Tokens kosten. Der große Abstand beim 4-seitigen Bericht kommt von der Bereinigung, nicht von der Syntax: Der reine Text behielt vier Kopien der laufenden Kopfzeile und vier Seitenzahlen. HTML kostete 16 % mehr als Markdown, formatiertes JSON 36 % mehr und minifiziertes JSON 12 % mehr.
Markdown ist also nicht das beste Dateiformat für ChatGPT, weil es winzig wäre, sondern weil die Struktur fast nichts kostet: Reiner Text verbraucht dieselben Tokens und wirft Überschriften und Tabellenspalten weg.
Warum ist Markdown für LLMs besser als JSON oder HTML?
Warum also ist Markdown für LLMs besser? Drei Gründe halten stand. Erstens ist die Struktur sichtbar: Eine ##-Zeile ist ein Abschnitt, eine |-Zeile eine Tabelle, und ein Modell hat von beidem riesige Mengen gesehen. Zweitens gibt es wenig Rauschen: keine schließenden Tags, keine Anführungszeichen um jeden Schlüssel, keine maskierten Zeichen. Drittens weisen die Leitfäden der Anbieter in dieselbe Richtung. Der GPT-4.1 Prompting Guide von OpenAI empfiehlt Markdown als Ausgangspunkt für die Struktur von Prompts, merkt an, dass JSON ausführlicher sein kann und Zeichen maskiert werden müssen, und berichtet, dass JSON in seinen Tests mit langem Kontext als Container für viele Dokumente schlecht abschnitt, XML dagegen gut.
Zu JSON vs. Markdown für LLMs also: Nimm JSON, wenn ein Programm das Ergebnis liest oder die Daten eine Liste von Datensätzen mit festen Feldern sind. Nimm Markdown für Dokumente, die ein Modell lesen und durchdenken soll. Gibst du mehrere Dokumente auf einmal hinein, verschafft dir ein einfaches Tag um jede Markdown-Datei, etwa <document title="…">, die Trennung, die XML bietet, ohne den Inhalt umzuwandeln.
So bereitest du ein Dokument für ChatGPT vor
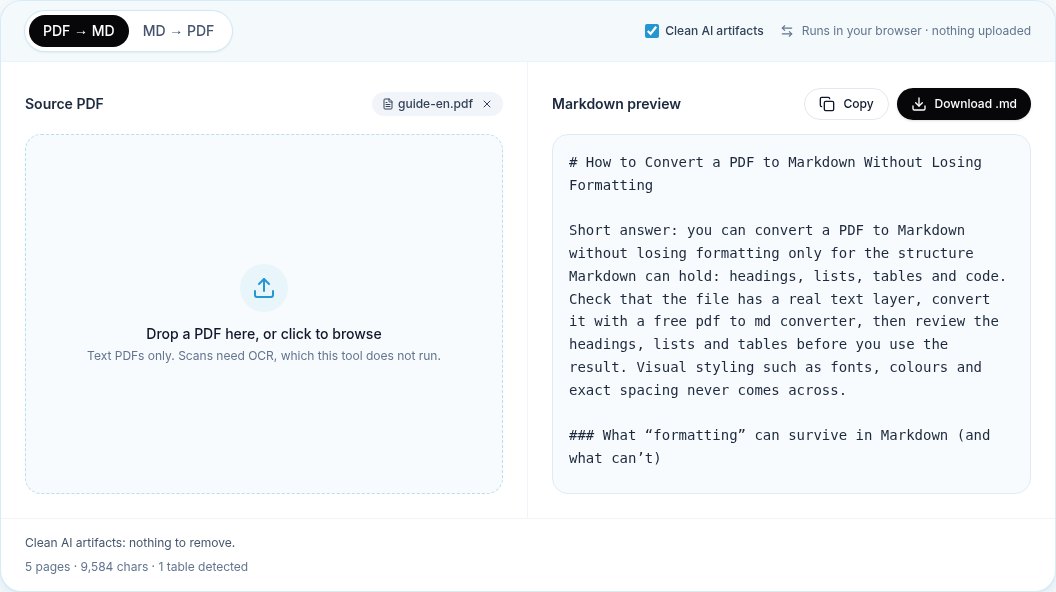
- Wandle eine PDF mit Textebene in Markdown um, mit eingeschalteter Bereinigung, damit laufende Kopfzeilen und Seitenzahlen verschwinden. Unser Konverter für PDF in Markdown macht das im Browser.
- Prüfe die Struktur: ein
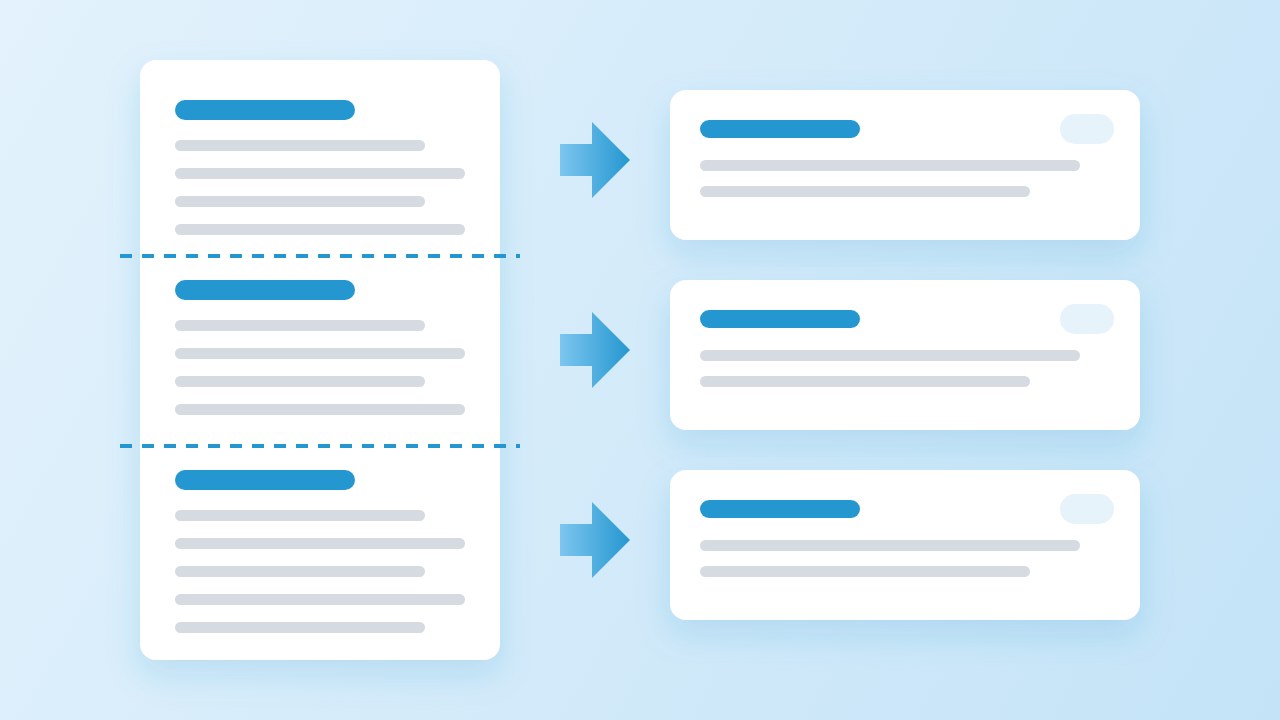
#-Titel,##für Abschnitte, Tabellen als Pipe-Tabellen. Korrigiere jede Überschrift, die als einfacher Text durchgekommen ist. - Teile lange Dateien an Überschriften, nicht nach einer festen Zeichenzahl, damit jeder Chunk mit seinem eigenen Titel beginnt. Das zählt vor allem bei Retrieval-Systemen.
- Erst das Dokument, zuletzt die Frage. Die Tipps für langen Kontext von Anthropic empfehlen diese Reihenfolge und berichten, dass sie die Antworten in ihren Tests um bis zu 30 Prozent verbessert hat.
- Halte die PDF bereit für Diagramme und Abbildungen und lade sie separat hoch, wenn es in einer Frage um ein Bild geht.
Für Pipelines statt einzelner Chats erledigt der Weg über Python dieselbe Umwandlung im Code, und unser Ratgeber zur lokalen Umwandlung zeigt, wie vertrauliche Dateien auf deinem eigenen Rechner bleiben, bis du sie bewusst verschickst.
Wann die PDF trotzdem die richtige Wahl ist
Markdown ist nicht in jedem Fall das Format, das ChatGPT am besten liest. Behalte das Original, wenn die Bedeutung im Bild steckt: Diagramme und Grafiken, gescannte Seiten (Markdown aus einem Scan ist leer, solange niemand OCR ausführt), Formulare, bei denen die Position zählt, und Folien, deren Layout die Botschaft ist. In diesen Fällen ist die PDF selbst das beste Dateiformat für ChatGPT: Die Seitenbilder, die der Anbieter hinzufügt, sind genau das, was du brauchst, und die zusätzlichen Tokens sind es wert.
Bei einem langen Bericht ist oft eine Mischung das beste Dateiformat für ChatGPT: Schick das Markdown für den Text und die zwei oder drei Seiten mit Diagrammen als separate PDF oder als Bilder. So hast du für die meisten Fragen die günstige, gegliederte Fassung und die visuelle, wenn es darauf ankommt. Benenne die beiden Dateien eindeutig, etwa bericht.md und bericht-diagramme.pdf, und sag im Prompt, welche die Abbildungen enthält, damit das Modell weiß, wo es nachsehen soll, bevor es antwortet.
Quellen
- File inputs (PDF files) — OpenAI API documentation
- GPT-4.1 Prompting Guide — OpenAI Cookbook, 2025
- PDF support — Anthropic, Claude documentation
- Long context prompting tips — Anthropic, Claude documentation
- tiktoken — OpenAI, GitHub
FAQ
Was ist das beste Dateiformat für ChatGPT?
Für Textdokumente Markdown: Es behält Überschriften, Listen und Tabellen und kostet etwa so viele Tokens wie reiner Text. Nimm die PDF für Diagramme und Scans, CSV für Daten und JSON für Datensätze, die ein Programm liest.
Ist PDF oder Markdown das beste Dateiformat für ChatGPT?
Füge Markdown ein oder lade es hoch, wenn der Inhalt Text ist. Eine PDF wird als ausgelesener Text plus Seitenbilder gelesen; das kostet mehr Tokens und lässt Kopf- und Fußzeilen und Seitenzahlen im Text stehen.
Braucht Markdown weniger Tokens als reiner Text?
Kaum. In unseren Tests lagen beide über vier Dateien innerhalb von etwa 1 %. Kleiner war Markdown nur dort, wo unser Konverter laufende Kopfzeilen und Seitenzahlen entfernt hat.
Ist JSON ein gutes Format für Dokumente?
Nicht zum Lesen. In unseren Tests kostete formatiertes JSON 36 % mehr Tokens als Markdown, und laut dem Leitfaden von OpenAI schnitt es bei Dokumenten mit langem Kontext schlecht ab. Nutze es für strukturierte Datensätze.
Kann ChatGPT gescannte PDFs lesen?
Modelle, die Seitenbilder sehen, können manche gescannten Seiten lesen. Eine Markdown-Umwandlung eines Scans ist ohne OCR leer; schick bei Scans also die PDF oder lass zuerst OCR laufen.
Sollte ich ein langes Dokument vor dem Senden teilen?
Für einen Chat reicht meist eine einzige gut gegliederte Datei. Für Retrieval oder wenn du an Kontextgrenzen stößt, teile an Überschriften, damit jeder Teil seinen Titel behält.

