ChatGPTに最適なファイル形式を、実際のファイルで検証
執筆 pdftomd.tools チーム · 更新日 · 約8分で読めます
テキストの文書なら、ChatGPTに最適なファイル形式はきれいなMarkdownです。見出し・リスト・表がシンプルな記号として残り、トークンはプレーンテキストとほぼ同じです。図やページのレイアウトが重要ならPDFのままにしましょう。Markdownにするには、LLM向けのPDF Markdown変換のツールにファイルを通し、見出しを確認します。
短い答え:ChatGPTに最適なファイル形式は?
ChatGPTに最適なファイル形式は、文書の種類によって変わります。簡単にまとめると次の通りです。
| 内容 | モデルに渡すもの | 理由 |
|---|---|---|
| レポート、マニュアル、契約書、ノート | Markdown | 構造(見出し、リスト、表)をシンプルな記号で表せる |
| 構造のない本文 | プレーンテキスト | コストはMarkdownと同じで、失うものがない |
| 図、スキャン、フォーム、スライド | PDFそのもの | モデルにページの画像が必要 |
| データの行 | CSVかスプレッドシート | 1行に1レコードで、数えたり絞り込んだりしやすい |
| プログラム向けのレコード | JSON | 正確な項目と型。ただしトークンのコストは高め |
このガイドの残りでは理由を説明します。PDFをアップロードしたときにモデルが実際に受け取るもの、同じ文書のトークンを6つの形式で数えて測った結果、そして回答が正しいセクションにもとづくようにファイルを準備する方法です。
PDFをアップロードすると何が起きるか
ChatGPTに最適なファイル形式を選ぶには、まずPDFがどうなるかを見ましょう。PDFはページの記述であって、テキストファイルではありません。読むためには、モデルの提供元がテキストを取り出す必要があり、大手の提供元はさらにページを画像としても描画します。OpenAIのファイル入力のガイドによると、画像を理解できるモデルでは、APIはPDFからテキストと各ページの画像の両方を抽出してモデルに送り、他のテキストファイルはテキストとしてだけ入力されます。Anthropic も Claude について同じ方法を説明しています。
“システムは文書の各ページを画像に変換します。各ページのテキストが抽出され、そのページの画像と一緒に提供されます。”
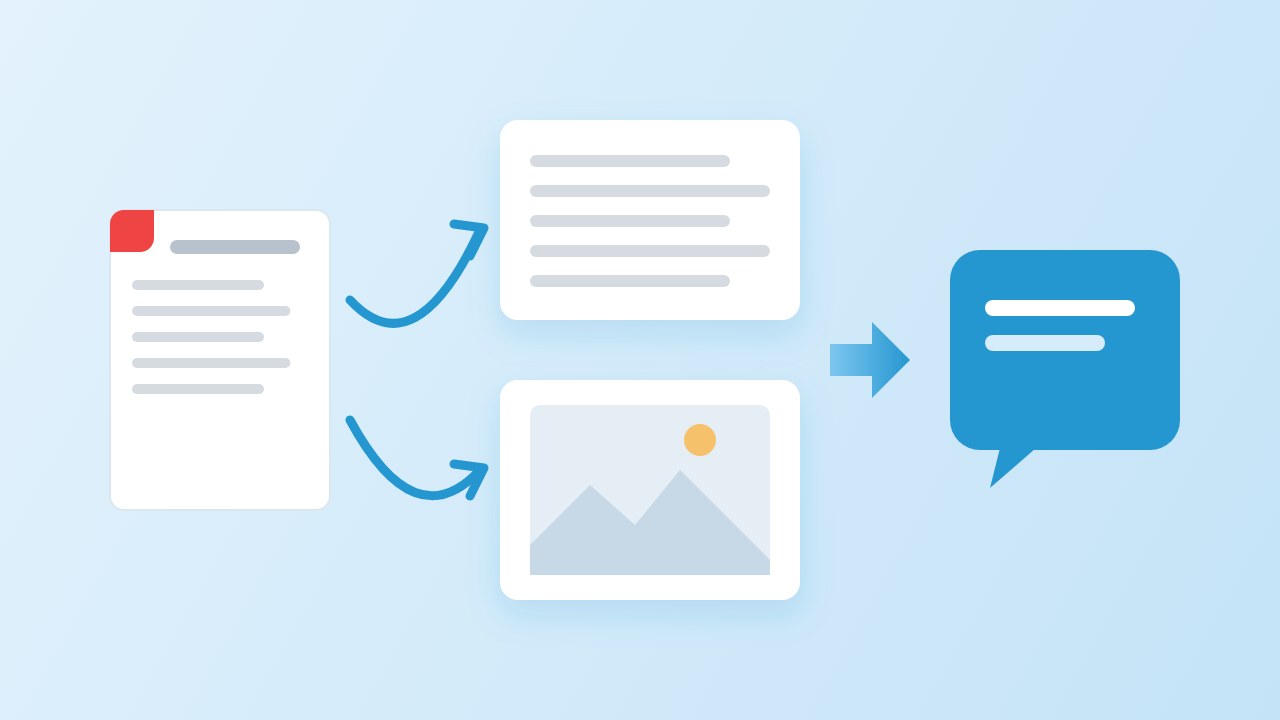
これがAI向けにMarkdownとPDFを比べるときの核心です。ページに図やスキャンした署名があるなら画像は役立ちますが、その分のコストがかかります。Anthropic はテキストだけで1ページあたり1,500〜3,000トークン(画像は含まない)と見積もっており、OpenAI もPDFの入力はトークンの使用量を増やしうると注意しています。また、抽出されたテキストの質はPDFのテキスト層次第なので、繰り返しのヘッダー、ページ番号、崩れた表はそのまま届きます。どちらのドキュメントも開発者向けAPIについての説明で、一般向けのチャットアプリは同じ詳しさでは公開していません。
トークン:PDFとMarkdown、ほか4つの形式
PDFとMarkdownのトークン数を比べるため、2026年10月19日に4つのPDFを用意し、それぞれを6つのテキスト形式にしました。私たちのきれいなMarkdown変換、pdftotext によるレイアウトあり・なしのプレーンテキスト、Markdownから描画したHTML、ブロックごとに1オブジェクトのJSON(整形と圧縮)です。トークンは OpenAI の tiktoken ライブラリ(エンコーディング o200k_base)で数えました。ページの画像の計算方法は提供元ごとに違うため、PDFの経路そのものは数えていません。
| 文書 | Markdown | プレーンテキスト | レイアウト付きテキスト | HTML | JSON | JSON(圧縮) |
|---|---|---|---|---|---|---|
| 英語のガイド、5ページ | 2,651 | 2,667 | 2,724 | 3,237 | 4,086 | 3,195 |
| 中国語のレポート、11ページ | 8,697 | 8,713 | 8,804 | 9,796 | 11,063 | 9,402 |
| 英語のレポート、4ページ | 145 | 217 | 229 | 246 | 379 | 225 |
| 表、1ページ | 106 | 99 | 102 | 211 | 265 | 154 |
| 4つの合計 | 11,599 | 11,696 | 11,859 | 13,490 | 15,793 | 12,976 |
| Markdownとの比 | 1.00× | 1.01× | 1.02× | 1.16× | 1.36× | 1.12× |
正直に読むとこうなります。Markdownとプレーンテキストのコストはほぼ同じです。4つのファイル全体ではプレーンテキストが1%大きく、1ページの表のファイルでは縦棒がトークンを使うため、むしろ少し小さくなりました。4ページのレポートでの大きな差は、記法ではなくクリーンアップによるものです。プレーンテキストには繰り返しヘッダーのコピー4つとページ番号4つが残っていました。HTMLはMarkdownより16%、整形したJSONは36%、圧縮したJSONは12%多くかかりました。
つまり、MarkdownがChatGPTに最適なファイル形式なのは、それが小さいからではなく、構造がほとんどタダだからです。プレーンテキストは同じトークンを使いながら、見出しと表の列を捨ててしまいます。
なぜLLMにはJSONやHTMLよりMarkdownが良いのか
では、なぜLLMにはMarkdownが良いのでしょうか。確かな理由が3つあります。1つ目は、構造が目に見えることです。## の行はセクション、| の行は表で、モデルはどちらも膨大な量を見てきています。2つ目は、ノイズが少ないことです。閉じタグも、すべてのキーを囲む引用符も、エスケープされた文字もありません。3つ目は、提供元のガイドが同じ方向を指していることです。OpenAIのGPT-4.1 Prompting Guideは、プロンプトの構造の出発点としてMarkdownを勧め、JSONは冗長になりがちで文字のエスケープが必要だと指摘し、長いコンテキストでのテストでは、多数の文書を入れる容器としてJSONの成績が悪く、XMLは良かったと報告しています。
LLM向けのJSONとMarkdownの比較では、こう考えましょう。プログラムが結果を読む場合や、データが決まった項目を持つレコードの一覧である場合はJSON。モデルに読ませて考えさせる文書にはMarkdown。複数の文書を一度に入れるなら、各Markdownファイルを <document title="…"> のようなシンプルなタグで囲めば、内容を変換しなくてもXMLのような区切りが得られます。
ChatGPTのために文書を準備する方法
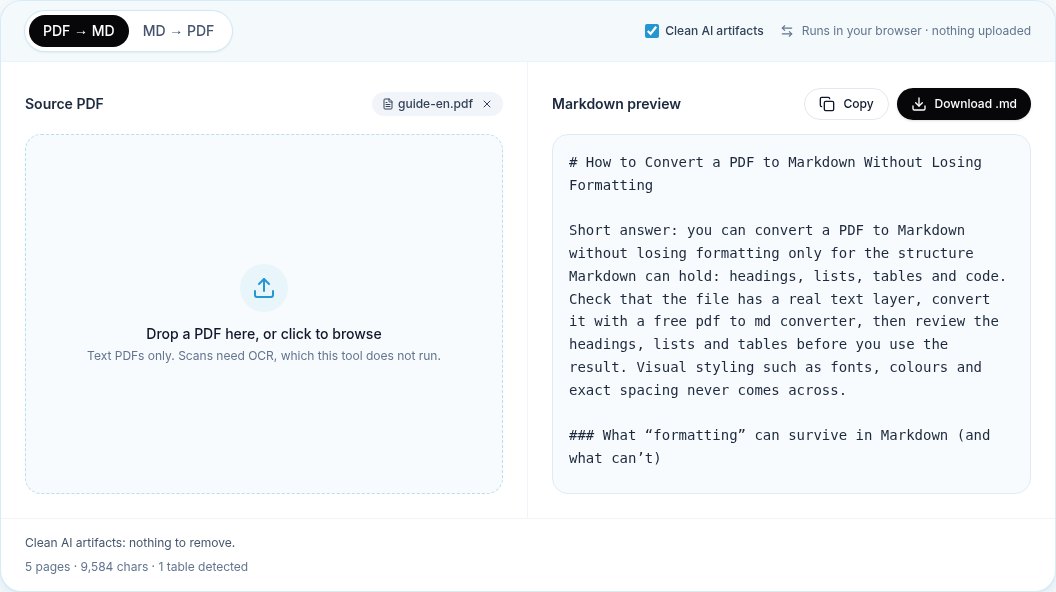
- テキスト層のあるPDFをMarkdownに変換し、クリーンアップを有効にして繰り返しのヘッダーとページ番号を消します。私たちのPDFをMarkdownに変換するツールなら、ブラウザでこれができます。
- 構造を確認する:
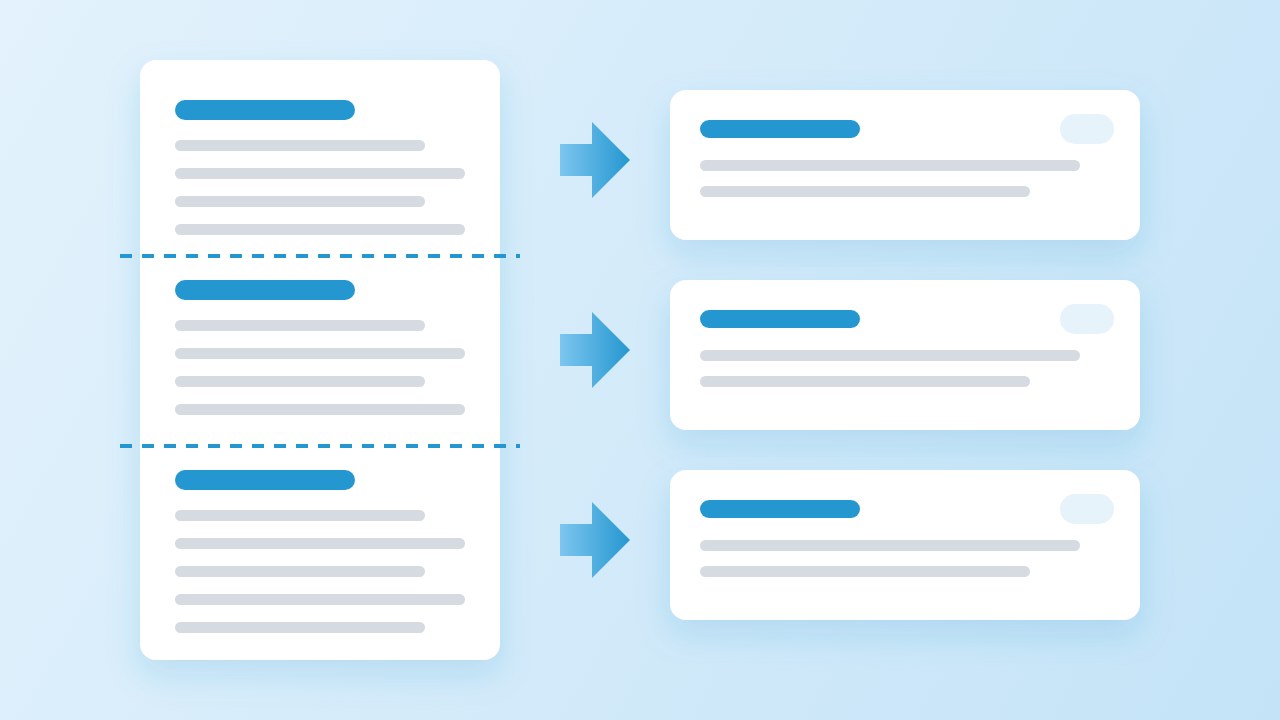
#のタイトル、セクションには##、表はパイプテーブル。プレーンテキストになってしまった見出しは直します。 - 長いファイルは見出しで分ける。 決まった文字数で分けず、各チャンクが自分のタイトルで始まるようにします。検索システムでは特に重要です。
- 文書を先に、質問は最後に。 Anthropic の長いコンテキストのコツはこの順番を勧めており、テストで回答が最大30パーセント改善したと報告しています。
- PDFは手元に残す。 図やイラストのためです。画像についての質問なら、別にアップロードします。
単発のチャットではなくパイプラインなら、Pythonでの方法が同じ変換をコードで行います。ローカルで変換するガイドでは、社外秘のファイルを、意図して送るまで自分のパソコンに留めておく方法を紹介しています。
それでもPDFが正解のとき
Markdownがいつでも、ChatGPTが最もよく読める形式というわけではありません。意味が見た目にあるなら元のファイルを残しましょう。図やグラフ、スキャンしたページ(誰かがOCRをかけない限り、スキャンから作ったMarkdownは空です)、位置が重要なフォーム、レイアウトそのものがメッセージのスライドなどです。こうした場合はPDFそのものがChatGPTに最適なファイル形式です。提供元が加えるページの画像こそが必要なもので、追加のトークンをかける価値があります。
長いレポートなら、組み合わせがChatGPTに最適なファイル形式になることがよくあります。テキストにはMarkdownを、図のある2、3ページは別のPDFか画像として送ります。そうすれば、ほとんどの質問には安くて構造化された版を、必要なときには見た目の版を使えます。report.md と report-figures.pdf のように2つのファイルにわかりやすい名前を付け、プロンプトでどちらに図が入っているかを伝えれば、モデルは答える前にどこを見ればよいかわかります。
出典
- File inputs (PDF files) — OpenAI API documentation
- GPT-4.1 Prompting Guide — OpenAI Cookbook, 2025
- PDF support — Anthropic, Claude documentation
- Long context prompting tips — Anthropic, Claude documentation
- tiktoken — OpenAI, GitHub
よくある質問
ChatGPTに最適なファイル形式は何ですか?
テキストの文書ならMarkdownです。見出し・リスト・表が残り、トークンはプレーンテキストとほぼ同じです。図やスキャンにはPDF、データにはCSV、プログラムが読むレコードにはJSONを使いましょう。
ChatGPTにはPDFとMarkdownのどちらが良いですか?
内容がテキストなら、Markdownを貼り付けるかアップロードしてください。PDFは抽出されたテキストとページの画像として読まれるので、トークンが増え、ヘッダー・フッターやページ番号もテキストに残ります。
Markdownはプレーンテキストよりトークンが少ないですか?
ほとんど変わりません。私たちのテストでは、4つのファイル全体で両者の差は約1%以内でした。Markdownが小さくなったのは、私たちの変換ツールが繰り返しのヘッダーとページ番号を取り除いた場合だけです。
JSONは文書に向いた形式ですか?
読ませる目的には向いていません。私たちのテストでは、整形したJSONはMarkdownより36%多くのトークンがかかり、OpenAIのガイドによると長いコンテキストの文書では成績が悪くなりました。構造化されたレコードに使いましょう。
ChatGPTはスキャンしたPDFを読めますか?
ページの画像を見られるモデルなら、スキャンしたページの一部を読めます。スキャンをMarkdownに変換してもOCRなしでは空になるので、スキャンはPDFのまま送るか、先にOCRをかけてください。
長い文書は送る前に分けるべきですか?
1回のチャットなら、よく構造化された1つのファイルで十分なことがほとんどです。検索に使う場合やコンテキストの上限に当たる場合は、見出しで分けて、各部分がタイトルを保つようにしましょう。

