Le meilleur format de fichier pour ChatGPT, testé sur de vrais fichiers
Par Équipe pdftomd.tools · Mis à jour le · 8 min de lecture
Pour des documents texte, un Markdown propre est le meilleur format de fichier pour ChatGPT : titres, listes et tableaux restent en caractères simples, et il coûte à peu près autant de tokens que du texte brut. Gardez le PDF quand les graphiques ou la mise en page comptent. Pour obtenir le Markdown, passez le fichier dans un convertisseur PDF en Markdown pour LLM et vérifiez les titres.
Réponse courte : quel est le meilleur format de fichier pour ChatGPT ?
Le meilleur format de fichier pour ChatGPT dépend de la nature du document. En bref :
| Votre contenu | À donner au modèle | Pourquoi |
|---|---|---|
| Rapports, manuels, contrats, notes | Markdown | La structure (titres, listes, tableaux) en caractères simples |
| Texte suivi sans structure | Texte brut | Même coût que Markdown, rien à perdre |
| Graphiques, scans, formulaires, diapositives | Le PDF lui-même | Le modèle a besoin des images des pages |
| Lignes de données | CSV ou un tableur | Un enregistrement par ligne, facile à compter et à filtrer |
| Enregistrements pour un programme | JSON | Champs et types exacts, pour un coût en tokens plus élevé |
La suite de ce guide explique pourquoi : ce que le modèle reçoit réellement quand vous envoyez un PDF, ce que nous avons mesuré en comptant les tokens des mêmes documents dans six formats, et comment préparer un fichier pour que la réponse s'appuie sur la bonne section.
Ce qui se passe quand vous envoyez un PDF
Pour choisir le meilleur format de fichier pour ChatGPT, regardez d'abord ce que devient un PDF. Un PDF est une description de pages, pas un fichier texte. Pour le lire, le fournisseur du modèle doit en extraire le texte, et les grands fournisseurs rendent aussi les pages en images. D'après le guide sur les fichiers en entrée d'OpenAI, pour un PDF envoyé à un modèle capable de voir les images, la plateforme extrait à la fois le texte et une image de chaque page et transmet les deux au modèle ; les autres fichiers texte n'entrent que sous forme de texte. Anthropic décrit la même approche pour Claude :
“Le système convertit chaque page du document en image. Le texte de chaque page est extrait et fourni avec l'image de la page.”
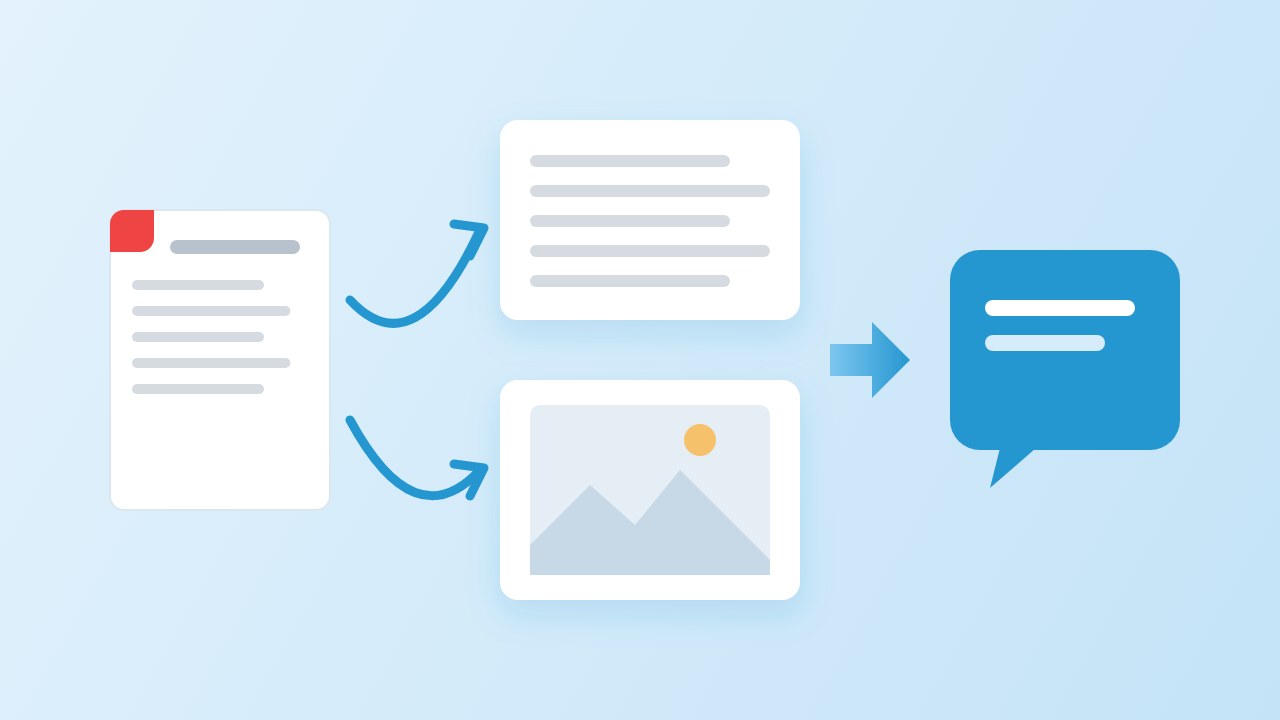
C'est tout l'enjeu de Markdown ou PDF pour l'IA. Les images aident quand la page contient un graphique ou une signature scannée, et elles coûtent en plus : Anthropic estime 1 500 à 3 000 tokens par page pour le seul texte, images non comprises, et OpenAI signale que les PDF en entrée peuvent augmenter la consommation de tokens. Le texte extrait ne vaut par ailleurs que ce que vaut la couche de texte du PDF : en-têtes répétés, numéros de page et tableaux cassés arrivent tels quels. Ces deux documents décrivent les plateformes pour développeurs ; les applications de chat grand public ne publient pas le même niveau de détail.
Tokens : PDF vs Markdown et quatre autres formats
Pour avoir des chiffres sur les tokens d'un PDF par rapport au Markdown, nous avons pris quatre PDF le 19 oct. 2026 et transformé chacun en six formats texte : notre conversion Markdown propre, du texte brut issu de pdftotext avec et sans mise en page, du HTML rendu à partir du Markdown, et du JSON avec un objet par bloc, indenté et minifié. Nous avons compté les tokens avec la bibliothèque tiktoken d'OpenAI (encodage o200k_base). Nous n'avons pas compté la voie PDF elle-même, car chaque fournisseur facture les images de pages à sa manière.
| Document | Markdown | Texte brut | Texte avec mise en page | HTML | JSON | JSON minifié |
|---|---|---|---|---|---|---|
| Guide en anglais, 5 pages | 2 651 | 2 667 | 2 724 | 3 237 | 4 086 | 3 195 |
| Rapport en chinois, 11 pages | 8 697 | 8 713 | 8 804 | 9 796 | 11 063 | 9 402 |
| Rapport en anglais, 4 pages | 145 | 217 | 229 | 246 | 379 | 225 |
| Tableaux, 1 page | 106 | 99 | 102 | 211 | 265 | 154 |
| Les quatre | 11 599 | 11 696 | 11 859 | 13 490 | 15 793 | 12 976 |
| Par rapport à Markdown | 1,00× | 1,01× | 1,02× | 1,16× | 1,36× | 1,12× |
La lecture honnête : Markdown et texte brut coûtent presque pareil. Sur les quatre fichiers, le texte brut était 1 % plus gros, et même un peu plus petit pour le fichier de tableaux d'une page, parce que les barres verticales coûtent des tokens. Le grand écart sur le rapport de 4 pages vient du nettoyage, pas de la syntaxe : le texte brut gardait quatre copies de l'en-tête répété et quatre numéros de page. Le HTML coûtait 16 % de plus que Markdown, le JSON indenté 36 % de plus et le JSON minifié 12 % de plus.
Markdown n'est donc pas le meilleur format de fichier pour ChatGPT parce qu'il serait minuscule, mais parce que sa structure ne coûte presque rien : le texte brut consomme les mêmes tokens et jette les titres et les colonnes de tableau.
Pourquoi Markdown convient mieux aux LLM que JSON ou HTML
Alors, pourquoi Markdown convient-il mieux aux LLM ? Trois raisons tiennent la route. D'abord, la structure est visible : une ligne ## est une section, une ligne | un tableau, et un modèle en a vu des quantités énormes. Ensuite, il y a peu de bruit : pas de balises fermantes, pas de guillemets autour de chaque clé, pas de caractères échappés. Enfin, les guides des fournisseurs vont dans le même sens. Le GPT-4.1 Prompting Guide d'OpenAI recommande Markdown comme point de départ pour structurer les prompts, note que JSON peut être plus verbeux et oblige à échapper des caractères, et rapporte que dans ses tests en contexte long, JSON s'en sortait mal comme conteneur pour de nombreux documents, alors que XML s'en sortait bien.
Pour JSON ou Markdown avec un LLM, donc : prenez JSON quand un programme lit le résultat ou quand les données sont une liste d'enregistrements à champs fixes. Prenez Markdown pour les documents qu'un modèle doit lire et sur lesquels il doit raisonner. Si vous envoyez plusieurs documents d'un coup, une simple balise autour de chaque fichier Markdown, par exemple <document title="…">, vous donne la séparation qu'offre XML sans convertir le contenu.
Comment préparer un document pour ChatGPT
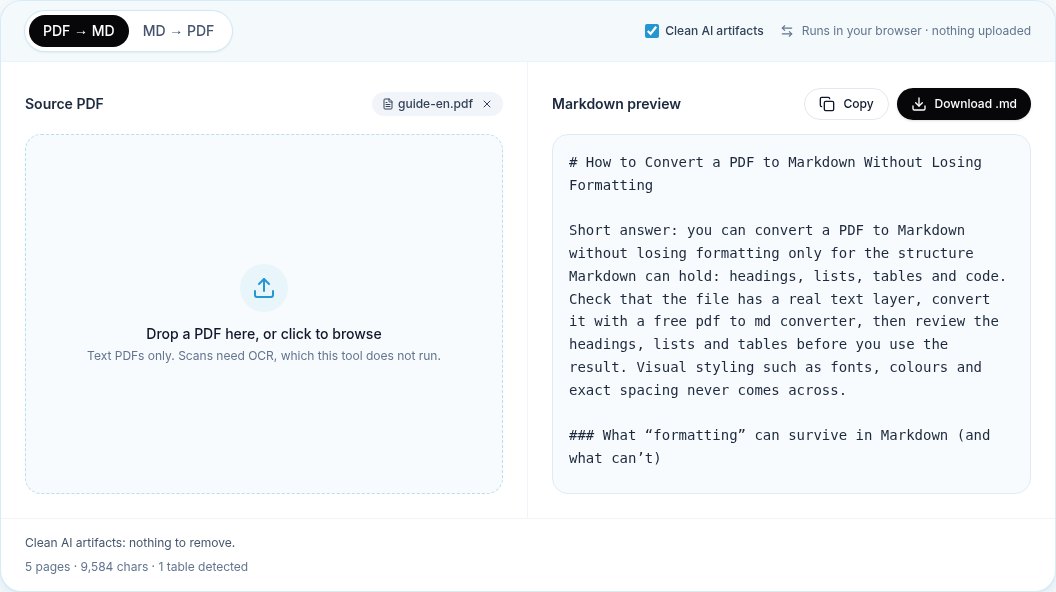
- Convertissez un PDF avec couche de texte en Markdown, nettoyage activé, pour que les en-têtes répétés et les numéros de page disparaissent. Notre convertisseur PDF en Markdown le fait dans le navigateur.
- Vérifiez la structure : un titre
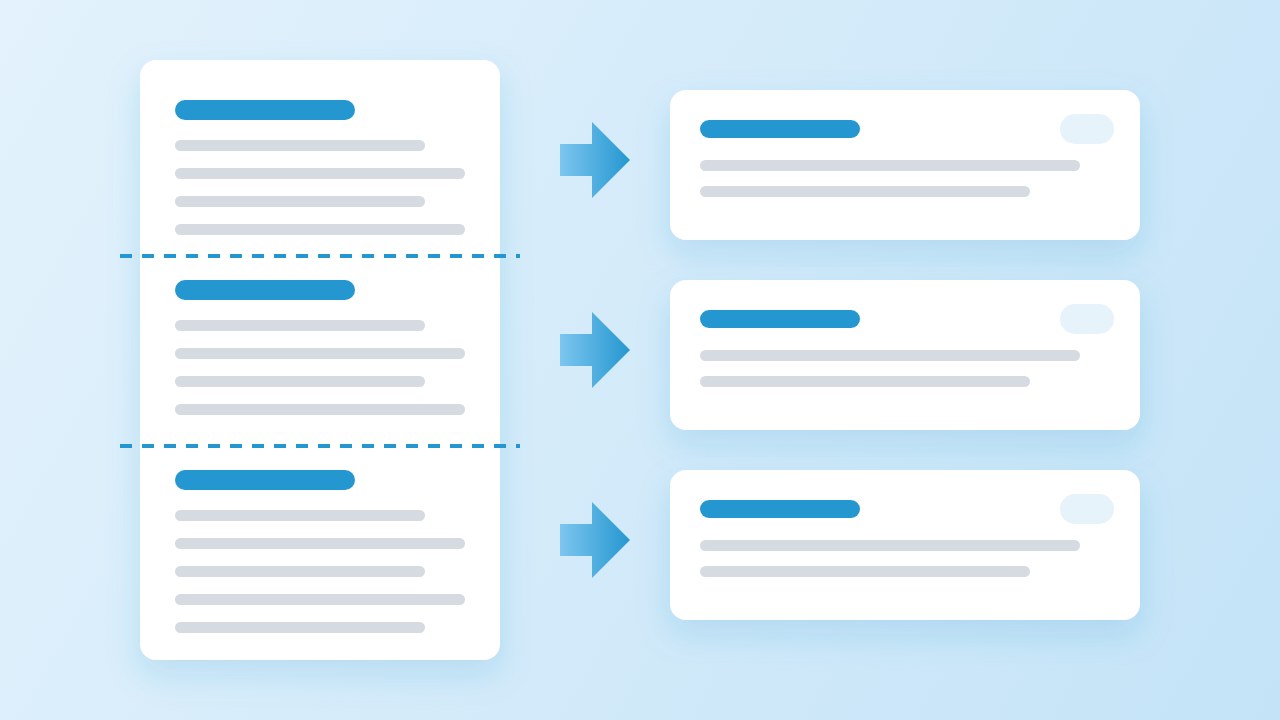
#, des##pour les sections, les tableaux en tableaux à barres verticales. Corrigez tout titre arrivé en texte simple. - Découpez les longs fichiers aux titres, pas selon un nombre fixe de caractères, pour que chaque morceau commence par son propre titre. Cela compte surtout pour les systèmes de recherche documentaire (RAG).
- Le document d'abord, la question à la fin. Les conseils pour les contextes longs d'Anthropic recommandent cet ordre et indiquent qu'il a amélioré les réponses jusqu'à 30 % dans leurs tests.
- Gardez le PDF sous la main pour les graphiques et figures, et envoyez-le à part quand une question porte sur une image.
Pour des chaînes de traitement plutôt que des conversations isolées, la voie Python fait la même conversion en code, et notre guide de conversion en local montre comment garder les fichiers confidentiels sur votre propre machine jusqu'à ce que vous choisissiez de les envoyer.
Quand le PDF reste le bon choix
Markdown n'est pas dans tous les cas le format que ChatGPT lit le mieux. Gardez l'original quand le sens est dans l'image : graphiques et diagrammes, pages scannées (le Markdown d'un scan est vide tant que personne ne lance d'OCR), formulaires où la position compte, et diapositives dont la mise en page est le message. Dans ces cas, le PDF lui-même est le meilleur format de fichier pour ChatGPT : les images de pages ajoutées par le fournisseur sont exactement ce qu'il vous faut, et les tokens en plus en valent la peine.
Pour un long rapport, le meilleur format de fichier pour ChatGPT est souvent un mélange : envoyez le Markdown pour le texte, et les deux ou trois pages de graphiques dans un PDF à part ou en images. Vous avez ainsi la version structurée et économique pour la plupart des questions, et la version visuelle quand elle compte. Donnez aux deux fichiers des noms clairs, par exemple rapport.md et rapport-graphiques.pdf, et indiquez dans le prompt lequel contient les figures, pour que le modèle sache où regarder avant de répondre.
Sources
- File inputs (PDF files) — OpenAI API documentation
- GPT-4.1 Prompting Guide — OpenAI Cookbook, 2025
- PDF support — Anthropic, Claude documentation
- Long context prompting tips — Anthropic, Claude documentation
- tiktoken — OpenAI, GitHub
FAQ
Quel est le meilleur format de fichier pour ChatGPT ?
Pour des documents texte, Markdown : il garde titres, listes et tableaux et coûte à peu près autant de tokens que du texte brut. Prenez le PDF pour les graphiques et les scans, le CSV pour les données et le JSON pour des enregistrements lus par un programme.
PDF ou Markdown : lequel est le meilleur format de fichier pour ChatGPT ?
Collez ou envoyez du Markdown quand le contenu est du texte. Un PDF est lu comme texte extrait plus images des pages ; cela coûte plus de tokens et laisse en-têtes, pieds de page et numéros de page dans le texte.
Markdown utilise-t-il moins de tokens que le texte brut ?
À peine. Dans nos tests, les deux restaient à environ 1 % l'un de l'autre sur quatre fichiers. Markdown n'était plus petit que là où notre convertisseur avait retiré les en-têtes répétés et les numéros de page.
JSON est-il un bon format pour des documents ?
Pas pour la lecture. Dans nos tests, le JSON indenté coûtait 36 % de tokens de plus que Markdown, et d'après le guide d'OpenAI, il s'en sortait mal avec des documents en contexte long. Utilisez-le pour des enregistrements structurés.
ChatGPT peut-il lire des PDF scannés ?
Les modèles qui voient les images des pages peuvent lire certaines pages scannées. Une conversion Markdown d'un scan est vide sans OCR : pour les scans, envoyez donc le PDF ou passez d'abord un OCR.
Faut-il découper un long document avant de l'envoyer ?
Pour une conversation, un seul fichier bien structuré suffit en général. Pour la recherche documentaire ou si vous atteignez les limites de contexte, découpez aux titres pour que chaque partie garde son titre.

