ChatGPT最适合的文件格式:用真实文件测出来的答案
作者 pdftomd.tools 团队 · 更新于 · 阅读约 6 分钟
对文字类文档来说,干净的 Markdown 就是 ChatGPT最适合的文件格式:标题、列表和表格都以简单字符保留下来,token 消耗和纯文本差不多。如果图表或页面版式很重要,就保留 PDF。要得到 Markdown,用 大模型PDF转Markdown 工具转一下,再检查标题即可。
简短回答:ChatGPT最适合的文件格式是什么?
该用哪种格式,要看文档是什么内容。简单总结如下:
| 你的内容 | 交给模型的格式 | 原因 |
|---|---|---|
| 报告、手册、合同、笔记 | Markdown | 用简单字符表达结构(标题、列表、表格) |
| 没有结构的连续文字 | 纯文本 | 成本和 Markdown 一样,没什么可损失的 |
| 图表、扫描件、表单、幻灯片 | PDF 原文件 | 模型需要看到页面图像 |
| 数据行 | CSV 或电子表格 | 一行一条记录,便于统计和筛选 |
| 给程序用的记录 | JSON | 字段和类型精确,但 token 成本更高 |
本文剩下的部分解释原因:上传 PDF 时模型实际收到的是什么;我们把同样的文档转成六种格式、统计 token 的结果;以及怎样准备文件,让回答依据的是正确的章节。
上传 PDF 时发生了什么
要选出 ChatGPT最适合的文件格式,先看看 PDF 会变成什么。PDF 是对页面的描述,不是文本文件。要读懂它,模型提供方必须先把文字提取出来,大厂还会把每一页渲染成图片。根据 OpenAI 的 文件输入指南,把 PDF 发给能看图的模型时,平台会同时提取文字和每一页的图像,一起交给模型;其他文本文件只以文字形式输入。Anthropic 对 Claude 的说明也是同样的做法:
“系统会把文档的每一页转换成图像。每页的文字会被提取出来,并与该页的图像一起提供。”
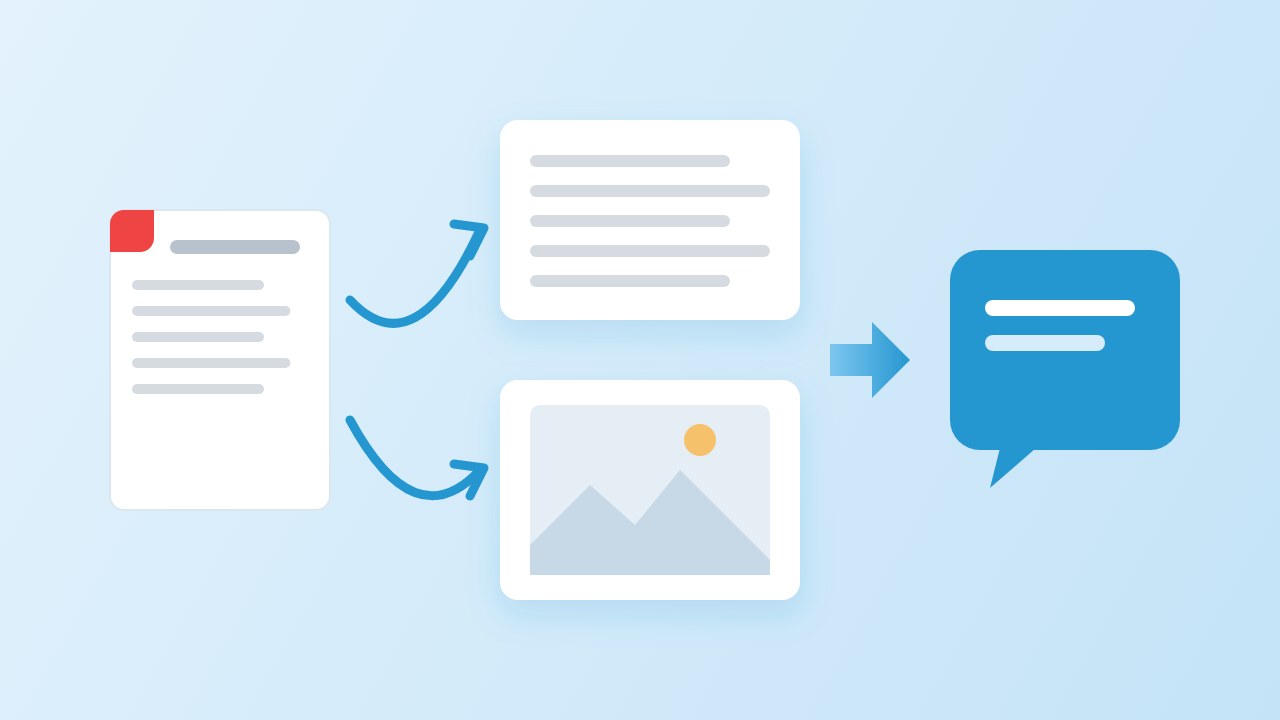
这就是 AI 用 Markdown 还是 PDF 的关键。页面上有图表或扫描签名时,图像很有用,但要额外付出成本:Anthropic 估计仅文字部分每页就要 1,500 到 3,000 个 token,还不算图像;OpenAI 也提醒,PDF 输入可能增加 token 用量。另外,提取的文字质量取决于 PDF 的文字层,重复的页眉、页码和断裂的表格都会原样进来。这两份文档讲的都是开发者平台;面向普通用户的聊天应用没有公布同样详细的信息。
Token:PDF 对比 Markdown,以及另外四种格式
为了拿到 PDF 和 Markdown 的 token 对比数据,我们在 2026年10月19日 选了四个 PDF,把每个都转成六种文本格式:我们的干净 Markdown 转换结果、pdftotext 输出的纯文本(保留版式和不保留版式各一份)、由 Markdown 渲染的 HTML,以及每个块一个对象的 JSON(缩进版和压缩版)。token 用 OpenAI 的 tiktoken 库统计(编码 o200k_base)。PDF 这条路本身我们没有统计,因为每家提供方计算页面图像的方式都不一样。
| 文档 | Markdown | 纯文本 | 保留版式的文本 | HTML | JSON | JSON(压缩) |
|---|---|---|---|---|---|---|
| 英文指南,5 页 | 2,651 | 2,667 | 2,724 | 3,237 | 4,086 | 3,195 |
| 中文报告,11 页 | 8,697 | 8,713 | 8,804 | 9,796 | 11,063 | 9,402 |
| 英文报告,4 页 | 145 | 217 | 229 | 246 | 379 | 225 |
| 表格,1 页 | 106 | 99 | 102 | 211 | 265 | 154 |
| 四个合计 | 11,599 | 11,696 | 11,859 | 13,490 | 15,793 | 12,976 |
| 相对 Markdown | 1.00× | 1.01× | 1.02× | 1.16× | 1.36× | 1.12× |
实话实说:Markdown 和纯文本的成本几乎一样。四个文件合计,纯文本大了 1%;在那份一页的表格文件里,纯文本甚至还小一点,因为竖线也要占 token。4 页报告差距大,是清理的功劳,不是语法的原因:纯文本里留着四份重复页眉和四个页码。HTML 比 Markdown 多 16%,缩进的 JSON 多 36%,压缩的 JSON 多 12%。
所以,Markdown 成为 ChatGPT最适合的文件格式,不是因为它体积小,而是因为结构几乎不花钱:纯文本花同样多的 token,却把标题和表格的列都丢掉了。
为什么大模型用 Markdown 比 JSON 或 HTML 更好?
那么,为什么大模型更适合 Markdown?有三个站得住的理由。第一,结构一目了然:## 开头的一行是章节,| 开头的一行是表格,模型见过的这两种内容多到数不清。第二,噪音少:没有闭合标签,不用给每个键加引号,也没有转义字符。第三,各家的指南指向同一个方向。OpenAI 的 GPT-4.1 Prompting Guide 建议用 Markdown 作为组织提示词结构的起点,指出 JSON 可能更啰嗦、需要转义字符,并提到在长上下文测试中,用 JSON 装多篇文档效果很差,而 XML 表现很好。
所以 JSON 还是 Markdown 的问题可以这样回答:结果要给程序读,或者数据是一组字段固定的记录,就用 JSON;文档要让模型阅读和推理,就用 Markdown。一次放进多篇文档时,给每个 Markdown 文件套一个简单标签,比如 <document title="…">,就能得到 XML 那样的分隔效果,又不用转换内容。
怎样为 ChatGPT 准备文档
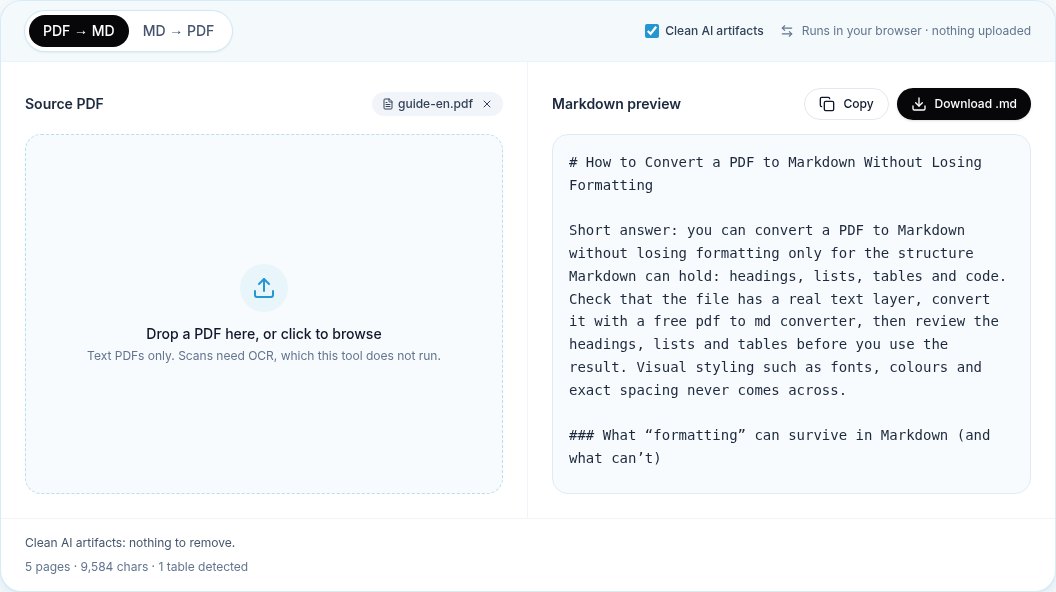
- 把带文字层的 PDF 转成 Markdown,并打开清理,去掉重复的页眉和页码。我们的 PDF转Markdown 工具在浏览器里就能完成。
- 检查结构:一个
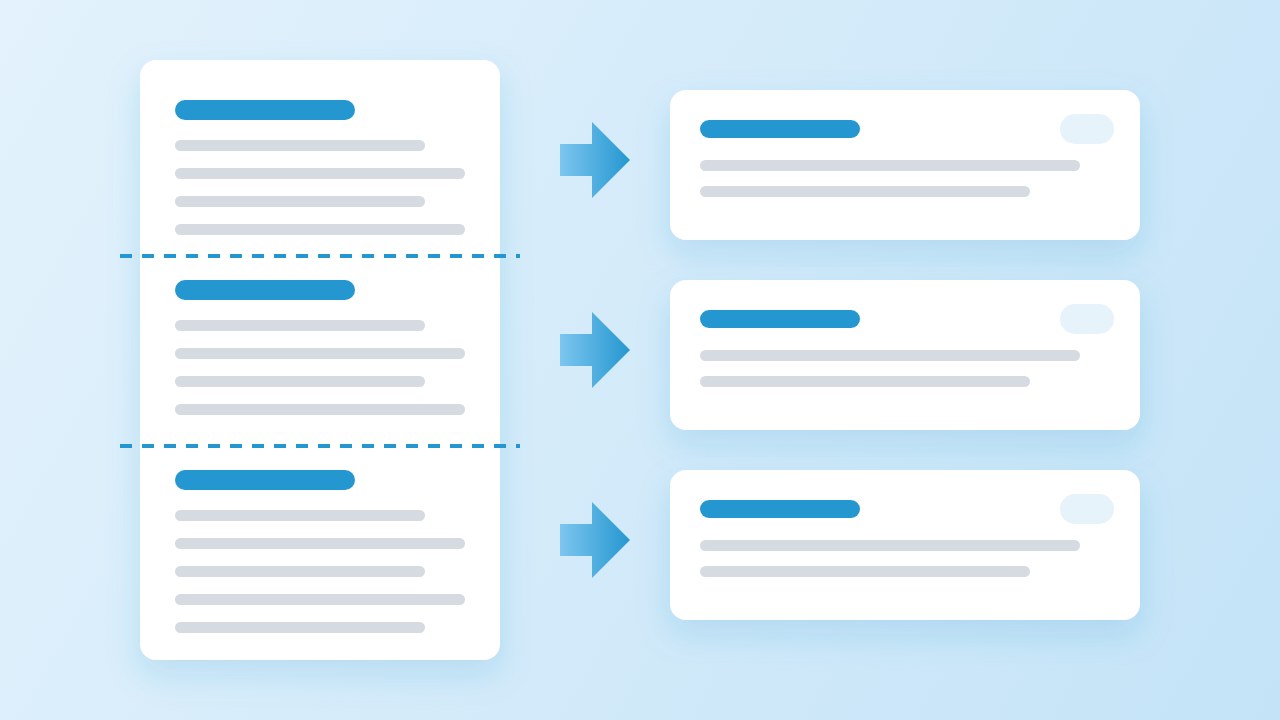
#标题,章节用##,表格用竖线表格。以普通文字出现的标题要改过来。 - 长文件按标题切分,不要按固定字数切,让每一块都以自己的标题开头。这对检索增强(RAG)系统尤其重要。
- 先放文档,最后提问题。Anthropic 的 长上下文技巧 推荐这个顺序,并表示在他们的测试中回答质量最多提升了 30%。
- 把 PDF 留在手边,遇到图表和插图的问题时,单独上传。
如果是自动化流程而不是单次聊天,Python 方案 可以用代码完成同样的转换;我们的 本地转换指南 则介绍了怎样让机密文件一直留在自己的电脑上,直到你决定发送。
什么时候还是该用 PDF
Markdown 并不是在所有情况下都是 ChatGPT 读得最好的格式。如果意义藏在画面里,就用原文件:图表和示意图、扫描页面(没人跑 OCR 的话,扫描件转出的 Markdown 是空的)、位置很关键的表单,以及版式本身就是信息的幻灯片。这些情况下,PDF 本身就是 ChatGPT最适合的文件格式:提供方附加的页面图像正是你需要的,多花的 token 也值得。
对于一份很长的报告,ChatGPT最适合的文件格式往往是组合使用:正文发 Markdown,有图表的那两三页单独做成 PDF 或图片发过去。这样大多数问题用便宜、结构清楚的版本,需要看图时再用视觉版本。给两个文件起清楚的名字,比如 report.md 和 report-charts.pdf,并在提示词里说明哪个文件里有图,模型回答前就知道该去哪里找。
参考来源
- File inputs (PDF files) — OpenAI API documentation
- GPT-4.1 Prompting Guide — OpenAI Cookbook, 2025
- PDF support — Anthropic, Claude documentation
- Long context prompting tips — Anthropic, Claude documentation
- tiktoken — OpenAI, GitHub
常见问题
ChatGPT最适合的文件格式是什么?
文字类文档用 Markdown:它保留标题、列表和表格,token 消耗和纯文本差不多。图表和扫描件用 PDF,数据用 CSV,给程序读的记录用 JSON。
PDF 和 Markdown,哪个是 ChatGPT最适合的文件格式?
内容是文字时,粘贴或上传 Markdown。PDF 会被当作提取文字加页面图像来读,token 更多,而且页眉、页脚和页码会留在文字里。
Markdown 比纯文本更省 token 吗?
几乎没差别。我们的测试中,四个文件合计两者相差约 1%。只有在我们的转换器去掉了重复页眉和页码的文件里,Markdown 才更小。
JSON 适合用来放文档吗?
不适合用来阅读。在我们的测试中,缩进的 JSON 比 Markdown 多用 36% 的 token;根据 OpenAI 的指南,它在长上下文文档上表现也不好。JSON 适合结构化记录。
ChatGPT 能读扫描版 PDF 吗?
能看页面图像的模型可以读懂部分扫描页。扫描件转成 Markdown,没有 OCR 就是空的,所以扫描件请直接发 PDF,或者先做 OCR。
长文档发送前要切分吗?
聊天时,一个结构清楚的文件通常就够了。用于检索,或者碰到上下文长度上限时,按标题切分,让每一部分都保留自己的标题。

