El mejor formato de archivo para ChatGPT, probado con archivos reales
Por Equipo de pdftomd.tools · Actualizado el · 8 min de lectura
Para documentos de texto, un Markdown limpio es el mejor formato de archivo para ChatGPT: títulos, listas y tablas se conservan como caracteres simples, y cuesta más o menos los mismos tokens que el texto plano. Quédate con el PDF cuando importen los gráficos o el diseño de página. Para sacar el Markdown, pasa el archivo por un conversor de PDF a Markdown para LLM y revisa los títulos.
Respuesta corta: ¿cuál es el mejor formato de archivo para ChatGPT?
El mejor formato de archivo para ChatGPT depende de qué sea el documento. En resumen:
| Tu contenido | Dale al modelo | Por qué |
|---|---|---|
| Informes, manuales, contratos, notas | Markdown | La estructura (títulos, listas, tablas) en caracteres simples |
| Texto corrido sin estructura | Texto plano | Mismo coste que Markdown, nada que perder |
| Gráficos, escaneos, formularios, diapositivas | El propio PDF | El modelo necesita las imágenes de las páginas |
| Filas de datos | CSV o una hoja de cálculo | Un registro por fila, fácil de contar y filtrar |
| Registros para un programa | JSON | Campos y tipos exactos, con un coste en tokens mayor |
El resto de esta guía explica por qué: qué recibe de verdad el modelo cuando subes un PDF, qué medimos al contar los tokens de los mismos documentos en seis formatos, y cómo preparar un archivo para que la respuesta se base en la sección correcta.
Qué pasa cuando subes un PDF
Para elegir el mejor formato de archivo para ChatGPT, mira primero en qué se convierte un PDF. Un PDF es una descripción de páginas, no un archivo de texto. Para leerlo, el proveedor del modelo tiene que extraer el texto, y los grandes proveedores además renderizan las páginas como imágenes. Según la guía de archivos de entrada de OpenAI, con un PDF enviado a un modelo que entiende imágenes, la plataforma extrae tanto el texto como una imagen de cada página y le pasa las dos cosas al modelo; los demás archivos de texto entran solo como texto. Anthropic describe el mismo enfoque para Claude:
“El sistema convierte cada página del documento en una imagen. El texto de cada página se extrae y se entrega junto con la imagen de esa página.”
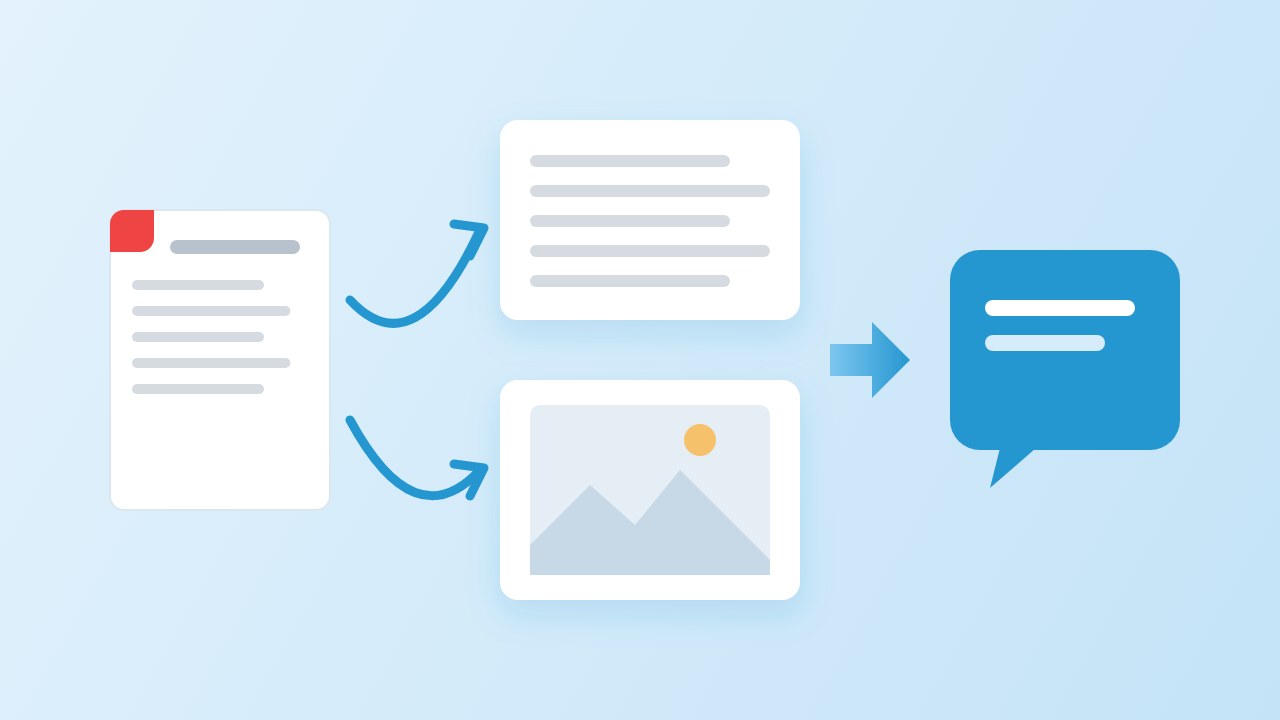
Esa es la clave de Markdown o PDF para IA. Las imágenes ayudan cuando la página tiene un gráfico o una firma escaneada, y cuestan aparte: Anthropic calcula entre 1.500 y 3.000 tokens por página solo para el texto, sin contar las imágenes, y OpenAI avisa de que los PDF de entrada pueden aumentar el uso de tokens. Además, el texto extraído es tan bueno como la capa de texto del PDF; los encabezados repetidos, los números de página y las tablas rotas llegan tal cual. Ambos documentos describen las plataformas para desarrolladores; las apps de chat para el público no publican el mismo nivel de detalle.
Tokens: PDF vs Markdown y otros cuatro formatos
Para tener cifras de tokens de PDF frente a Markdown, el 19 de oct. de 2026 tomamos cuatro PDF y convertimos cada uno en seis formatos de texto: nuestra conversión limpia a Markdown, texto plano de pdftotext con y sin diseño, HTML generado a partir del Markdown, y JSON con un objeto por bloque, con sangría y minificado. Contamos los tokens con la biblioteca tiktoken de OpenAI (codificación o200k_base). No contamos la vía del PDF en sí, porque cada proveedor cobra las imágenes de página a su manera.
| Documento | Markdown | Texto plano | Texto con diseño | HTML | JSON | JSON minificado |
|---|---|---|---|---|---|---|
| Guía en inglés, 5 páginas | 2.651 | 2.667 | 2.724 | 3.237 | 4.086 | 3.195 |
| Informe en chino, 11 páginas | 8.697 | 8.713 | 8.804 | 9.796 | 11.063 | 9.402 |
| Informe en inglés, 4 páginas | 145 | 217 | 229 | 246 | 379 | 225 |
| Tablas, 1 página | 106 | 99 | 102 | 211 | 265 | 154 |
| Los cuatro | 11.599 | 11.696 | 11.859 | 13.490 | 15.793 | 12.976 |
| Respecto a Markdown | 1,00× | 1,01× | 1,02× | 1,16× | 1,36× | 1,12× |
La lectura honesta: Markdown y texto plano cuestan casi lo mismo. En los cuatro archivos, el texto plano fue un 1 % más grande, y en el archivo de tablas de una página incluso algo más pequeño, porque las barras verticales cuestan tokens. La gran diferencia en el informe de 4 páginas viene de la limpieza, no de la sintaxis: el texto plano conservó cuatro copias del encabezado repetido y cuatro números de página. El HTML costó un 16 % más que Markdown, el JSON con sangría un 36 % más y el JSON minificado un 12 % más.
Así que Markdown no es el mejor formato de archivo para ChatGPT por ser diminuto, sino porque su estructura casi no cuesta nada: el texto plano gasta los mismos tokens y tira a la basura los títulos y las columnas de las tablas.
¿Por qué Markdown es mejor para los LLM que JSON o HTML?
Entonces, ¿por qué Markdown es mejor para los LLM? Hay tres razones que se sostienen. Primero, la estructura se ve: una línea ## es una sección, una línea | es una tabla, y un modelo ha visto cantidades enormes de ambas. Segundo, hay poco ruido: sin etiquetas de cierre, sin comillas alrededor de cada clave, sin caracteres escapados. Tercero, las guías de los proveedores apuntan en la misma dirección. La GPT-4.1 Prompting Guide de OpenAI recomienda Markdown como punto de partida para estructurar prompts, señala que JSON puede ser más verboso y obliga a escapar caracteres, e informa de que en sus pruebas de contexto largo JSON funcionó mal como contenedor de muchos documentos, mientras que XML funcionó bien.
Sobre JSON o Markdown para LLM, entonces: usa JSON cuando un programa lea el resultado o los datos sean una lista de registros con campos fijos. Usa Markdown para documentos que un modelo tenga que leer y razonar. Si metes varios documentos a la vez, una etiqueta sencilla alrededor de cada archivo Markdown, por ejemplo <document title="…">, te da la separación que ofrece XML sin convertir el contenido.
Cómo preparar un documento para ChatGPT
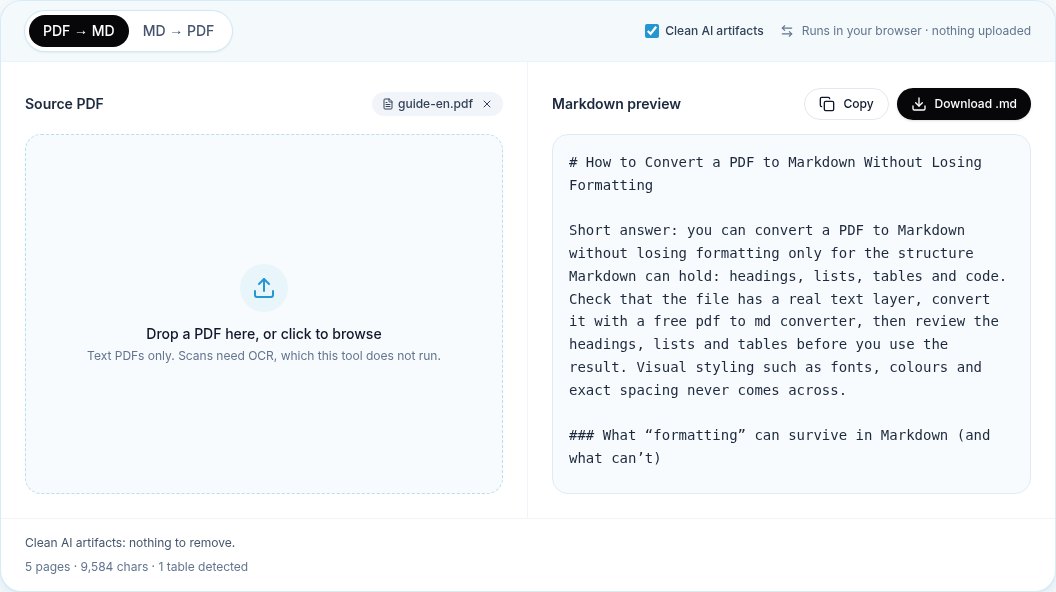
- Convierte a Markdown un PDF con capa de texto, con la limpieza activada, para que desaparezcan los encabezados repetidos y los números de página. Nuestro conversor de PDF a Markdown lo hace en el navegador.
- Revisa la estructura: un título
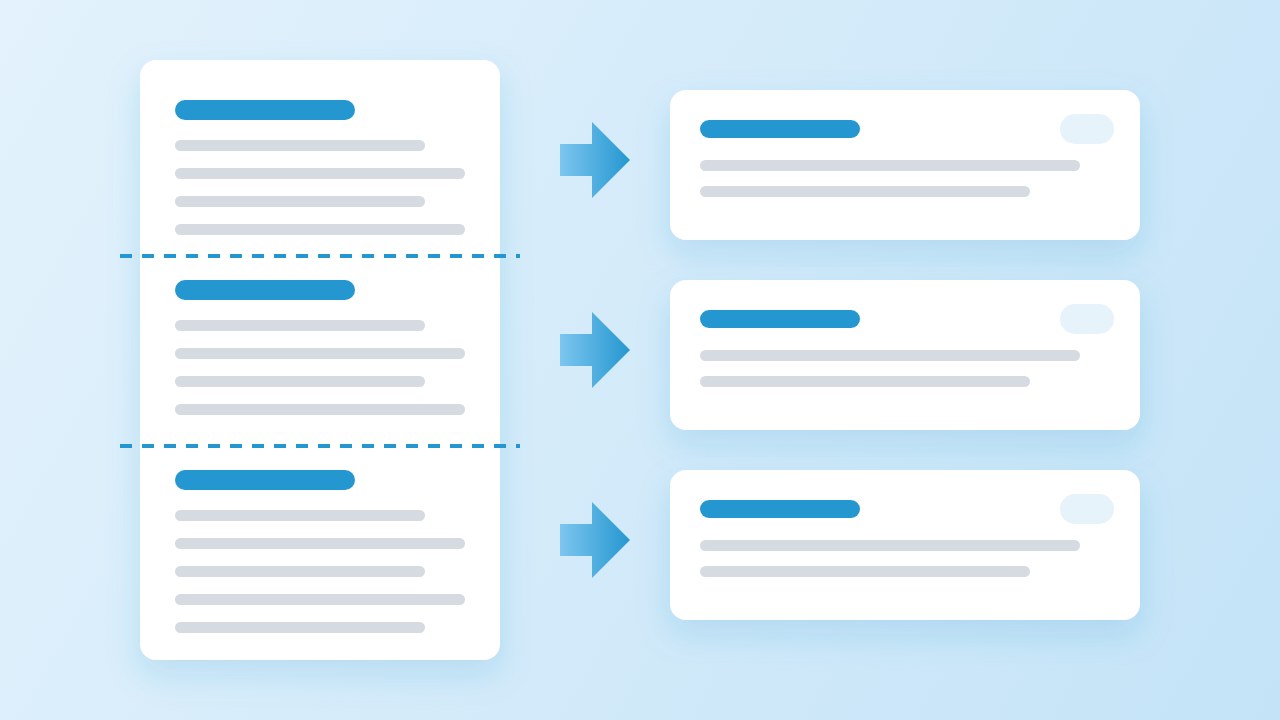
#,##para las secciones, las tablas como tablas con barras verticales. Corrige cualquier título que haya llegado como texto normal. - Divide los archivos largos por títulos, no por un número fijo de caracteres, para que cada fragmento empiece con su propio título. Esto importa sobre todo en sistemas de recuperación (RAG).
- Primero el documento, la pregunta al final. Los consejos para contexto largo de Anthropic recomiendan este orden e indican que mejoró las respuestas hasta un 30 % en sus pruebas.
- Ten el PDF a mano para gráficos y figuras, y súbelo por separado cuando una pregunta trate sobre una imagen.
Para flujos automáticos en lugar de chats sueltos, la vía con Python hace la misma conversión en código, y nuestra guía de conversión en local explica cómo mantener los archivos confidenciales en tu propio equipo hasta que decidas enviarlos.
Cuándo el PDF sigue siendo la opción correcta
Markdown no es en todos los casos el formato que mejor lee ChatGPT. Conserva el original cuando el significado está en la imagen: gráficos y diagramas, páginas escaneadas (el Markdown de un escaneo sale vacío mientras nadie haga OCR), formularios donde importa la posición y diapositivas cuyo diseño es el mensaje. En esos casos, el propio PDF es el mejor formato de archivo para ChatGPT: las imágenes de página que añade el proveedor son justo lo que necesitas, y los tokens extra merecen la pena.
Para un informe largo, el mejor formato de archivo para ChatGPT suele ser una mezcla: envía el Markdown para el texto y las dos o tres páginas con gráficos como un PDF aparte o como imágenes. Así tienes la versión estructurada y barata para la mayoría de las preguntas, y la visual cuando hace falta. Pon nombres claros a los dos archivos, por ejemplo informe.md e informe-graficos.pdf, y di en el prompt cuál contiene las figuras, para que el modelo sepa dónde mirar antes de responder.
Fuentes
- File inputs (PDF files) — OpenAI API documentation
- GPT-4.1 Prompting Guide — OpenAI Cookbook, 2025
- PDF support — Anthropic, Claude documentation
- Long context prompting tips — Anthropic, Claude documentation
- tiktoken — OpenAI, GitHub
Preguntas frecuentes
¿Cuál es el mejor formato de archivo para ChatGPT?
Para documentos de texto, Markdown: conserva títulos, listas y tablas y cuesta más o menos los mismos tokens que el texto plano. Usa el PDF para gráficos y escaneos, CSV para datos y JSON para registros que lee un programa.
¿PDF o Markdown: cuál es el mejor formato de archivo para ChatGPT?
Pega o sube Markdown cuando el contenido es texto. Un PDF se lee como texto extraído más imágenes de página; eso cuesta más tokens y deja en el texto encabezados, pies de página y números de página.
¿Markdown gasta menos tokens que el texto plano?
Apenas. En nuestras pruebas, los dos quedaron a un 1 % aproximado entre sí en cuatro archivos. Markdown solo fue más pequeño donde nuestro conversor quitó encabezados repetidos y números de página.
¿JSON es un buen formato para documentos?
No para leer. En nuestras pruebas, el JSON con sangría costó un 36 % más de tokens que Markdown, y según la guía de OpenAI funcionó mal con documentos de contexto largo. Úsalo para registros estructurados.
¿ChatGPT puede leer PDF escaneados?
Los modelos que ven las imágenes de página pueden leer algunas páginas escaneadas. Una conversión a Markdown de un escaneo sale vacía sin OCR, así que con escaneos envía el PDF o pasa antes un OCR.
¿Debo dividir un documento largo antes de enviarlo?
Para un chat, normalmente basta con un solo archivo bien estructurado. Para recuperación de documentos o si llegas al límite de contexto, divide por títulos para que cada parte conserve su título.

