Texto pronto para modelos
PDF em Markdown para LLM
Atualizado em · Equipe pdftomd.tools
Quando você transforma um PDF em Markdown para LLM, recebe títulos, listas e tabelas como texto puro. Assim um modelo de chat ou um pipeline de recuperação enxerga o documento do jeito que uma pessoa lê.
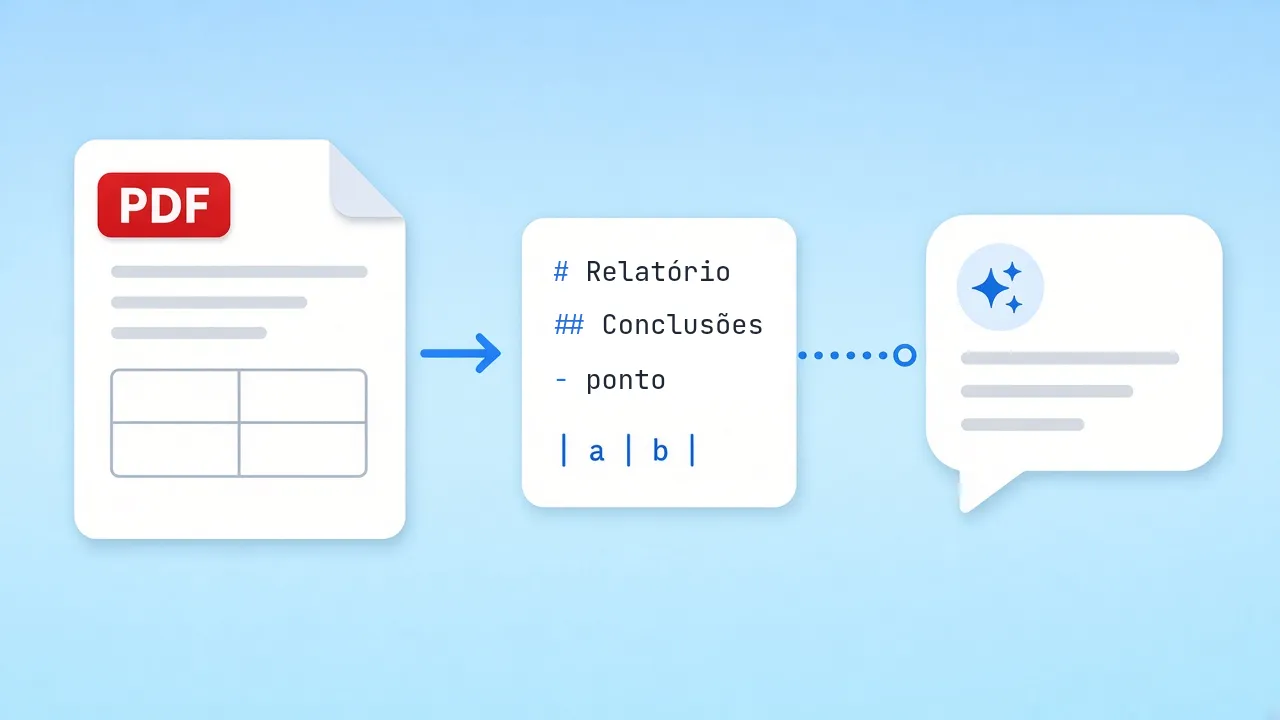
Solte abaixo um arquivo com camada de texto. O resultado de PDF para Markdown aparece à direita, pronto para copiar num prompt ou salvar como .md para o seu pipeline.
PDF de origem
Solte um PDF aqui ou clique para escolher
Só PDFs com texto. Digitalizações precisariam de OCR, e esta ferramenta não faz OCR.
Prévia do Markdown
O Markdown vai aparecer aqui.
Do PDF ao prompt, passando pelo Markdown
Quatro passos que levam alguns segundos e rodam no seu próprio dispositivo.
 01
Solte a fonte
Use uma exportação com camada de texto, não uma digitalização. Só uma camada de texto real garante palavras exatas ao converter PDF para Markdown.
Escolher um arquivo 02
Deixe a estrutura aparecer
Os títulos saem do tamanho da fonte, as listas dos marcadores, e colunas alinhadas viram tabelas. As páginas são unidas num único arquivo, sem marcas de página atrapalhando.
Ver funcionando 03
Tire o ruído
Apague na prévia os cabeçalhos e rodapés repetidos e o enchimento da capa. Menos lixo significa mais espaço para o conteúdo que interessa.
Conferir a saída 04
Copie para o contexto
Cole o Markdown num chat ou salve para um trabalho de indexação. Documentos longos você divide nos títulos.
Copiar o resultado
Por que PDF em Markdown para LLM?
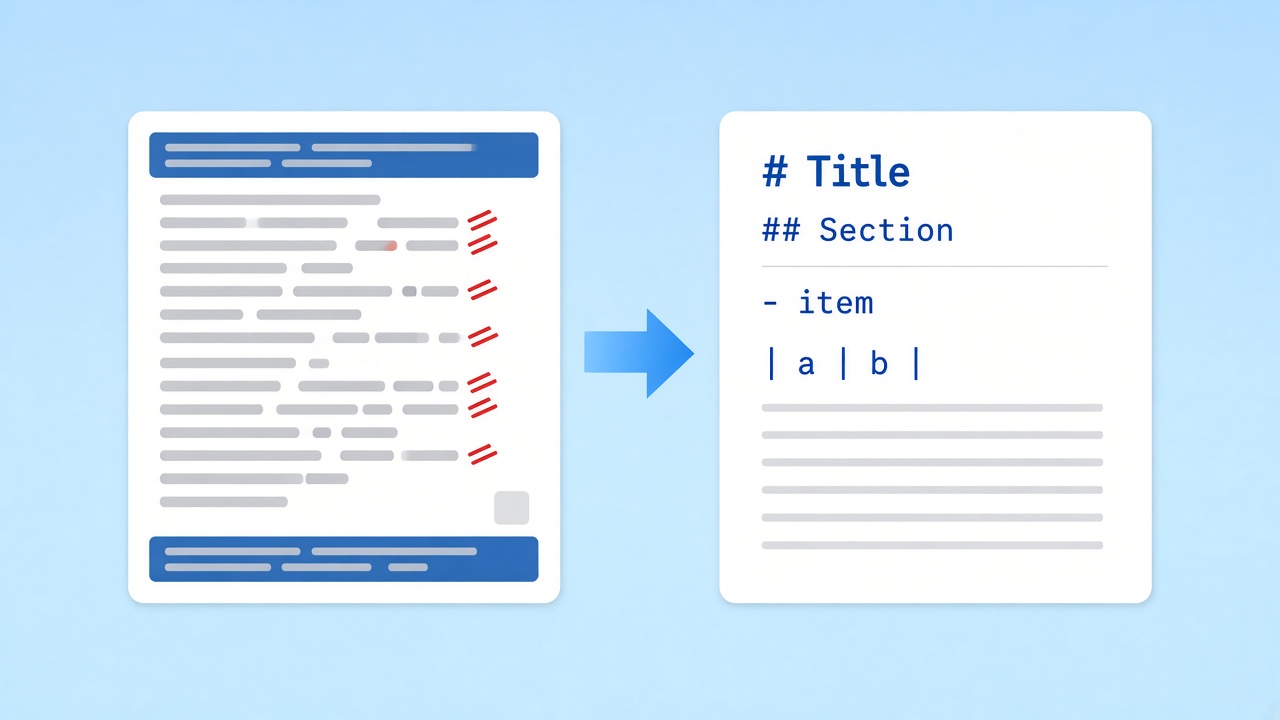
Uma cópia bruta de um layout de impressão mistura cabeçalhos repetidos, números de página, hifenização quebrada e células de tabela que escorregam por várias linhas. Um modelo precisa gastar atenção e tokens desembaraçando isso antes de responder. Converter PDF em Markdown para LLM tira a maior parte desse ruído antes: as seções ficam marcadas com #, os passos com 1. e os dados de tabela com barras GFM, para que o modelo diferencie um título de uma nota de rodapé.
A estrutura também deixa o texto mais fácil de fatiar. Se cada seção começa com um título, um arquivo longo se divide em pedaços independentes, o título fica como rótulo e você pode citar exatamente aquela seção quando uma resposta precisa de fonte. A Anthropic observa que a formatação de um prompt pode influenciar o estilo da resposta, e o guia do GPT-4.1 da OpenAI diz o seguinte sobre Markdown na hora de escolher delimitadores num prompt:
“Recomendamos começar por aqui e usar títulos em Markdown para as seções principais e subseções (incluindo hierarquias mais profundas, até H4+).”
- Títulos marcam cada assunto novo
- Listas e tabelas continuam texto puro legível
- Números de página e cabeçalhos repetidos são removidos
Limites de PDF para Markdown antes do prompt
Números de página e cabeçalhos e rodapés que se repetem na maioria das páginas, em arquivos de três páginas ou mais, são removidos automaticamente; um cabeçalho com texto variável ou presente em poucas páginas pode ficar, então dê uma olhada na prévia. Células mescladas são separadas, tabelas giradas chegam como linhas simples e layouts em duas colunas podem se misturar. Digitalizações não têm camada de texto e a ferramenta não faz OCR. Não há contador de tokens nem divisão automática; divida as saídas longas à mão nos títulos.
PDF em Markdown para projetos com LLM
Três jeitos comuns de as equipes usarem Markdown tirado de PDFs em pipelines com LLM.
Ingestão para RAG
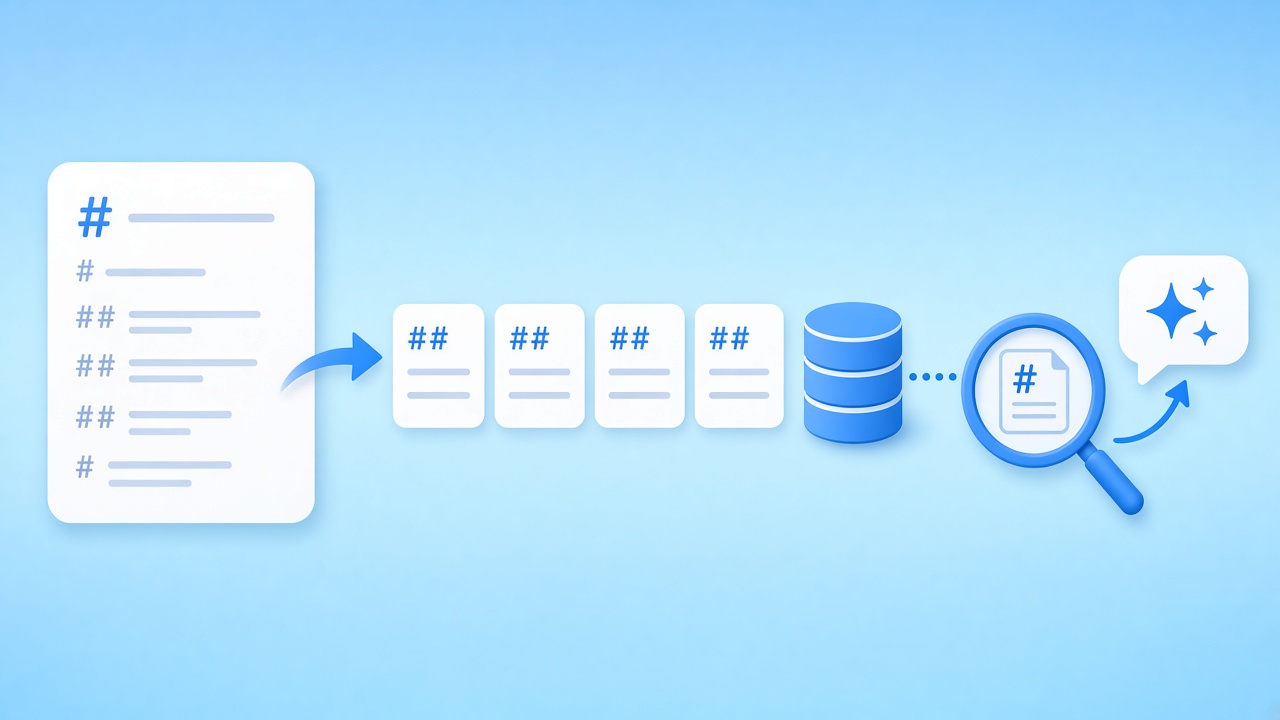
Converta manuais e relatórios de PDF para Markdown para recuperação com LLM, indexe as seções e deixe a busca devolver trechos inteiros com título em vez de fragmentos.
Preparar uma fonte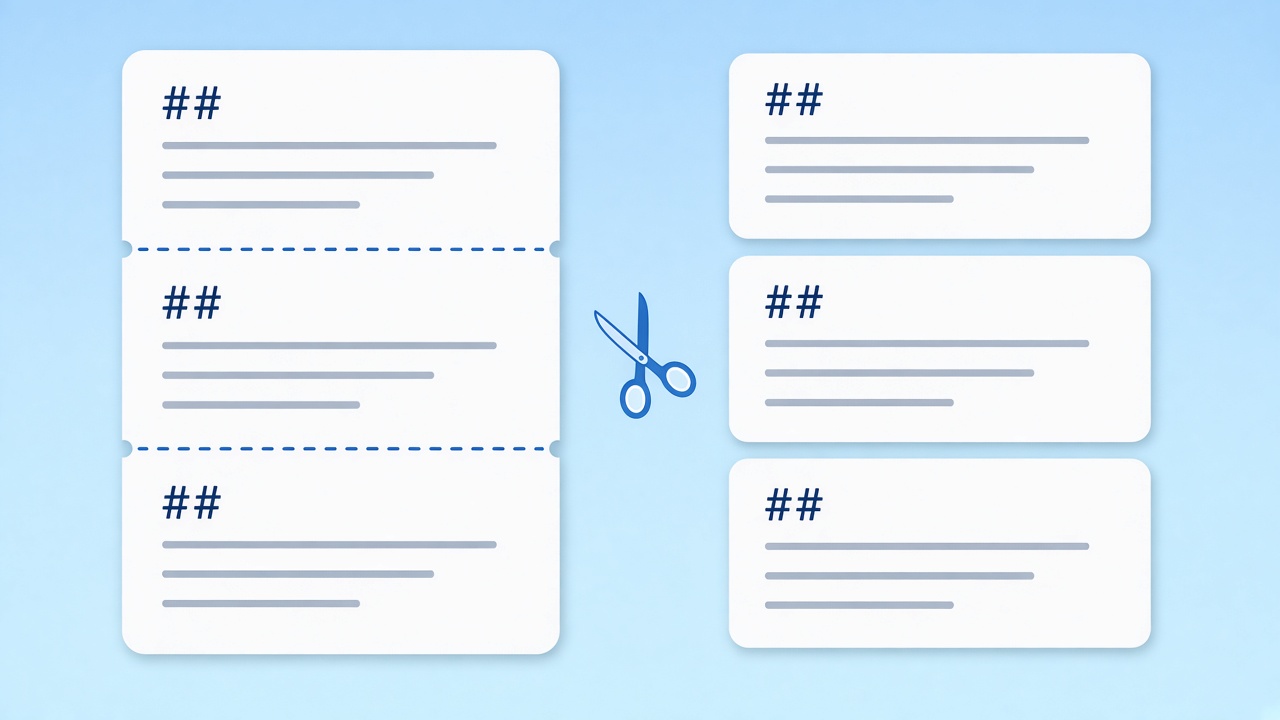
Divisão por títulos
Divida cada arquivo nos títulos ##. Cada pedaço mantém um título claro, o que deixa a recuperação e as citações mais confiáveis.
Converter vários arquivos
Contexto para o chat
Transforme um PDF em Markdown, cole uma seção no chat e faça perguntas específicas. As tabelas chegam com barras, então os números ficam junto dos rótulos.
Copiar uma seção
PDF em Markdown para LLM, convertido com privacidade
A conversão de PDF para Markdown roda com pdf.js no seu navegador, e o arquivo nunca chega aos nossos servidores. Isso importa quando a fonte é um contrato ou um relatório interno: você decide quais seções saem do seu dispositivo e para qual modelo vão.
Transformar uma resposta em documento
Se um modelo escrever um resumo a partir do seu Markdown, a ferramenta do outro lado transforma tudo em páginas A4 para compartilhar, também inteiramente no navegador.
Ferramentas relacionadas
Mais páginas sobre PDF para Markdown.
Transforme agora seu PDF em Markdown para LLM
Solte um documento, tire o ruído e copie texto estruturado para o seu prompt ou pipeline.
Converter um arquivoFontes
- GPT-4.1 Prompting Guide — OpenAI
- Prompting best practices — Anthropic
- GitHub Flavored Markdown Spec — GitHub
Perguntas frequentes
Dúvidas sobre prompts, recuperação e limites.
Por que PDF em Markdown para LLM em vez de texto bruto?
O Markdown marca títulos, listas e tabelas de forma explícita, então o modelo consegue seguir a estrutura sem adivinhar pelas quebras de linha.
A ferramenta conta tokens ou divide o arquivo para mim?
Não. Ainda não há contador de tokens nem divisão automática. Divida saídas longas nos títulos e confira o tamanho com as suas ferramentas de LLM.
As tabelas ficam quando eu converto PDF para Markdown?
Sim, na maioria das tabelas com camada de texto: elas viram tabelas com barras e cabeçalho. Células mescladas são separadas e tabelas giradas chegam como texto simples.
Converter PDF em Markdown para LLM é privado?
Sim. O processamento acontece no seu navegador e o arquivo nunca é enviado. Só sai do seu dispositivo o que você colar num modelo.
Posso converter documentos digitalizados?
Não. Digitalizações não têm camada de texto e a ferramenta não faz OCR. Ela avisa quando um arquivo parece ser feito de imagens.
Qual LLM consegue ler a saída de PDF para Markdown?
Qualquer modelo que aceite texto. Markdown é texto puro: assistentes de chat, jobs de embeddings e modelos locais leem sem problema.
Como divido um arquivo Markdown longo em pedaços?
Corte nos títulos ## ou ###, mantenha o título no começo de cada pedaço e guarde o nome do arquivo, para que as respostas possam apontar a fonte.