Testo pronto per i modelli
PDF in Markdown per LLM
Aggiornato il · Team di pdftomd.tools
Quando trasformi un PDF in Markdown per LLM, ottieni titoli, elenchi e tabelle come testo semplice. Così un modello di chat o una pipeline di recupero vede il documento come lo legge una persona.
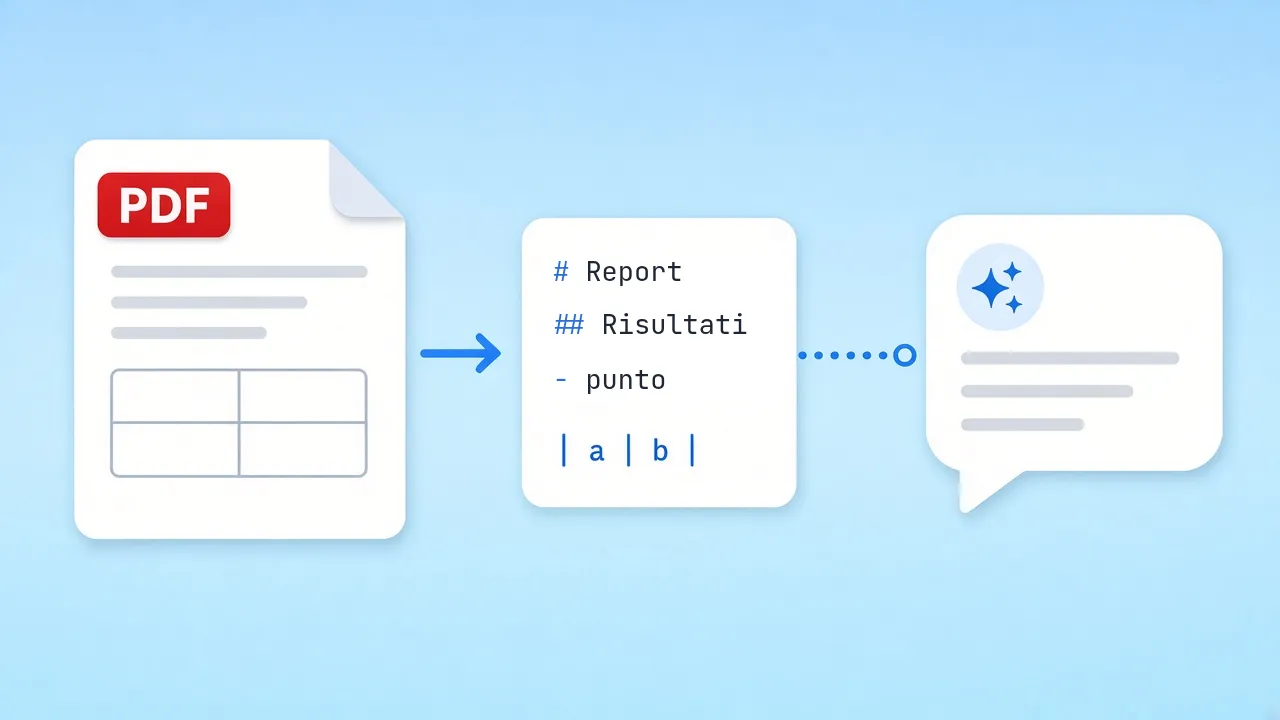
Rilascia qui sotto un file con livello di testo. Il risultato da PDF a Markdown compare a destra, pronto da copiare in un prompt o da salvare come .md per la tua pipeline.
PDF di origine
Trascina qui un PDF o fai clic per sceglierlo
Solo PDF con testo. Le scansioni richiederebbero l’OCR, che questo strumento non esegue.
Anteprima Markdown
Qui comparirà il Markdown.
Dal PDF al prompt, passando per Markdown
Quattro passaggi che durano pochi secondi e girano sul tuo dispositivo.
 01
Rilascia la fonte
Usa un’esportazione con livello di testo, non una scansione. Solo un vero livello di testo dà parole esatte quando converti un PDF in Markdown.
Scegli un file 02
Lascia emergere la struttura
I titoli nascono dalla dimensione del carattere, gli elenchi dai loro simboli, le colonne allineate diventano tabelle. Le pagine vengono unite in un solo file, senza segni di pagina fastidiosi.
Guardalo all’opera 03
Togli il rumore
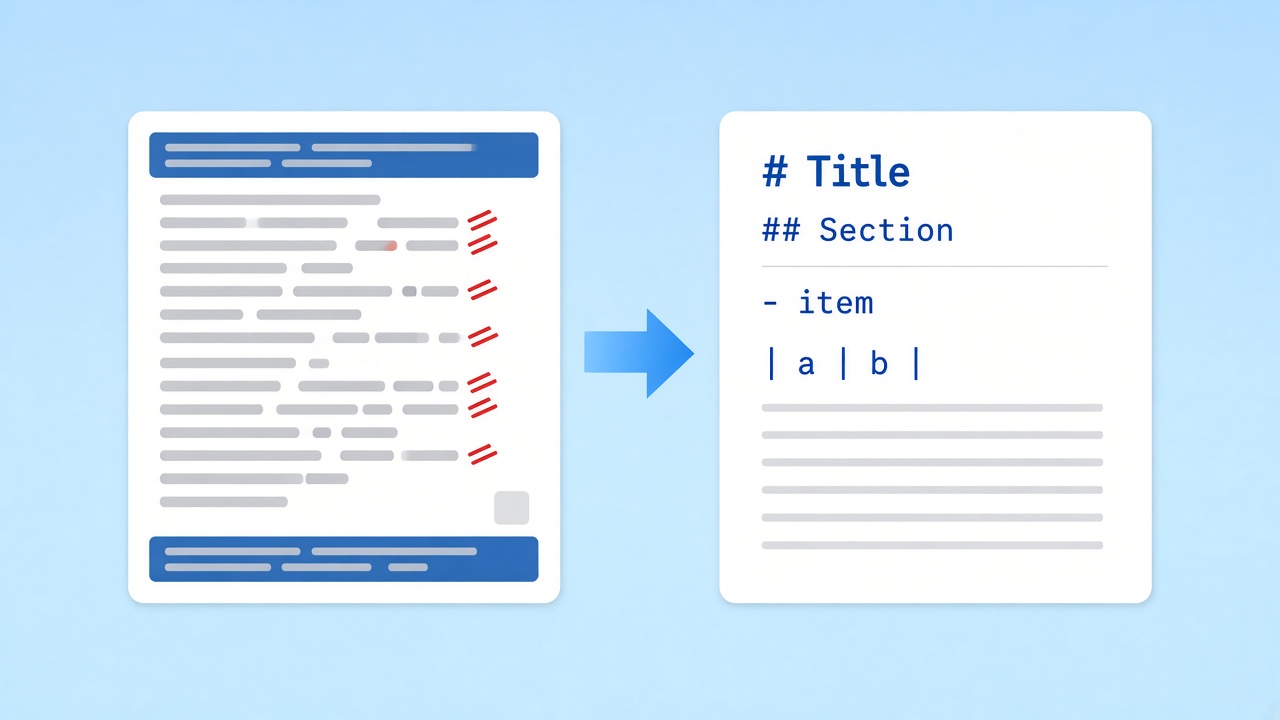
Elimina nell’anteprima intestazioni e piè di pagina ripetuti e il riempitivo della copertina. Meno zavorra significa più spazio per il contenuto che ti interessa.
Controlla l’output 04
Copia nel contesto
Incolla il Markdown in una chat o salvalo per un lavoro di indicizzazione. I documenti lunghi si dividono in corrispondenza dei titoli.
Copia il risultato
Perché un PDF in Markdown per LLM?
Una copia grezza da un layout di stampa mescola intestazioni ricorrenti, numeri di pagina, sillabazioni spezzate e celle di tabella che scivolano su più righe. Un modello deve spendere attenzione e token per districare tutto questo prima di poter rispondere. Convertire un PDF in Markdown per LLM toglie in anticipo gran parte di quel rumore: le sezioni sono segnate con #, i passaggi con 1. e i dati delle tabelle con le barre GFM, così il modello distingue un titolo da una nota a piè di pagina.
La struttura rende anche il testo più facile da suddividere. Se ogni sezione inizia con un titolo, un file lungo si divide in blocchi autonomi, il titolo resta come etichetta e puoi citare proprio quella sezione quando una risposta ha bisogno di una fonte. Anthropic fa notare che la formattazione di un prompt può influenzare lo stile della risposta, e la guida a GPT-4.1 di OpenAI dice questo sul Markdown quando si scelgono i delimitatori di un prompt:
“Consigliamo di partire da qui e di usare i titoli Markdown per le sezioni principali e le sottosezioni (inclusa una gerarchia più profonda, fino a H4+).”
- I titoli segnano ogni nuovo argomento
- Elenchi e tabelle restano testo semplice leggibile
- Numeri di pagina e intestazioni ricorrenti vengono rimossi
I limiti da PDF a Markdown prima di scrivere il prompt
Numeri di pagina, intestazioni e piè di pagina che si ripetono sulla maggior parte delle pagine, nei file da tre pagine in su, vengono rimossi automaticamente; un’intestazione con testo variabile o presente solo su poche pagine può restare, quindi scorri l’anteprima. Le celle unite vengono separate, le tabelle ruotate arrivano come righe semplici e i layout a due colonne possono mescolarsi. Le scansioni non hanno livello di testo e lo strumento non esegue l’OCR. Non c’è un contatore di token né una suddivisione automatica; dividi a mano gli output lunghi in corrispondenza dei titoli.
PDF in Markdown per progetti con LLM
Tre modi comuni in cui i team usano il Markdown ricavato dai PDF nelle pipeline con LLM.
Ingestione RAG
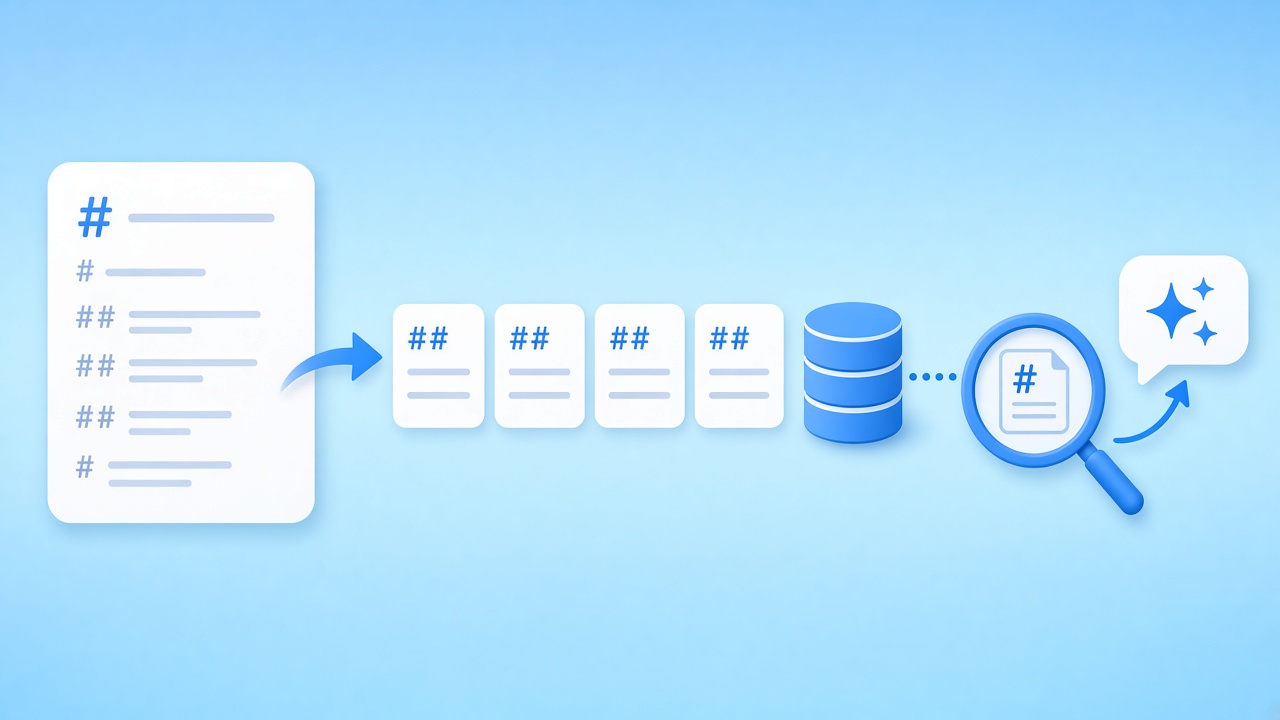
Converti manuali e report da PDF a Markdown per il recupero con LLM, indicizza le sezioni e lascia che la ricerca restituisca passaggi interi con il loro titolo invece di frammenti.
Prepara una fonte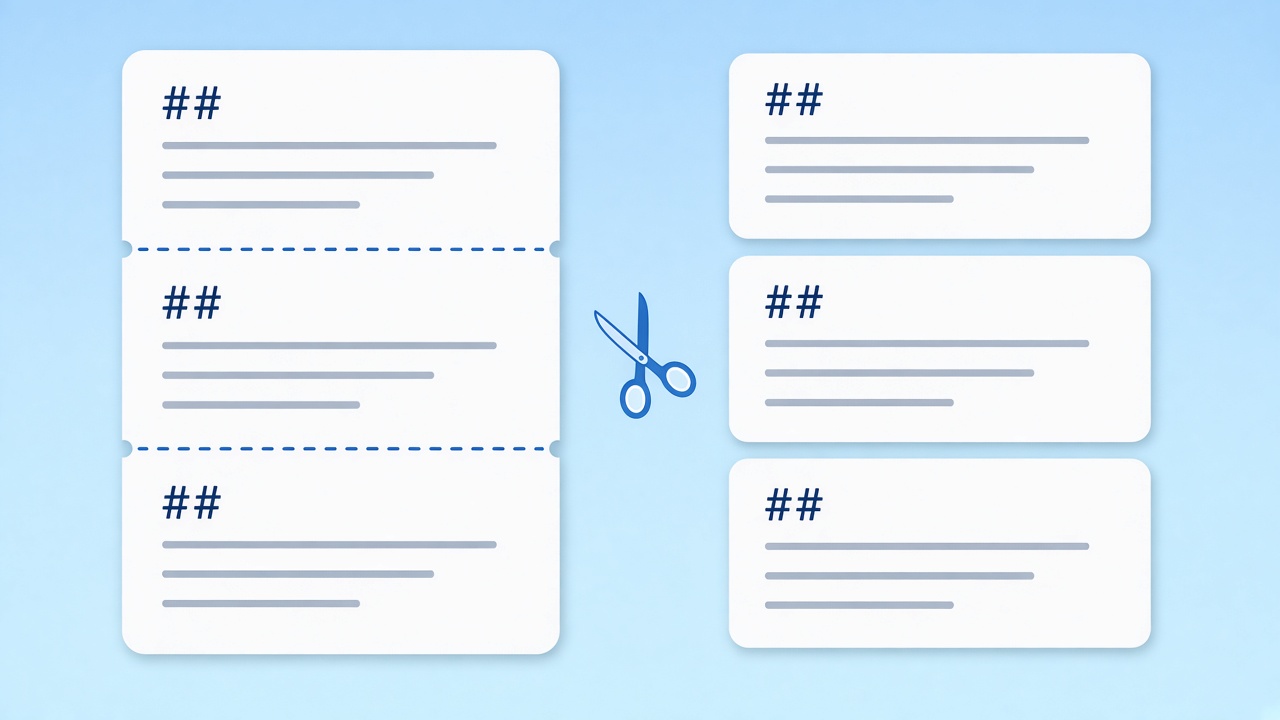
Suddivisione per titoli
Dividi ogni file ai suoi titoli ##. Ogni blocco mantiene un titolo chiaro, e questo rende recupero e citazioni più affidabili.
Converti più file
Contesto per la chat
Trasforma un PDF in Markdown, incolla una sezione nella chat e fai domande mirate. Le tabelle arrivano con le barre, quindi i numeri restano accanto alle etichette.
Copia una sezione
PDF in Markdown per LLM, convertito in privato
La conversione da PDF a Markdown gira con pdf.js nel tuo browser e il file non raggiunge mai i nostri server. Conta quando la fonte è un contratto o un report interno: sei tu a decidere quali sezioni lasciano il dispositivo e a quale modello vanno.
Trasformare una risposta in documento
Se un modello scrive un riassunto a partire dal tuo Markdown, lo strumento opposto lo rende in pagine A4 da condividere, anche questo interamente nel browser.
Strumenti correlati
Altre pagine attorno al passaggio da PDF a Markdown.
Trasforma ora un PDF in Markdown per LLM
Rilascia un documento, togli il rumore e copia testo strutturato nel tuo prompt o nella tua pipeline.
Converti un fileFonti
- GPT-4.1 Prompting Guide — OpenAI
- Prompting best practices — Anthropic
- GitHub Flavored Markdown Spec — GitHub
Domande frequenti
Domande su prompt, recupero e limiti.
Perché un PDF in Markdown per LLM invece del testo grezzo?
Il Markdown segna esplicitamente titoli, elenchi e tabelle, quindi il modello può seguire la struttura senza indovinarla dagli a capo.
Lo strumento conta i token o divide il file per me?
No. Non ci sono ancora un contatore di token né una suddivisione automatica. Dividi gli output lunghi ai titoli e controlla la dimensione con i tuoi strumenti per LLM.
Le tabelle restano quando converto un PDF in Markdown?
Sì, per la maggior parte delle tabelle con livello di testo: diventano tabelle con barre e intestazione. Le celle unite vengono separate, le tabelle ruotate arrivano come testo semplice.
Convertire un PDF in Markdown per LLM è privato?
Sì. L’elaborazione avviene nel tuo browser e il file non viene mai caricato. Lascia il dispositivo solo ciò che incolli in un modello.
Posso convertire documenti scansionati?
No. Le scansioni non hanno livello di testo e lo strumento non esegue l’OCR. Ti avvisa quando un file sembra fatto di immagini.
Quale LLM può leggere l’output da PDF a Markdown?
Qualsiasi modello che accetta testo. Il Markdown è testo semplice: assistenti di chat, processi di embedding e modelli locali lo leggono tutti.
Come divido un lungo file Markdown in blocchi?
Taglia ai titoli ## o ###, tieni il titolo all’inizio di ogni blocco e conserva il nome del file, così le risposte possono rimandare alla fonte.