PDF轉Markdown保留格式:結構不走樣的轉檔方法
作者 pdftomd.tools 團隊 · 更新於 · 約 7 分鐘閱讀
簡短回答:PDF轉Markdown保留格式,只能保留 Markdown 本身表達得了的結構:標題、清單、表格和程式碼。先確認檔案有真正的文字層,再用 免費的PDF轉Markdown工具 轉檔,使用結果前把標題、清單和表格檢查一遍。字型、顏色、精確間距這類視覺樣式,永遠不會跟著過來。

哪些「格式」能在 Markdown 裡留下來(哪些不行)
PDF 描述的是頁面看起來的樣子。這個格式由 ISO 32000-2 定義,會在頁面各個位置存放字符,再加上字型、線條和圖片。除非作者加了標籤,它本身並不知道「這是標題」,而外面流通的檔案大多沒有可用的標籤。Markdown 剛好相反:它記錄每個區塊是什麼(標題、清單項目、表格列),外觀則交給負責顯示的軟體。
所以有人問怎麼把 PDF 轉成 Markdown 又不跑版時,老實的答案是:「格式」可以分成兩類。結構可以重建;外觀不行,因為 Markdown 沒有描述外觀的語法。
| PDF 裡的格式 | 在 Markdown 中 | 說明 |
|---|---|---|
| 標題(字級較大) | 可以 | 依字級重建,需檢查層級 |
| 項目符號與編號清單 | 可以 | 編號會重新寫,不是照抄 |
| 表格 | 可以,轉成直線表格 | 一列標題列,不支援合併儲存格 |
| 連結 | 只有印在頁面上的網址 | 藏在文字後面的連結讀不到 |
| 等寬字型的程式碼 | 可以,轉成程式碼區塊 | 不知道是哪種程式語言 |
| 粗體與斜體 | 我們的工具不行 | 需要分析字重 |
| 圖片與圖表 | 不行 | 需另外匯出 |
| 字型、顏色、頁面版面 | 不行 | Markdown 沒有對應語法 |
“Markdown 格式語法最重要的設計目標,是讓它盡可能好讀。”
就是這個設計目標,讓這筆交換值得。你放棄頁面的精確外觀,換到好讀的純文字:Git diff 乾淨,也能直接貼進 wiki 或聊天模型。CommonMark 規格 定義了核心語法,GitHub Flavored Markdown 再加上表格和工作清單。
先檢查 PDF:文字層、分欄、字型
想讓 PDF轉Markdown保留格式,要從轉檔前開始:花兩分鐘檢查,可以省下一小時修補。用任何閱讀器打開檔案,測一下文字層:試著選取一句話,貼到別的地方。貼得過去,代表頁面有真正的文字。如果整頁被當成一整塊選取,或什麼都選不到,那就是掃描的 PDF,也就是一張沒有可讀字元的頁面照片。
在命令列中,Poppler 的 pdffonts 會列出檔案用到的字型。頁面滿滿都是字,清單卻是空的,幾乎可以確定是掃描檔。接著注意三個版面特徵,它們決定輸出有多乾淨:
- 分欄。雙欄的論文和電子報,會逼轉檔工具去猜閱讀順序。
- 標題樣式。用大字級排的標題很好辨識;只有加粗、字級和內文一樣的標題,在依字級辨識的方式下看起來就是一般段落。
- 字型。等寬字型的程式碼可以轉成程式碼區塊。少見的字型編碼可能讓文字變成方框或亂碼,這是任何轉檔工具都修不好的。
逐步操作:PDF轉Markdown保留格式
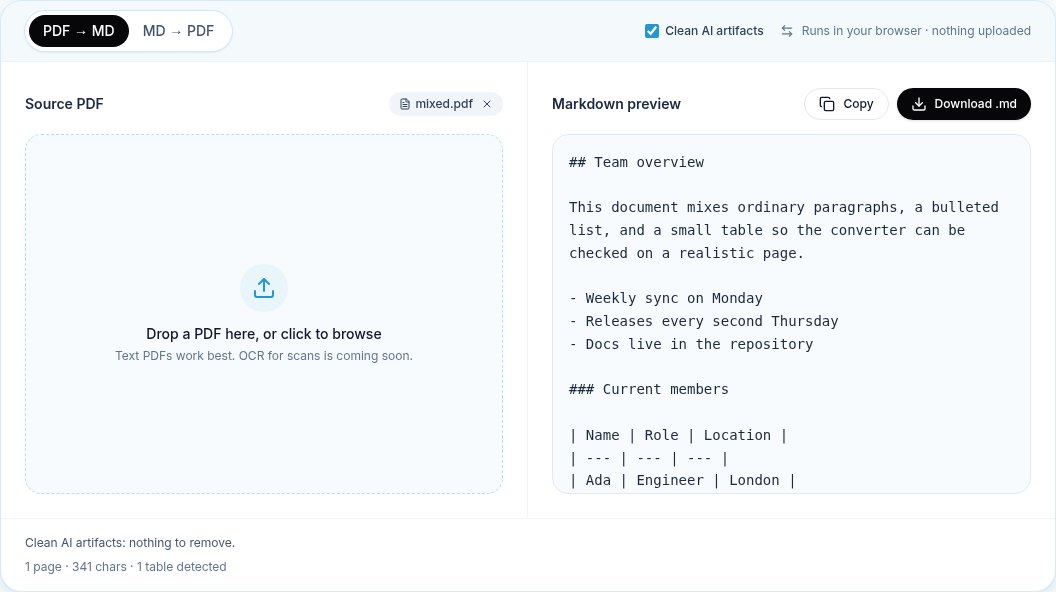
這套流程適用於任何讀取文字層的轉檔工具。我們用自己的工具,因為能說清楚它到底做了什麼:用 pdf.js 讀取文字層,把字詞組成一行行,再依大小和位置重建標題、清單、表格和程式碼。檔案不會上傳。
- 打開轉檔工具,放入檔案。除非你需要原始文字,否則保持「清除 AI 殘留」開啟。
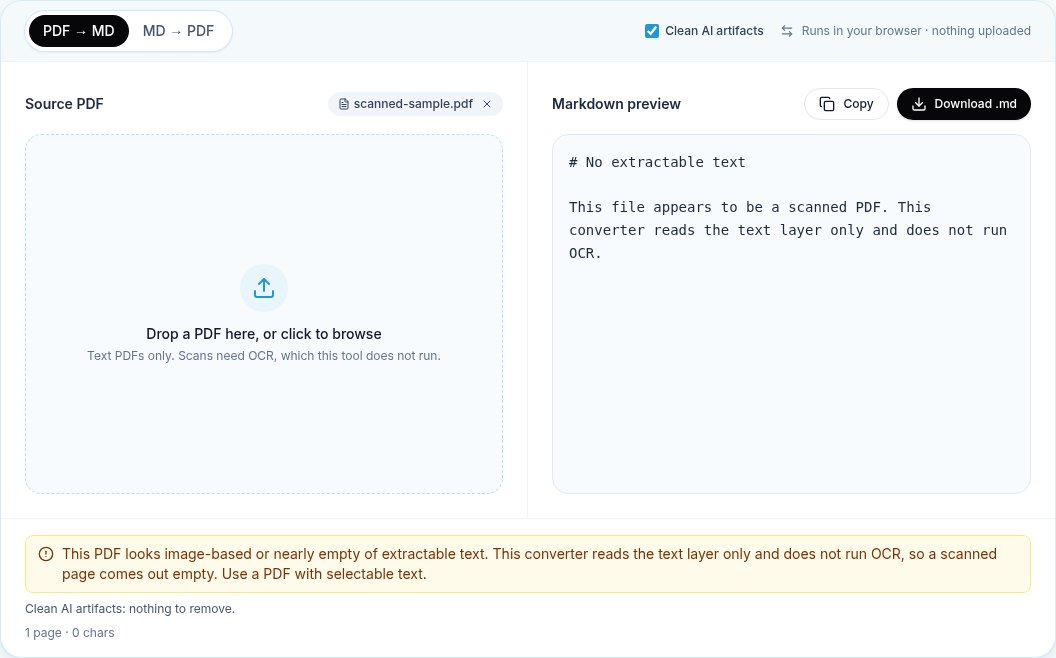
- 看預覽下方的摘要。它會顯示頁數、字元數和找到幾個表格。如果很多頁只有極少的字元,代表其中有些頁是掃描檔。
- 從上到下瀏覽預覽。先看標題層級,再看清單,最後看表格。
- 複製或下載 .md 檔,在編輯器裡打開,旁邊開著預覽。
- 照下面的清單修正問題,再提交或貼上結果。
如果你主要轉報告和手冊,PDF轉MD工具 頁面對標題和清單規則說明得更詳細。以表格為主的檔案,請看我們的 PDF 表格轉 Markdown 教學。
標題、清單和表格:要檢查什麼
標題、清單和表格撐起文件大部分的結構,所以讀者在意的格式留不留得住,主要看這三樣。
標題
為了在轉檔時保住標題,轉檔工具會拿每一行的高度和內文比較。我們的工具把最大的幾級字級對應到 # 到 ####,也會把較短的全大寫行當成標題。檢查兩件事:文件標題是不是唯一的 #;章節和小節的層級有沒有對調。只比內文大一點點的章標題,可能會掉一級。
清單
清單項目依項目符號(•、–、*)或帶句點、括號的數字辨識。編號項目每次都寫成 1.,Markdown 會顯示成 1、2、3。注意換到第二行的項目:在 PDF 裡第二行只是另一段文字,但它應該留在同一個項目裡。
表格
表格最常需要手動處理。有框線的表格和對齊整齊的欄位,通常轉得不錯。我們用 12 種表格版面測試,8 種單一表格版面和一頁兩個表格的版面都還原出預期的列,雙欄文字頁也正確地沒有產生表格。旋轉 90 度的表格沒有被辨識出來。合併儲存格會被拆開,因為直線表格無法表達合併。
會遺失的:粗體/斜體、插圖、分欄
沒有任何工具能把 PDF 轉成 Markdown 而完全不掉格式。有些損失來自格式本身,有些是特定工具的限制,分清楚很有幫助。
- 粗體與斜體。Markdown 有
**粗體**和*斜體*,所以這是工具的限制,不是格式的限制。我們的轉檔工具還辨識不出強調,只會輸出沒有標記的文字。在有意義的地方(例如警告)把強調補回去。 - 插圖與圖表。它們是繪圖或嵌入的圖片,不是文字,會被略過。需要的圖片另外匯出,再用
連結。 - 註腳。註腳文字會留下,但註腳標記和註腳之間的對應會消失。重要的註腳請手動補回。
- 多欄版面。閱讀順序不明確時,欄與欄可能混在一起。檢查每一節的第一頁。
- 精確間距與分頁。頁面邊界會被移除,被分頁切斷的段落在安全的情況下會重新接起來。
重複的頁首頁尾和頁碼是特例:這種格式通常你巴不得拿掉。我們的轉檔工具會刪除在多數頁面頂端或底部重複出現的行,所以「年度報告 · 第 7 頁」不會卡在段落中間。
轉檔後的整理清單
PDF轉Markdown保留格式的最後一步,是快速看過一遍。在編輯器裡開著預覽,對照這份清單;一般報告幾分鐘就能檢查完。
- 最上面一個
#標題,章節用##。跳級的地方改回來。 - 沒有把零散的頁首或圖說誤當成標題。
- 清單項目完整,換行的部分留在所屬的項目裡。
- 每個表格都有標題列,每一列的儲存格數量相同。
- 合併或空白的儲存格已填好,或在表格下方加註說明。
- 會改變意思的地方補上強調。
- 原本有插圖的位置加上圖片預留位置或連結。
- 補上連結:我們的轉檔工具會把印出來的網址當成文字保留,但讀不到藏在文字後面的連結。
對聊天模型或 RAG 索引來說,標題最重要,因為它們會變成切塊的邊界;我們的 AI 用教學 專門說明這種情境。
什麼時候換別的工具比較適合(OCR、版面模型)
讀取文字層的轉檔工具,適合從文書處理軟體、簡報軟體或排版系統匯出的檔案。以下三種情況,與其和輸出結果搏鬥,不如換工具。
- 掃描檔。掃描的 PDF 要先做 OCR。OCRmyPDF 能替掃描檔加上可搜尋的文字層,之後文字轉檔工具就讀得到了。
- 複雜版面。公式多、多欄、表格密集的論文,可以考慮 Docling 這類以版面模型為基礎的工具,它們表示支援頁面版面、閱讀順序和表格結構。這些工具用 Python 在本機執行,安裝比較麻煩。
- 大量掃描檔與文字混合的檔案。marker 可以結合文字層、OCR 和選用的 LLM 輔助。商業使用前,先確認模型權重的授權條款。
不管選哪一個,檢查這一步都要保留:檔案裡從來沒存過的格式,任何工具都留不住。我們的 關於 頁面列出了轉檔工具做不到的事,包括 OCR。
資料來源
- ISO 32000-2:2020 Document management — Portable document format — Part 2: PDF 2.0 — ISO, 2020
- CommonMark Spec, version 0.31.2 — CommonMark, 2024
- GitHub Flavored Markdown Spec — GitHub, 2019
- Markdown — Daring Fireball (John Gruber), 2004
- pdf.js — Mozilla
- pdffonts(1) manual page — Poppler / Debian
- OCRmyPDF — OCRmyPDF project
- Docling — Docling project
常見問題
PDF轉Markdown能保留格式嗎?
結構可以保留:標題、清單、表格、程式碼,以及印在頁面上的網址。字型、顏色、分欄和精確間距這類視覺樣式留不住,因為 Markdown 沒有對應語法。Markdown 有粗體和斜體,但我們的轉檔工具目前還辨識不出來。
為什麼我的標題變成一般段落?
包括我們在內,多數轉檔工具都靠字級辨識標題。加粗但字級和內文一樣的標題,看起來就像段落。手動加上 #,或看看原始文件能不能用真正的標題樣式重新匯出。
怎麼知道我的 PDF 有沒有文字層?
試著選取並複製一句話。能以文字貼上,就有文字層。在命令列中,pdffonts file.pdf 會列出檔案的字型;頁面滿是文字卻沒有任何字型,通常就是掃描檔。
轉檔時表格會怎樣?
辨識出的表格會變成有一列標題列的 GitHub 風格直線表格。合併儲存格會被拆開,內容放在第一格、後面接空白格;跨頁的表格會變成每頁一個表格。解決方法請看我們的 表格教學。
掃描的 PDF 可以轉檔嗎?
讀取文字層的轉檔工具不行。掃描檔沒有可讀的字元,所以我們的工具會顯示「沒有可讀取的文字」。先用 OCRmyPDF 這類工具做 OCR,再轉換結果。OCR 本身也會出錯,所以掃描檔比較難保留格式。
轉檔時檔案會上傳嗎?
我們的轉檔工具不會。PDF 由瀏覽器分頁裡的 pdf.js 讀取。網站會蒐集哪些資訊,請見我們的 隱私權政策。