PyMuPDF4LLM vs pdfplumber vs Marker, probados con PDF reales
Por Equipo de pdftomd.tools · Actualizado el · 9 min de lectura
La respuesta corta de nuestras pruebas: pymupdf4llm es la mejor opción por defecto, rápida y con los títulos más limpios, si la licencia AGPL te sirve. pdfplumber, con licencia MIT, es el más preciso en tablas con bordes, pero no genera ningún título. marker es el que mejor maneja las tablas sin bordes y limpia lo que sobra en las páginas, pero en CPU es varias veces más lento y estropeó nuestro texto chino. Para un solo archivo, nuestra guía de PDF a Markdown con Python también ofrece una vía sin instalar nada.
PyMuPDF4LLM vs pdfplumber vs Marker: el veredicto
| Si necesitas… | Elige | Por qué |
|---|---|---|
| Buen Markdown, rápido y con títulos | pymupdf4llm | Todos los títulos esperados en el nivel correcto en los tres documentos |
| Celdas exactas en tablas con bordes y licencia permisiva | pdfplumber | Exacto en cuadrículas con bordes y celdas combinadas; licencia MIT |
| Tablas sin bordes y sin encabezados repetidos | marker | Encontró los dos ejemplos sencillos sin bordes; quitó encabezados y números de página |
| Texto en chino o japonés | pymupdf4llm | Conservó todos los caracteres y la puntuación; marker perdió caracteres |
Ninguna biblioteca ganó todas las pruebas. El resto del artículo muestra las cifras detrás de cada fila, para que puedas decidir entre pymupdf4llm vs pdfplumber vs marker con los PDF que de verdad tienes.
Cómo probamos: equipo, versiones y documentos
Para que la comparación fuera justa, cada biblioteca recibió los mismos archivos en la misma máquina. Todas las ejecuciones fueron análisis de PDF puro en CPU: Intel(R) Xeon(R) Processor, 8 vCPU, 16 GB de RAM, sin GPU, Linux 6.12.94+ x86_64, Python 3.13.5. Versiones: pymupdf4llm 1.28.2 (PyMuPDF 1.28.2), pdfplumber 0.11.9 (pdfminer.six 20251230), marker-pdf 2.0.0 (surya-ocr 0.22.1, torch 2.14.1+cpu). Contamos los tokens con tiktoken 0.14.0 y la codificación o200k_base. La prueba se hizo el 19 de octubre de 2026.
- Documentos: una guía en inglés de 5 páginas con 13 títulos y una tabla; un informe en chino de 11 páginas con 29 títulos y 4 tablas; un informe en inglés de 4 páginas con un encabezado y un número de página repetidos en cada página.
- Ejemplos de tablas: 11 PDF de una página cuyas tablas correctas conocemos celda por celda, dos de ellos sin ninguna tabla.
- Configuración: los valores por defecto de cada biblioteca. pdfplumber no tiene salida en Markdown, así que escribimos unas veinte líneas que colocan sus líneas de texto y los resultados de
find_tables()en orden de lectura. marker se ejecutó una vez con su configuración por defecto (modo rápido, el predeterminado en CPU) y otra con--disable_ocr. - Cronometraje: la mediana de tres ejecuciones. Los modelos de marker se cargaron una vez antes (4,79 segundos) y se descartó una ejecución de calentamiento.
import pymupdf4llm
md = pymupdf4llm.to_markdown("report.pdf")

import pdfplumber
with pdfplumber.open("report.pdf") as pdf:
    for page in pdf.pages:
        lines = page.extract_text_lines()
        tables = page.find_tables()

from marker.converters.pdf import PdfConverter
from marker.models import create_model_dict
from marker.output import text_from_rendered
converter = PdfConverter(artifact_dict=create_model_dict())
md, _, _ = text_from_rendered(converter("report.pdf"))En CPU, marker 2.0 también necesita un binario llama-server de llama.cpp, que se instala aparte según su README, y en el primer arranque descargó unos 1,8 GB de archivos de modelo en nuestra máquina. Nuestros dos primeros intentos fallaron: una vez por versiones incompatibles de torch y torchvision, otra porque faltaba llama-server. Fueron problemas de instalación, no fallos de la biblioteca, pero conviene reservar tiempo para ello.
Velocidad y número de tokens
| Biblioteca | Guía en inglés (5 p.) | Informe en chino (11 p.) | Informe en inglés con encabezados repetidos (4 p.) | Tokens, informe en chino |
|---|---|---|---|---|
| pymupdf4llm | 0,693 s | 1,419 s | 0,387 s | 8908 |
| pdfplumber | 0,713 s | 3,579 s | 0,023 s | 8782 |
| marker (por defecto) | 3,354 s | 4,563 s | 2,325 s | 10001 |
| marker (--disable_ocr) | 1,425 s | 3,146 s | 0,447 s | 10001 |
En velocidad es donde pymupdf4llm vs pdfplumber vs marker más se diferencian. pdfplumber fue el más rápido con el informe corto (0,023 s), pero el más lento de las herramientas ligeras con el informe en chino. pymupdf4llm se mantuvo estable, entre 0,1 y 0,14 segundos por página. marker fue 5 veces más lento que pymupdf4llm con la guía en inglés, aun con los modelos ya cargados; con --disable_ocr la diferencia se redujo.
Los tokens de las dos bibliotecas ligeras fueron parecidos. marker generó alrededor de un 12 % más de tokens con el informe en chino, en parte por etiquetas <sup> y espacios de más, y menos con el informe corto, porque eliminó los encabezados repetidos.
Títulos y elementos sobrantes de la página
| Biblioteca | Guía en inglés (13) | Informe en chino (29) | Informe en inglés con encabezados repetidos (4) |
|---|---|---|---|
| pymupdf4llm | 13 (13 en el nivel correcto) | 29 (29 en el nivel correcto) | 4 (4 en el nivel correcto) |
| pdfplumber | 0 (0 en el nivel correcto) | 0 (0 en el nivel correcto) | 0 (0 en el nivel correcto) |
| marker (por defecto) | 11 (4 en el nivel correcto) | 23 (14 en el nivel correcto) | 4 (3 en el nivel correcto) |
| marker (--disable_ocr) | 11 (4 en el nivel correcto) | 23 (14 en el nivel correcto) | 4 (3 en el nivel correcto) |
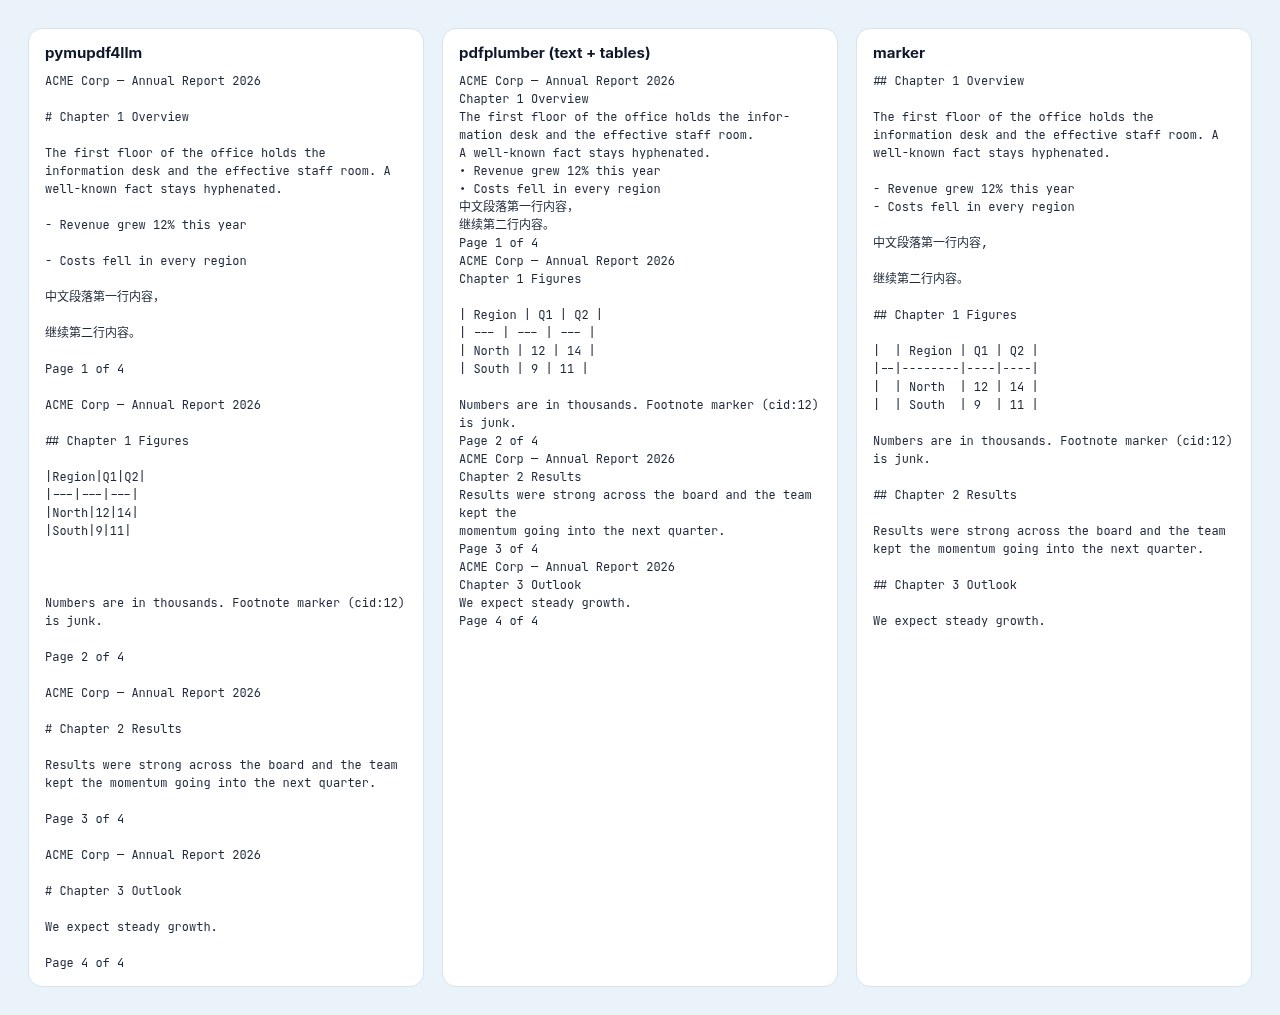
Los títulos son la segunda gran diferencia. pymupdf4llm encontró todos los títulos en el nivel correcto. También marcó como títulos las preguntas frecuentes en negrita de la guía (6 líneas), lo que puede ser útil. pdfplumber no sabe de títulos: obtienes texto plano. marker encontró la mayoría, pero a menudo en un nivel equivocado.
En el informe de 4 páginas, pymupdf4llm y pdfplumber conservaron las 4 copias del encabezado repetido y los 4 números de página; marker quitó ambos. Es el caso más claro de pymupdf4llm vs marker: el modelo de maquetación de marker sabe qué es un encabezado y las bibliotecas ligeras no. pdfplumber también dejó una palabra cortada al final de una línea.
Tablas: con bordes, sin bordes y combinadas
| Ejemplo | pymupdf4llm | pdfplumber | marker |
|---|---|---|---|
| Cuadrícula con bordes | exacta | exacta | exacta |
| Exportación de ofimática | 81 % de las celdas | exacta | 94 % de las celdas |
| Sin bordes | 40 % de las celdas | no encontrada | 90 % de las celdas |
| Celdas de varias líneas | exacta | exacta | 83 % de las celdas |
| Sin bordes, varias líneas | no encontrada | no encontrada | 83 % de las celdas |
| Ofimática, sin bordes | no encontrada | no encontrada | no encontrada |
| Tabla dentro del texto | exacta | no encontrada | exacta |
| Dos tablas | exacta | 33 % de las celdas | exacta |
| Celdas combinadas | 83 % de las celdas | exacta | 42 % de las celdas |
En tablas, el orden depende de si el PDF tiene líneas dibujadas. Las tablas de pdfplumber son exactas cuando el PDF dibuja la cuadrícula, incluso con celdas combinadas, porque find_tables() sigue los trazos. Sin trazos, no encontró nada. pymupdf4llm fue exacto en la mayoría de las tablas con bordes, pero rompió una tabla de ofimática en la que una celda contenía un | sin escapar. marker encontró los dos ejemplos sencillos sin bordes con un 83–90 % de las celdas, mientras que pymupdf4llm encontró uno con un 40 % y pdfplumber ninguno; eso sí, en el ejemplo de celdas combinadas marker fusionó columnas.
Ninguna biblioteca detectó la tabla sin bordes de una exportación de ofimática. Si las tablas son tu prioridad, nuestra guía de tablas en PDF explica por qué las tablas sin bordes son difíciles para cualquier herramienta.
Texto chino: cobertura, espacios y puntuación
| Biblioteca | Caracteres chinos conservados | Espacios dentro de frases | Saltos de línea dentro de frases | Comas de ancho completo conservadas |
|---|---|---|---|---|
| pymupdf4llm | 100 % | 159 | 0 | 100 % |
| pdfplumber | 100 % | 0 | 140 | 100 % |
| marker (por defecto) | 98,6 % | 166 | 0 | 0 % |
El texto chino vuelve a cambiar el orden. El PDF original no tiene espacios dentro de las frases. pymupdf4llm conservó todos los caracteres y todas las comas de ancho completo, pero insertó 159 espacios dentro de frases. pdfplumber también conservó los caracteres, pero dejó 140 saltos de línea a mitad de frase. marker perdió el 1,4 % de los caracteres, incluidos algunos títulos de sección, cambió cada coma de ancho completo por una coma ASCII y añadió 152 etiquetas <sup>. Con PDF en chino, la salida de marker fue la que más retoques necesitó en nuestras pruebas.
Licencias: AGPL vs MIT vs Apache, más las condiciones de los modelos
- pdfplumber: MIT, según su archivo LICENSE. Puedes usarlo en código propietario y comercial siempre que conserves el aviso de licencia.
- pymupdf4llm y PyMuPDF: los repositorios incluyen la GNU AGPL 3.0 y los metadatos del paquete dicen «Dual Licensed - GNU AFFERO GPL 3.0 or Artifex Commercial License». En resumen: si distribuyes un programa que se apoya en ellos, o pones una versión modificada a disposición de usuarios a través de una red, la AGPL espera que compartas el código fuente de ese programa con la misma licencia, salvo que compres una licencia comercial a Artifex.
- marker: el código es Apache-2.0, pero los pesos de los modelos usan una licencia AI Pubs Open RAIL-M modificada. Según MODEL_LICENSE, los pesos son gratuitos para investigación, uso personal y organizaciones con menos de 5 M$ de ingresos brutos o financiación; por encima, hace falta una licencia de Datalab.
Si la licencia decide por ti, AGPL vs MIT es la verdadera elección entre las dos bibliotecas ligeras para la mayoría de los equipos comerciales, y marker añade un umbral de ingresos. Esto es un resumen, no asesoramiento legal; lee los archivos de licencia antes de publicar nada.
Fuentes
- PyMuPDF4LLM documentation — Artifex
- pymupdf4llm repository and licence — GitHub
- pdfplumber README and LICENSE.txt — GitHub
- marker README, LICENSE and MODEL_LICENSE — GitHub (Datalab)
- GNU Affero General Public License v3.0 — Free Software Foundation
- tiktoken — GitHub (OpenAI)
Preguntas frecuentes
¿Cuál es mejor: pymupdf4llm vs pdfplumber vs marker?
En nuestras pruebas, pymupdf4llm para documentos normales y texto chino, pdfplumber para tablas con bordes exactas con licencia MIT, y marker para tablas sin bordes y páginas con encabezados repetidos.
¿pymupdf4llm es gratis para uso comercial?
Con la AGPL, sí, si también publicas tu código fuente cuando distribuyes el programa o lo ofreces como servicio. Si no, Artifex vende una licencia comercial.
¿marker necesita GPU?
No. Funcionó en nuestra máquina de 8 vCPU sin GPU, pero necesitó llama-server de llama.cpp y fue varias veces más lento que las bibliotecas ligeras.
¿pdfplumber puede generar Markdown?
No directamente. Devuelve texto, palabras, líneas y tablas; el Markdown lo escribes tú, como hicimos en esta prueba.
¿Qué biblioteca maneja PDF escaneados?
marker está construido alrededor de modelos de OCR. Con su configuración por defecto, pymupdf4llm y pdfplumber leen la capa de texto, así que un escaneo queda vacío.
¿Puedo repetir esta prueba?
Sí. El script, las versiones y el equipo están indicados arriba; los tiempos cambiarán en otra máquina, los resultados de calidad no deberían.