PyMuPDF4LLM vs pdfplumber vs Marker:拿真實 PDF 實測
作者 pdftomd.tools 團隊 · 更新於 · 約 6 分鐘閱讀
直接講結果:如果你能接受 AGPL 授權,pymupdf4llm 是最穩的預設選擇,跑得快,標題也抓得最乾淨。pdfplumber 是 MIT 授權,有框線的表格最準,但一個標題都不會產生。marker 最會處理無框線表格,也能把頁面上的雜訊清掉,只是在 CPU 上慢了好幾倍,還把我們的中文弄壞了。如果只是轉一個檔案,可以看 Python PDF轉Markdown 教學,裡面也有完全不用安裝的做法。
PyMuPDF4LLM vs pdfplumber vs Marker:先看結論
| 如果你需要…… | 就選 | 原因 |
|---|---|---|
| 快速產出有標題的 Markdown | pymupdf4llm | 三份文件中預期的標題全都抓到,層級也正確 |
| 有框線表格的儲存格要準、授權要寬鬆 | pdfplumber | 有框線表格與合併儲存格都完全正確;MIT 授權 |
| 無框線表格、拿掉重複頁首 | marker | 兩個簡單的無框線範例都有找到;頁首和頁碼都刪掉了 |
| 中文或日文內容 | pymupdf4llm | 每個字和標點都保留;marker 掉了字 |
沒有一個函式庫每項都贏。下面列出每一列背後的數據,你可以用自己手上的 PDF,在 pymupdf4llm vs pdfplumber vs marker 之間做判斷。
怎麼測:硬體、版本、文件
為了公平,三個函式庫都在同一台電腦上處理同一批檔案,而且全部只用 CPU 解析 PDF:Intel(R) Xeon(R) Processor、8 個 vCPU、16 GB 記憶體、沒有 GPU、Linux 6.12.94+ x86_64、Python 3.13.5。版本:pymupdf4llm 1.28.2(PyMuPDF 1.28.2)、pdfplumber 0.11.9(pdfminer.six 20251230)、marker-pdf 2.0.0(surya-ocr 0.22.1、torch 2.14.1+cpu)。token 數用 tiktoken 0.14.0 的 o200k_base 編碼計算,測試日期為 2026 年 10 月 19 日。
- 文件:5 頁的英文指南,有 13 個標題和 1 個表格;11 頁的中文報告,有 29 個標題和 4 個表格;4 頁的英文報告,每頁都有相同的頁首和頁碼。
- 表格範例:11 個單頁 PDF,我們知道每個儲存格的正確內容,其中兩個完全沒有表格。
- 設定:一律用各函式庫的預設值。pdfplumber 沒有 Markdown 輸出,所以我們寫了大約二十行程式,把文字行和
find_tables()的結果依閱讀順序接起來。marker 先用預設設定(CPU 上預設的快速模式)跑一次,再加上--disable_ocr跑一次。 - 計時:取三次執行的中位數。marker 的模型事先載入過一次(4.79 秒),也捨棄了一次暖機執行。
import pymupdf4llm
md = pymupdf4llm.to_markdown("report.pdf")

import pdfplumber
with pdfplumber.open("report.pdf") as pdf:
    for page in pdf.pages:
        lines = page.extract_text_lines()
        tables = page.find_tables()

from marker.converters.pdf import PdfConverter
from marker.models import create_model_dict
from marker.output import text_from_rendered
converter = PdfConverter(artifact_dict=create_model_dict())
md, _, _ = text_from_rendered(converter("report.pdf"))在 CPU 上,marker 2.0 還需要 llama.cpp 的 llama-server 執行檔,要照它的 README 另外安裝;第一次啟動時,它在我們的電腦上下載了約 1.8 GB 的模型檔。前兩次我們都失敗了:一次是 torch 和 torchvision 版本對不上,一次是少了 llama-server。這些是安裝問題,不是函式庫的 bug,但記得多留點時間。
速度與 token 數
| 函式庫 | 英文指南(5 頁) | 中文報告(11 頁) | 頁首重複的英文報告(4 頁) | token,中文報告 |
|---|---|---|---|---|
| pymupdf4llm | 0.693 秒 | 1.419 秒 | 0.387 秒 | 8908 |
| pdfplumber | 0.713 秒 | 3.579 秒 | 0.023 秒 | 8782 |
| marker(預設) | 3.354 秒 | 4.563 秒 | 2.325 秒 | 10001 |
| marker(--disable_ocr) | 1.425 秒 | 3.146 秒 | 0.447 秒 | 10001 |
pymupdf4llm vs pdfplumber vs marker 差最多的就是速度。pdfplumber 在短報告上最快(0.023 秒),但碰到中文報告,卻是兩個輕量工具中最慢的。pymupdf4llm 表現穩定,每頁約 0.1 到 0.14 秒。就算模型已經載入,marker 處理英文指南還是比 pymupdf4llm 慢了 5 倍;加上 --disable_ocr 之後差距有縮小。
兩個輕量函式庫的 token 數很接近。marker 在中文報告上多了大約 12% 的 token,一部分是 <sup> 標籤和多出來的空白;短報告反而比較少,因為它把重複的頁首刪了。
標題與頁面雜訊
| 函式庫 | 英文指南(13) | 中文報告(29) | 頁首重複的英文報告(4) |
|---|---|---|---|
| pymupdf4llm | 13(層級正確 13) | 29(層級正確 29) | 4(層級正確 4) |
| pdfplumber | 0(層級正確 0) | 0(層級正確 0) | 0(層級正確 0) |
| marker(預設) | 11(層級正確 4) | 23(層級正確 14) | 4(層級正確 3) |
| marker(--disable_ocr) | 11(層級正確 4) | 23(層級正確 14) | 4(層級正確 3) |
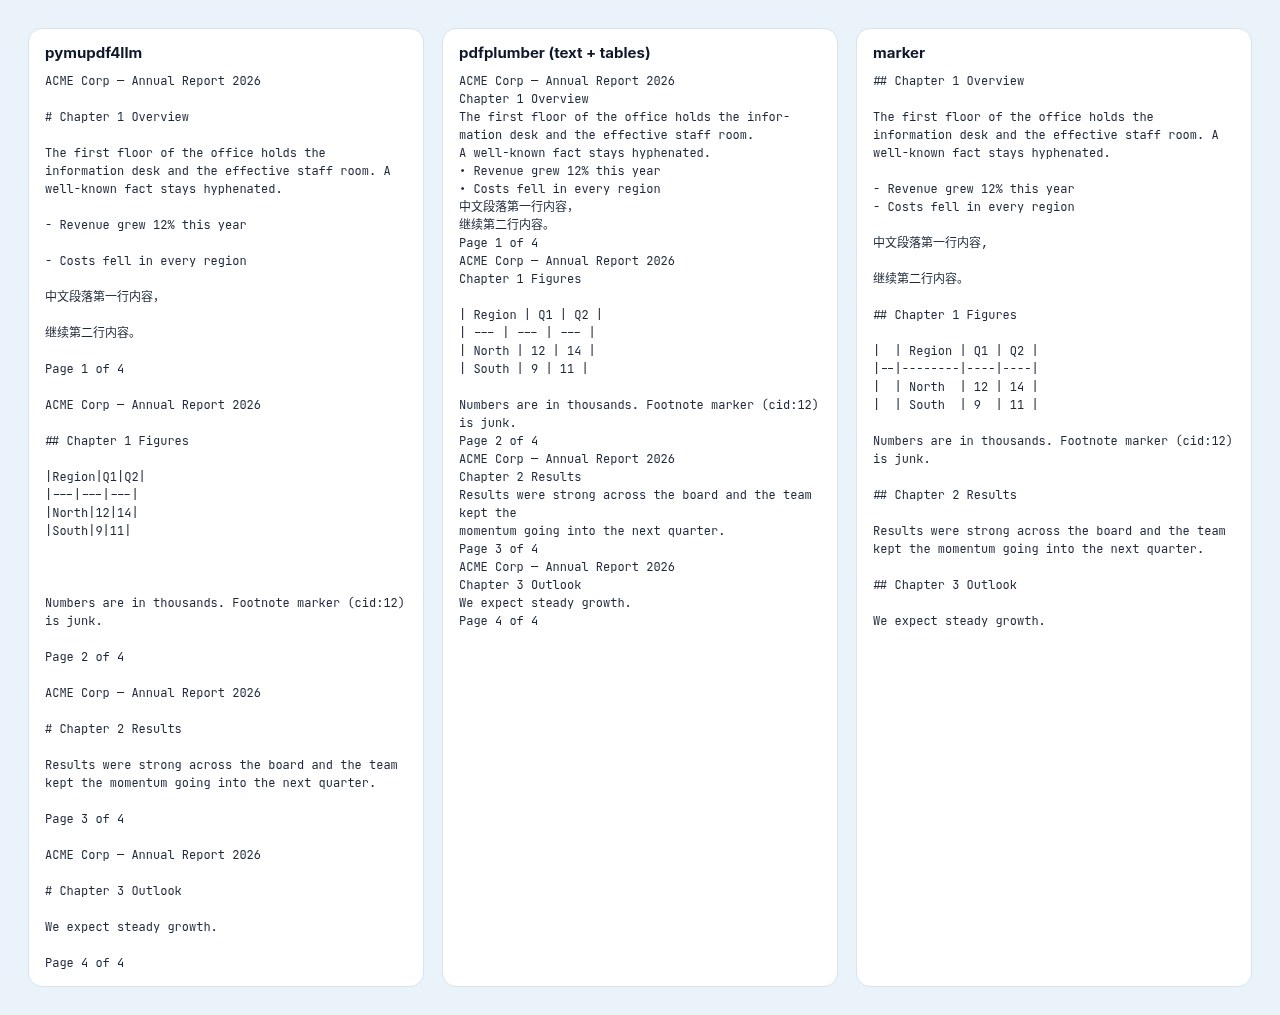
第二個大差異是標題。pymupdf4llm 每個標題都找到了,層級也都對。它還把指南裡粗體的 FAQ 問題標成標題(6 行),有時候這樣反而方便。pdfplumber 沒有標題的概念,給你的是一整片純文字。marker 大部分標題都有抓到,但層級常常是錯的。
在 4 頁的報告中,pymupdf4llm 和 pdfplumber 把 4 份重複頁首和 4 個頁碼全都留著,marker 則兩樣都刪了。這是 pymupdf4llm vs marker 最清楚的差別:marker 的版面模型知道什麼是頁首,輕量函式庫不知道。pdfplumber 還在某一行行尾留下一個被斷開的單字。
表格:有框線、無框線、合併儲存格
| 範例 | pymupdf4llm | pdfplumber | marker |
|---|---|---|---|
| 有框線表格 | 完全正確 | 完全正確 | 完全正確 |
| Office 匯出 | 儲存格 81% | 完全正確 | 儲存格 94% |
| 無框線表格 | 儲存格 40% | 沒找到 | 儲存格 90% |
| 多行儲存格 | 完全正確 | 完全正確 | 儲存格 83% |
| 無框線、多行 | 沒找到 | 沒找到 | 儲存格 83% |
| Office、無框線 | 沒找到 | 沒找到 | 沒找到 |
| 內文中的表格 | 完全正確 | 沒找到 | 完全正確 |
| 兩個表格 | 完全正確 | 儲存格 33% | 完全正確 |
| 合併儲存格 | 儲存格 83% | 完全正確 | 儲存格 42% |
表格的排名,要看 PDF 裡有沒有畫線。pdfplumber 的 find_tables() 是沿著線條找表格,所以只要 PDF 畫了格線,連合併儲存格都能完全正確;沒有線就什麼都找不到。pymupdf4llm 在多數有框線表格上完全正確,但有個 Office 表格的儲存格裡有沒跳脫的 |,結果被它拆壞了。marker 找到了兩個簡單的無框線範例,儲存格正確率 83% 到 90%;pymupdf4llm 只找到一個、正確率 40%,pdfplumber 一個也沒有。不過在合併儲存格範例中,marker 把好幾欄併在一起了。
Office 匯出的無框線表格,三個函式庫都沒認出來。如果你最在意表格,我們的 PDF 表格轉換教學 說明了為什麼無框線版面對任何工具來說都很難。
中文文字:字元保留、空白、標點
| 函式庫 | 中文字元保留率 | 句中空白 | 句中換行 | 全形逗號保留率 |
|---|---|---|---|---|
| pymupdf4llm | 100% | 159 | 0 | 100% |
| pdfplumber | 100% | 0 | 140 | 100% |
| marker(預設) | 98.6% | 166 | 0 | 0% |
換成中文,排名又不一樣了。原始 PDF 的句子裡沒有任何空白。pymupdf4llm 每個字、每個全形逗號都保留了,卻在句子裡塞了 159 個空白。pdfplumber 也保住了字元,但在句子中間留下 140 處換行。marker 掉了 1.4% 的字,連幾個小節標題都不見了,還把全形逗號全換成半形逗號,另外加了 152 個 <sup> 標籤。在我們的測試裡,中文 PDF 經過 marker 轉換後,要手動修的地方最多。
授權:AGPL、MIT、Apache,還有模型條款
- pdfplumber:依它的 LICENSE 檔案,採 MIT 授權。只要保留授權聲明,閉源或商業程式碼都能用。
- pymupdf4llm 與 PyMuPDF:儲存庫附的是 GNU AGPL 3.0,套件中繼資料寫著 "Dual Licensed - GNU AFFERO GPL 3.0 or Artifex Commercial License"。簡單講:如果你散布用到它的程式,或透過網路讓使用者使用修改過的版本,AGPL 要求你用同樣的授權公開那支程式的原始碼,除非你向 Artifex 買商業授權。
- marker:程式碼是 Apache-2.0,但模型權重用的是修改過的 AI Pubs Open RAIL-M 授權。依 MODEL_LICENSE,研究、個人使用,以及總營收或募資低於 500 萬美元的組織可免費使用權重;超過的話要向 Datalab 取得授權。
如果授權是關鍵,對多數商業團隊來說,兩個輕量函式庫真正的選擇就是 AGPL 還是 MIT,而 marker 還多一道營收門檻。以上只是整理,不是法律意見,上線前請自己把授權檔案讀過一遍。
資料來源
- PyMuPDF4LLM documentation — Artifex
- pymupdf4llm repository and licence — GitHub
- pdfplumber README and LICENSE.txt — GitHub
- marker README, LICENSE and MODEL_LICENSE — GitHub (Datalab)
- GNU Affero General Public License v3.0 — Free Software Foundation
- tiktoken — GitHub (OpenAI)
常見問題
pymupdf4llm vs pdfplumber vs marker,哪個最好?
在我們的測試中,一般文件和中文內容用 pymupdf4llm,要在 MIT 授權下精準擷取有框線表格用 pdfplumber,無框線表格和頁首重複的頁面用 marker。
pymupdf4llm 可以免費商用嗎?
在 AGPL 下可以,但散布程式或以服務形式提供時,也要公開你的原始碼。如果做不到,Artifex 有販售商業授權。
marker 一定要有 GPU 嗎?
不用。它在我們沒有 GPU 的 8 vCPU 電腦上能跑,但需要 llama.cpp 的 llama-server,而且比輕量函式庫慢好幾倍。
pdfplumber 能直接輸出 Markdown 嗎?
不行。它回傳的是文字、單字、線條和表格,Markdown 要自己組,就像我們這次測試的做法。
掃描的 PDF 要用哪個函式庫?
marker 是圍繞 OCR 模型打造的。pymupdf4llm 和 pdfplumber 預設只讀文字層,所以掃描檔會是空白。
我可以自己重跑這個測試嗎?
可以。腳本、版本和硬體都列在上面;換一台電腦耗時會不同,但品質結果應該一樣。